「史上最大の窃盗」 Microsoft幹部が92ページに書いた
NYタイムズがOpenAIとMicrosoftを訴えた裁判で9月18日に92ページの内部文書が開示されました。2社の社内資料や幹部の発言をまとめたもので、AI開発がウェブに与える害を当事者が認識していたことを示しています。
Microsoftの応用科学ディレクターBrent Hechtは、ChatGPTやCopilotのデータ収集を「史上最大の労働の窃盗」と呼んでいます。自社のフェアユースの主張については「完全な茶番」と書いていました。
社内の別の文書には「我々のAIコンテンツ戦略はウェブを傷つける破滅の循環を始めた」との記述もあります。完成品が材料の供給元を壊す構図はほとんど例がないと自ら認めています。
- 9/1892ページの内部文書が開示されThe Vergeが報道
Microsoftの弁明 「個人の見解」だが発言者は1人ではない
Microsoft広報のAlex Haurekは「1人の社員の個人的な見解であり法的分析ではない」と返しました。AIデータ戦略担当GMのJordan Usdanも裁判所への文書でHechtを「対立的な視点を持ち込む役割」と説明しています。
ただし92ページにはほかの幹部の発言も残っています。CEOのSatya Nadellaはチャットボットが検索を置き換えたと認めています。OpenAI共同創業者のGreg Brockmanは商用化で得られる「何兆ドル」の利益に言及していました。OpenAIのChatGPT責任者(Nick Turleyとみられる)も出版社への「存亡の脅威」を認める発言が引用されています。個人の見解で片づけるには声が多すぎます。
ChatGPTの回答品質が落ちる 「破滅の循環」はもう始まった
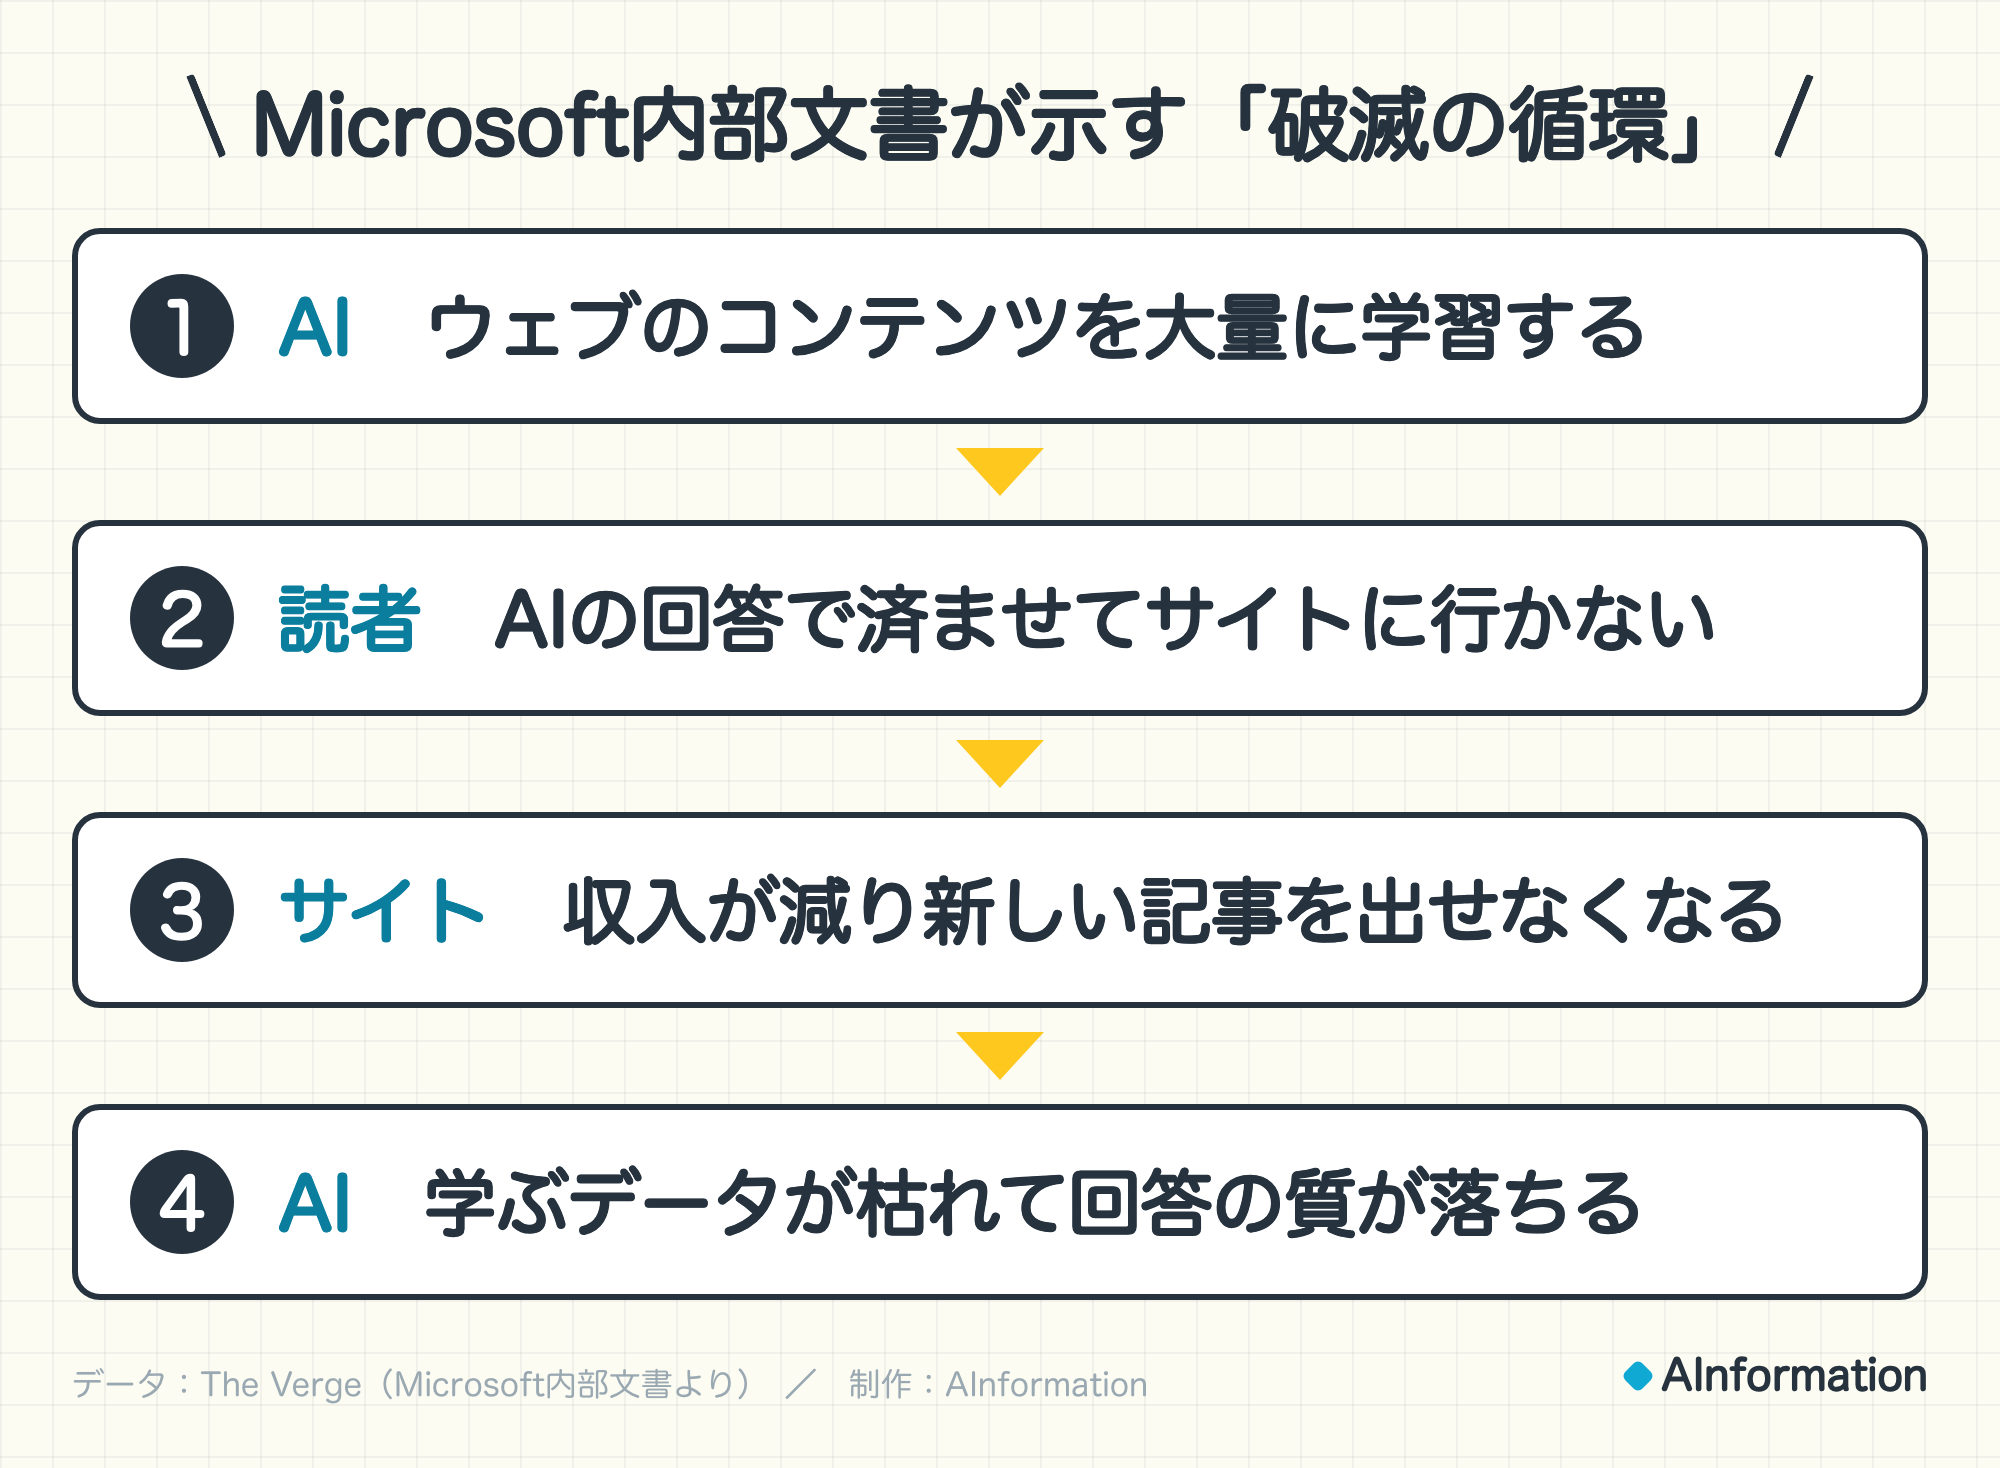
内部文書が警告する「破滅の循環」はこういう流れです。まずAIがウェブのコンテンツを大量に吸い上げます。読者はAIの回答で済ませて元のサイトを訪れなくなります。サイトの広告収入が減り、新しい記事や調査が出なくなります。するとAIが学ぶデータが枯れて回答の質が落ちます。この循環が止まらない構図です。
文書は「完成品が不可欠な供給元の経済基盤を脅かすのはほとんど例がない状況だが、我々のLLM事業はそれを作り出した」と書いています。2社はそれを知りながら進めたとThe Vergeは指摘しています。
The Vergeはこの現象を「Google Zero」とも呼んでいます。AIが検索の代わりになった結果、元のサイトへの流入がゼロに近づく状態です。ChatGPTの利用者にとっても他人事ではありません。学習データの質が落ちれば回答の正確さも下がります。
92ページの文書に残っていた発言
| 発言者 | 肩書き | 発言の要旨 |
|---|---|---|
| Brent Hecht | Microsoft応用科学ディレクター | 「史上最大の労働の窃盗」「フェアユースの茶番」 |
| Satya Nadella | Microsoft CEO | チャットボットが検索を置き換えた |
| Greg Brockman | OpenAI共同創業者 | 商用化で「何兆ドル」の利益を得られる |
| ChatGPT責任者 | OpenAI | 出版社への「存亡の脅威」を認識 |
ChatGPTのAI学習設定 今確かめるべきは2つだ
自分のデータがAI学習に使われているか確かめるには2つの設定を見ます。1つ目はChatGPTの「設定>データ管理>モデルの改善」です。オンになっていると会話の内容がモデルの学習に使われます。オフにすれば学習への利用を止められます。
2つ目はウェブサイトを運営している場合です。robots.txtにGPTBotを許可する記述がないか確認します。OpenAIはオプトアウトの手段を公開していますが、裁判文書が示すように学習データの扱い自体が法廷で争われています。裁判の結論しだいでルールが変わる可能性もあります。設定を見直すなら今が区切りです。
- フェアユース
- 米国著作権法の例外規定。他人の著作物を許可なく使えるかどうかを利用の目的や市場への影響から判断する。日本の引用とは範囲が異なる
- robots.txt
- ウェブサイトのルートに置くファイル。検索エンジンやAIのクローラーにどのページを読んでよいかを指示する
92ページの内部文書が示すのは「知っていてやった」という事実だ。Microsoft自身がAI学習を窃盗と認め破滅の循環を警告する文書を持っていた。それでも止めなかったのは商用化の利益がリスクを上回ると判断したからだろう。フェアユースの議論はこれまで「AIにはウェブが必要だから許される」という前提で進んできたが、当事者がその前提を社内で否定していた。裁判の結論しだいでAI学習のルールが変わる可能性がある。設定の見直しは今のうちに済ませておきたい。
- AIの学習にウェブのデータを使うのは違法なのか
- 現時点では判決が出ていません。OpenAIとMicrosoftはフェアユースを根拠に合法だと主張していますが、NYタイムズは著作権侵害だとして提訴しています。今回の内部文書ではMicrosoft幹部自身がフェアユースの主張を「茶番」と呼んでおり、裁判の結論しだいでルールが大きく変わる可能性があります。
- ChatGPTの学習に自分のデータが使われないようにするには
- ChatGPTの「設定>データ管理>モデルの改善」をオフにすると会話内容が学習に使われなくなります。ウェブサイトを持っている場合はrobots.txtでGPTBotのクロールを禁止できます。OpenAIの公式サイトに対象のクローラー名と設定方法が載っています。ただしすでに学習済みのデータを取り消す手段は今のところありません。
この記事の出典
補助資料
- [1]The Vergeこの記事の元にした報道
出典の最終確認日:2026年9月19日