Devin開発元が発表 高いAIに見せて安いAIに書かせる
AIエージェント「Devin」を開発するCognitionが、AIコーディングの費用を最大39%削減するハーネス「Fusion」を発表しました。Devin DesktopとCLIで利用できます。
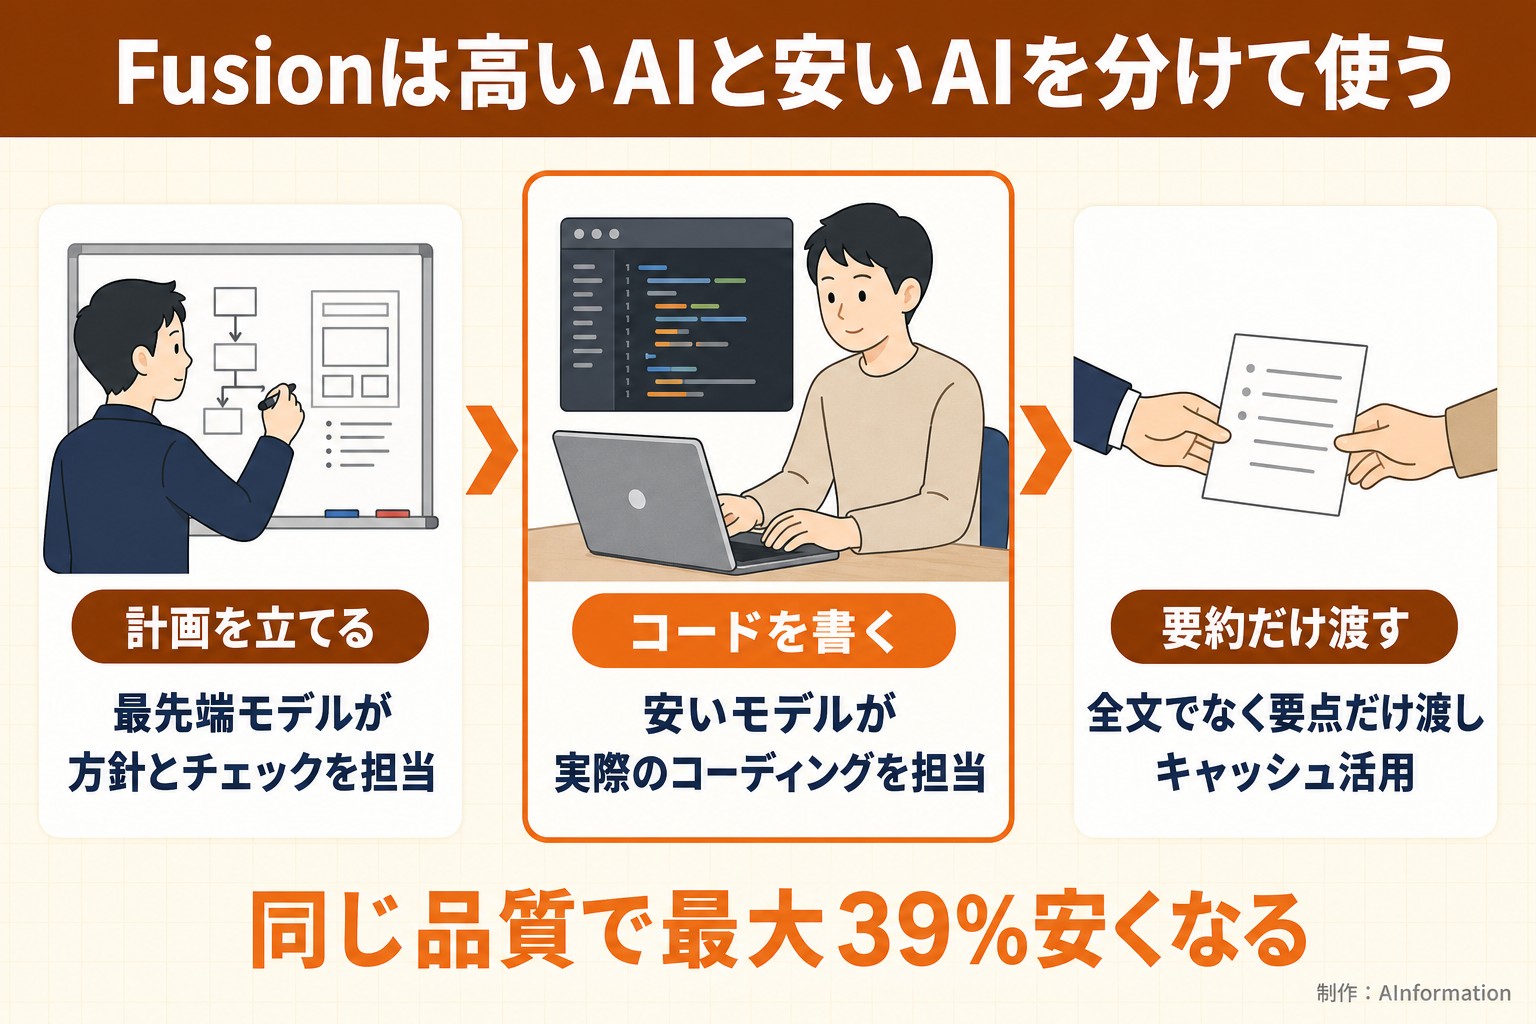
AIモデルにツール使用のルールや処理手順を指示する仕組みがハーネスです。ハーネスの種類で性能は大きく変わります。Fusionは「計画とレビューを担当する最先端モデル」と「コードの実行を担当する安いモデル」を組み合わせた形になっています。
GPT-6 AstraやClaude Fableが計画側に入り、Cognitionが9月11日に発表したコーディングモデルSWE-2が実行側を受け持ちます。2つのAIはそれぞれ独立したコンテキストで動き、やり取りには要約と結果だけを渡す仕組みです。会話の全文を共有しないためプロンプトキャッシュが効きやすくなり、高性能モデルに全部やらせるより安くなります。
- 9/11CognitionがコーディングモデルSWE-2を発表
- 9/14Fusionを発表しDevin DesktopとCLIで提供開始
Claude Codeと同じスコアでコストが最大39%下がった
Fusionの品質は既存のハーネスと同等で、コストだけが下がります。
Claude Fable 5.1とClaude Codeの組み合わせではスコアが62.2でした。同じClaude Fable 5.1をFusion(SWE-2と組み合わせ)に切り替えるとスコアは61.7になり、コストが36%下がりました。GPT-6 Astraでも同じ傾向で、FusionはCodexと同等のスコアを出しつつコストを39%削減しています。
AI分析企業のArtificial AnalysisとVals AIによる独立した評価でも、最先端レベルの性能を保ちながらコスト削減を実現していることが確認されています。
ハーネスごとのスコアとコスト比較
| 組み合わせ | スコア | コスト |
|---|---|---|
| Claude Fable+Claude Code | 62.2 | 基準 |
| Claude Fable+Fusion | 61.7 | 36%安い |
| GPT-6 Astra+Codex | 非公開 | 基準 |
| GPT-6 Astra+Fusion | Codexと同等 | 39%安い |
Claude Codeの費用がネック 39%減で手が届く案件が出る
AIコーディングツールの費用は、導入を検討する企業にとって判断材料の1つです。Claude CodeやCodexを開発チーム全体で使うとトークンの消費が重なります。Fusionが同じ品質で36〜39%安くなることを示したのは大きな進展です。
コスト以外の利点もあります。最先端モデルが処理を全部抱えると思考ループに陥ることがありますが、Fusionでは計画と実行を分離しているため安定しやすいとCognitionは説明しています。
Devinから使える Claude Fable 5.1が最も合う
FusionはDevin DesktopとCLIから使えます。Cognitionは最先端モデルにGPT-6 AstraかClaude Fableを選び、実行モデルにSWE-2を組み合わせるよう案内しています。とくにClaude Fable 5.1との組み合わせがもっとも良い結果を出しました。
AIコーディングの費用が気になっているチームは、まずDevinの環境でFusionを試すのが早いです。ベンチマークと実務では条件が違うため、自社のコードで品質とコストの変化を確かめておきたいところです。
- ハーネス
- AIモデルにツール使用のルールや処理手順を指示して性能を引き出す周辺の仕組み。馬具が馬を制御するたとえから付いた名前
AIコーディングツールの費用を気にして導入を見送っていた企業には選択肢が増えた。「高いモデルに全部やらせる」のではなく「高いモデルが計画を立てて安いモデルが書く」という分業は、コードに限らずAIの使い方全般に広がる考え方だ。ただしFusionはDevinの環境が前提になる。自社の開発チームにDevinを入れるかどうかの判断が先に来る。
- Fusionはどのモデルの組み合わせがいちばんよいのか
- Cognitionによると、Claude Fable 5.1との組み合わせがもっとも良い結果を出しました。スコア61.7でClaude Codeの62.2とほぼ同じになり、コストは36%下がります。GPT-6 Astraでも効果があり、Codexと同等のスコアでコストが39%減ります。実行側のモデルはCognitionが9月11日に発表したSWE-2を使います。
- なぜ2つのAIを使うとコストが下がるのか
- Fusionは計画を立てるAIと実行するAIを別のコンテキストで並行して動かし、やり取りには要約と結果だけを渡します。全文を渡さないのでプロンプトキャッシュが効きやすくなります。高性能モデルに計画からコーディングまで全部やらせるより、安いモデルに実行を任せたほうがトークンの消費が抑えられます。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年9月15日