ThinkingBoxはDBの中身で採点する 20回ずつ解かせる
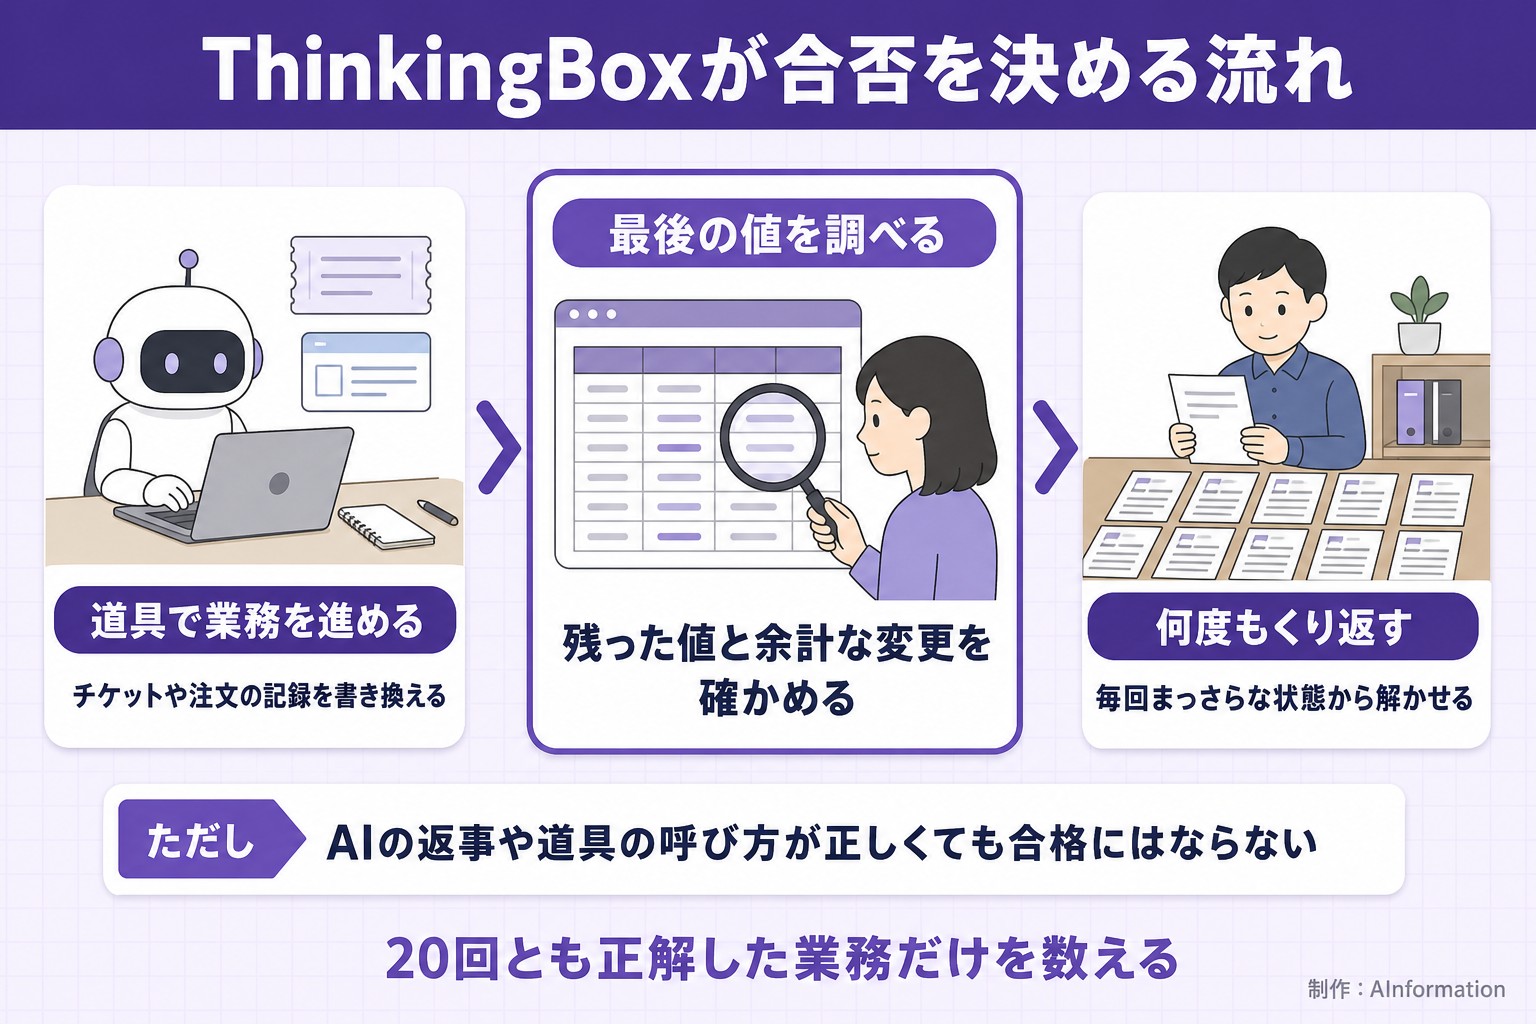
Microsoftは10月3日、AIエージェントを評価する仕組み「ThinkingBox」をHugging Faceで公開しました。採点に使うのはAIの返事や道具の呼び方ではなく、作業のあとにデータベースへ残った値です。小売・自動車保険・旅行・ネット銀行・コンサルの5分野で507の業務を用意し、同じ業務を20回ずつまっさらな状態から解かせます。
発表で挙げた例は、配送業者の「例外」のまま予定日を15日過ぎた家電の問い合わせです。AIは注文や追跡を9回の道具の呼び出しで正しく調べたのに、最後にチケットを「解決済み」で閉じました。業者の調査が終わっていないので、正しい終わり方は「保留」でした。
これは珍しい失敗ではありません。12モデルの有効な121,680回の試行のうち79,853回が採点で失敗し、その67.24%はエラーを出さずに作業を終えていました。エラーなしで終えた失敗を調べると、77.61%で値が間違い、43.30%で頼んでいない変更が入っていました。
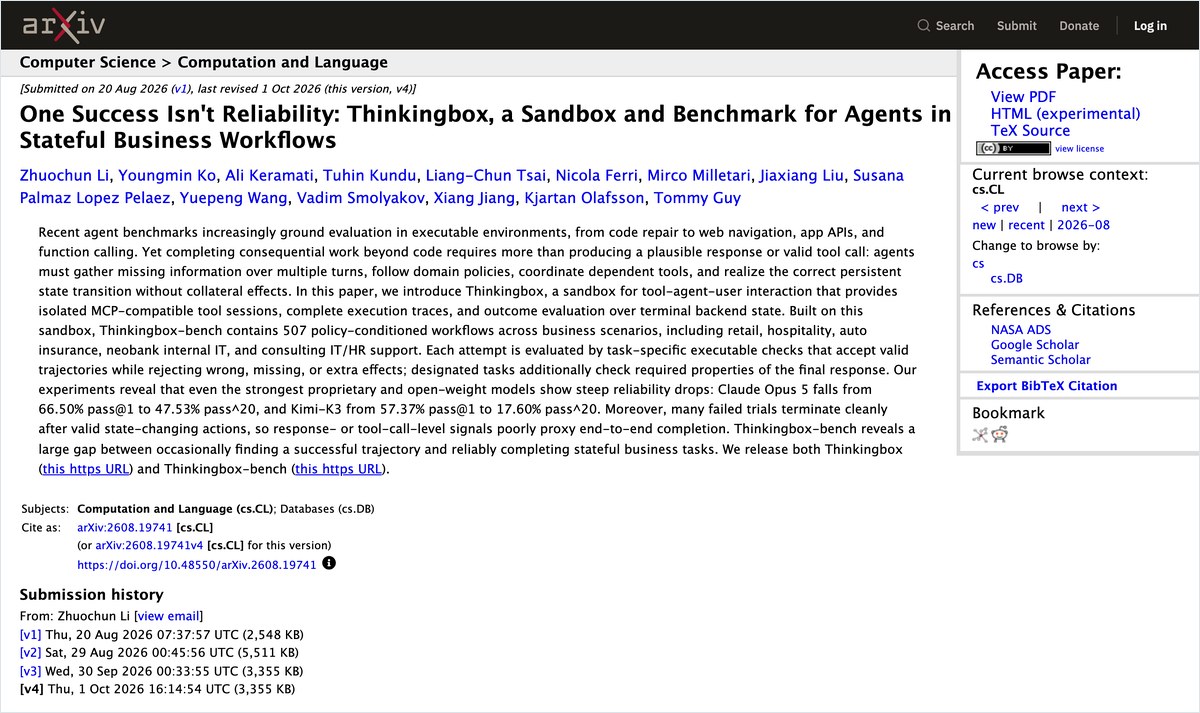
- 8/20ThinkingBoxの論文を公開
- 9/20費用の計算に使うOpenRouterの料金を取得
- 10/3MicrosoftとHugging Faceが公開を発表
Claude Opus 5.5が首位 20回とも正解は47.53%
1回あたりの正解率(pass@1)で首位はClaude Opus 5.5の67.16%で、Claude Opus 5が66.50%で2位です。GPT-5.4は65.36%で、GPT-6 Astraは58.31%です。Grok-4.3は14.38%にとどまり、公開した18モデルの表にGeminiは入っていません。
差が大きく出たのは、20回とも正解できた業務の数です。Claude Opus 5.5とOpus 5は507業務中241(47.53%)で、どのモデルも5割に届きませんでした。GPT-6 Astraは231(45.56%)です。ただし1回の正解率の78%を20回通しても保てており、Opusの2つの71%を上回りました。
GLM-5.1・Kimi-K2.6・DeepSeek-V4-Proは、1回の正解率の約8%しか残りませんでした。Kimi-K3は507業務のうち476を1回以上解いたのに、20回とも正解できたのは68業務(13.41%)だけです。新しいOpus 5.5も、20回とも正解の数はOpus 5と同じ241で増えていません。
20回とも正しい業務1件に1,072円から 安い順は入れ替わる
ThinkingBoxは費用も比べています。料金は9月20日時点のOpenRouterの定価で、Opus 5.5だけAnthropicの公式の料金を使っています。1回正解するのにかかった額はGPT-5.6 Solの0.127ドルが最も安く、Claude Opus 5.5は0.276ドルでした。
AInformationが1ドル157.67円(欧州中央銀行の10月2日の値)で円に直しました。20回とも正解できた業務1件あたりでは、GPT-5.4の6.80ドル(1,072円)が最も安くなります。GPT-6 Astraは7.45ドル(1,175円)で、Claude Opus 5.5は7.80ドル(1,230円)でした。ただしGPT-5.4は128業務(25.25%)しか20回とも正解できていません。
1回あたり最安だったGPT-5.6 Solは、20回とも正解の82業務(16.17%)で割ると9.76ドル(1,539円)に上がります。Claude Opus 5は13.30ドル(2,097円)で、Kimi-K3は20.68ドル(3,261円)でした。どれも見積もりで、実際の請求額ではないと断っています。
20回とも正解した業務と1件あたりの費用
| モデル | 20回とも正解した業務 | 1件あたりの費用 | 円にすると |
|---|---|---|---|
| GPT-5.4 | 128(25.25%) | 6.80ドル | 1,072円 |
| GPT-6 Astra | 231(45.56%) | 7.45ドル | 1,175円 |
| Claude Opus 5.5 | 241(47.53%) | 7.80ドル | 1,230円 |
| GPT-5.6 Sol | 82(16.17%) | 9.76ドル | 1,539円 |
| Claude Opus 5 | 241(47.53%) | 13.30ドル | 2,097円 |
| Kimi-K3 | 68(13.41%) | 20.68ドル | 3,261円 |
日本語で同じ場面を60回試すと 4モデルとも保留で残した
AInformationは10月4日に、発表の例をまねた日本語の場面を作りました。GPT-6 Astra・GPT-6.1 Sol・GPT-6 Luna・Gemini 3.8 Flashの4つへ、APIで投げています。道具は注文・追跡・会員・対応ルール・チケットを扱う模擬の7つです。条件は「ルールがすぐ見つかる」「チケット更新の1回目がエラー」「状態のルールが見つけにくい」の3通りで、各5回ずつ流しました。
結果は60回すべてでチケットを「保留」にして終わり、誤って「解決済み」にした回は0回でした。エラーの条件では4モデルとも更新をやり直し、2回目で保留にしています。Gemini 3.8 Flashは対応ルールを最大8回調べ直し、1回の時間は中央値12.9秒と4つの中で最も短い結果でした。
試したのは模擬の道具で作った1つの場面で、各モデル各条件5回ずつです。Claudeは今回のAPIの試験に入れていません。この結果からThinkingBoxの507業務で同じ成績が出るとは言えません。
短い1つの場面では差が出ませんでした。ThinkingBoxでも小売の業務は平均59.52%と易しく、自動車保険は33.83%まで下がります。自社の試験を数回の成功で終わらせると、こうした分野ごとの崩れを見落とします。
本番の前に見るのはAIの報告より最後の値 Linuxで動かせる
失敗の内訳は道具の扱いが79.9%で最も多く、状態の更新の誤りが10.3%で続きます。お客さまの用件を解決しきれなかった失敗は7.0%でした。Microsoftはエラーや空の検索結果から立ち直れないことが主な原因だとみて、次の4つを勧めています。
- 確定の前にシステムに残った最後の値を確かめる
- エラーを分けて直せるものだけやり直す
- 道具を業務に要るものだけに絞る
- 取り消しにくい変更は人の承認を通す
4つの効き目はまだこの試験で測っていないと、Microsoft自身が書いています。論文は8月20日に出ていました。
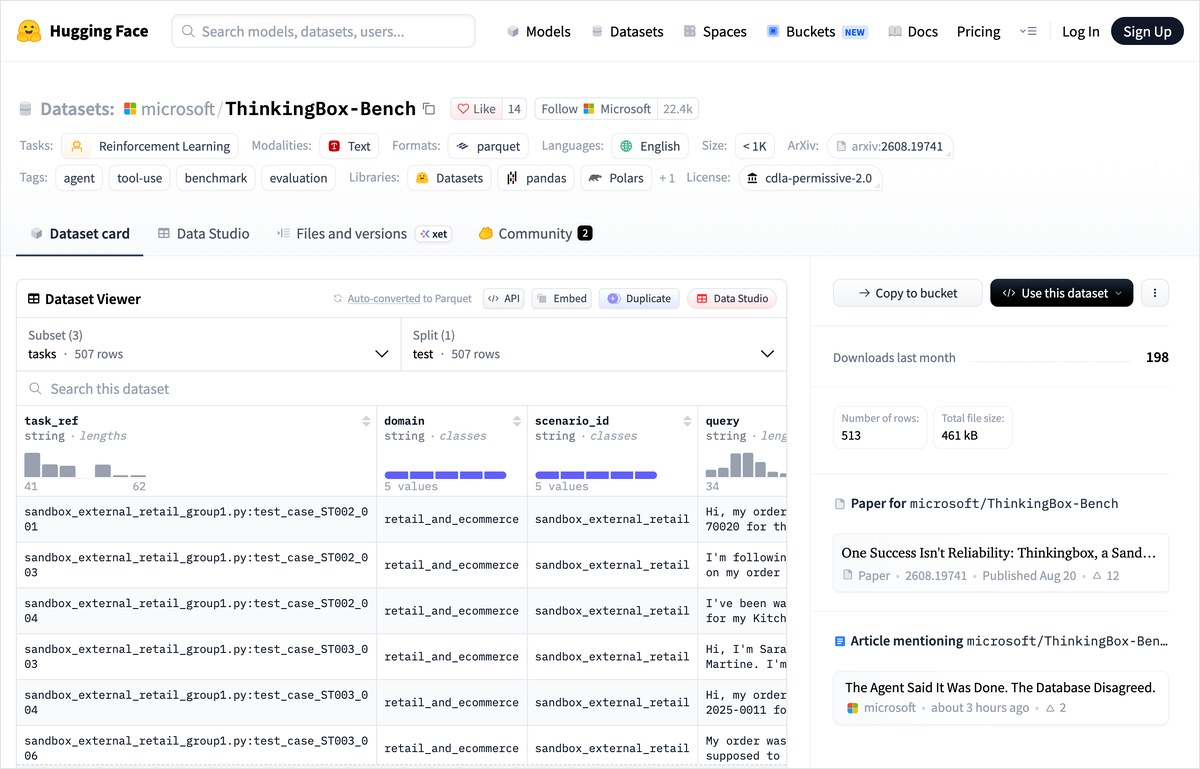
自分で動かすには、LinuxかWSLにPython 3.11以上・uv・Dockerを入れてOpenEnvから業務を呼び出します。AIの役のほかにお客さま役と採点役のモデルも要るので、APIの利用料は別にかかります。コードはMITライセンスで、ベンチマークのデータはCDLA-Permissive-2.0です。
Macで動くかは書かれていません。まずは自社の業務を1つ選び、AIが残した記録を20回分並べて見ることから始められます。
- pass@1
- 1回解かせたときに正解する割合。ThinkingBoxでは20回分の試行の平均で、よくある順位表の数字にあたる
社内でAIエージェントを試すとき、多くの会社は数回動かして「できた」と判断します。ThinkingBoxの数字は、その数回の成功があてにならないことを示しています。問い合わせ対応や顧客管理のように記録を書き換える仕事では、AIの報告ではなくシステムに残った値を毎回確かめる仕組みを導入の前に作っておきたいところです。AInformationの日本語の再現は60回とも正しく終わりましたが、短い手順で通っても長い手順で崩れるのが今回の結果です。試験は自社の実際の手順の長さで組むのが近道だとみています。
- ThinkingBoxは無料で使える?
- ThinkingBoxのコードはMITライセンス、ベンチマークのデータはCDLA-Permissive-2.0で公開されていて無料で入手できます。ただし動かすにはAIの役・お客さま役・採点役のモデルが要り、そのAPIの利用料は別にかかります。動作を確かめた環境はLinuxとWSLで、Python 3.11以上とuvとDockerが必要です。
- AIエージェントに向いているモデルはどれ?
- ThinkingBoxで20回とも正解できた業務が最も多かったのはClaude Opus 5.5とClaude Opus 5で、507業務中241でした。GPT-6 Astraは231と少し下ですが、1回の正解率の78%を20回通しても保てた点で最も安定していました。費用まで含めると、GPT-6 Astraの1件7.45ドルがOpus 5.5の7.80ドルを下回ります。
- ThinkingBoxの順位表にGeminiは入っている?
- ThinkingBoxが公開した18モデルの表にGeminiは入っていません。AInformationが10月4日に日本語の1場面でGemini 3.8 Flashを15回試したところ、15回ともチケットを正しく保留にしました。ただし短い1場面の結果なので、507業務の成績とは並べられません。
- 1回のテストで合格したAIエージェントは本番で使える?
- 1回の合格だけでは足りません。ThinkingBoxではKimi-K3が507業務中476を1回以上解いた一方で、20回とも正解できたのは68業務の13.41%でした。本番で記録を書き換える仕事に使うなら、同じ業務を何度も流して毎回の結果を数えておく必要があります。
この記事の出典
補助資料
- [1]Hugging Faceこの記事の元にした報道
出典の最終確認日:2026年10月4日