Magnitudeが公開 Macの生成は毎秒57トークンだ
オープンモデルを自分のPCで動かす推論エンジン「Magnitude」が、オープンソースで公開されました。M4 Proと48GBメモリのMacでは、生成速度が毎秒57トークンでした。同じ条件のllama.cppは毎秒30トークンです。
測った条件は、4bitに量子化した「Qwen 3.6 35B A3B」を64Kトークンの文脈長で動かしたものです。数字は開発チームが出したもので、AInformationが測った値ではありません。ライセンスはApache License 2.0で、対応OSはmacOSとWindowsとLinuxの3つです。
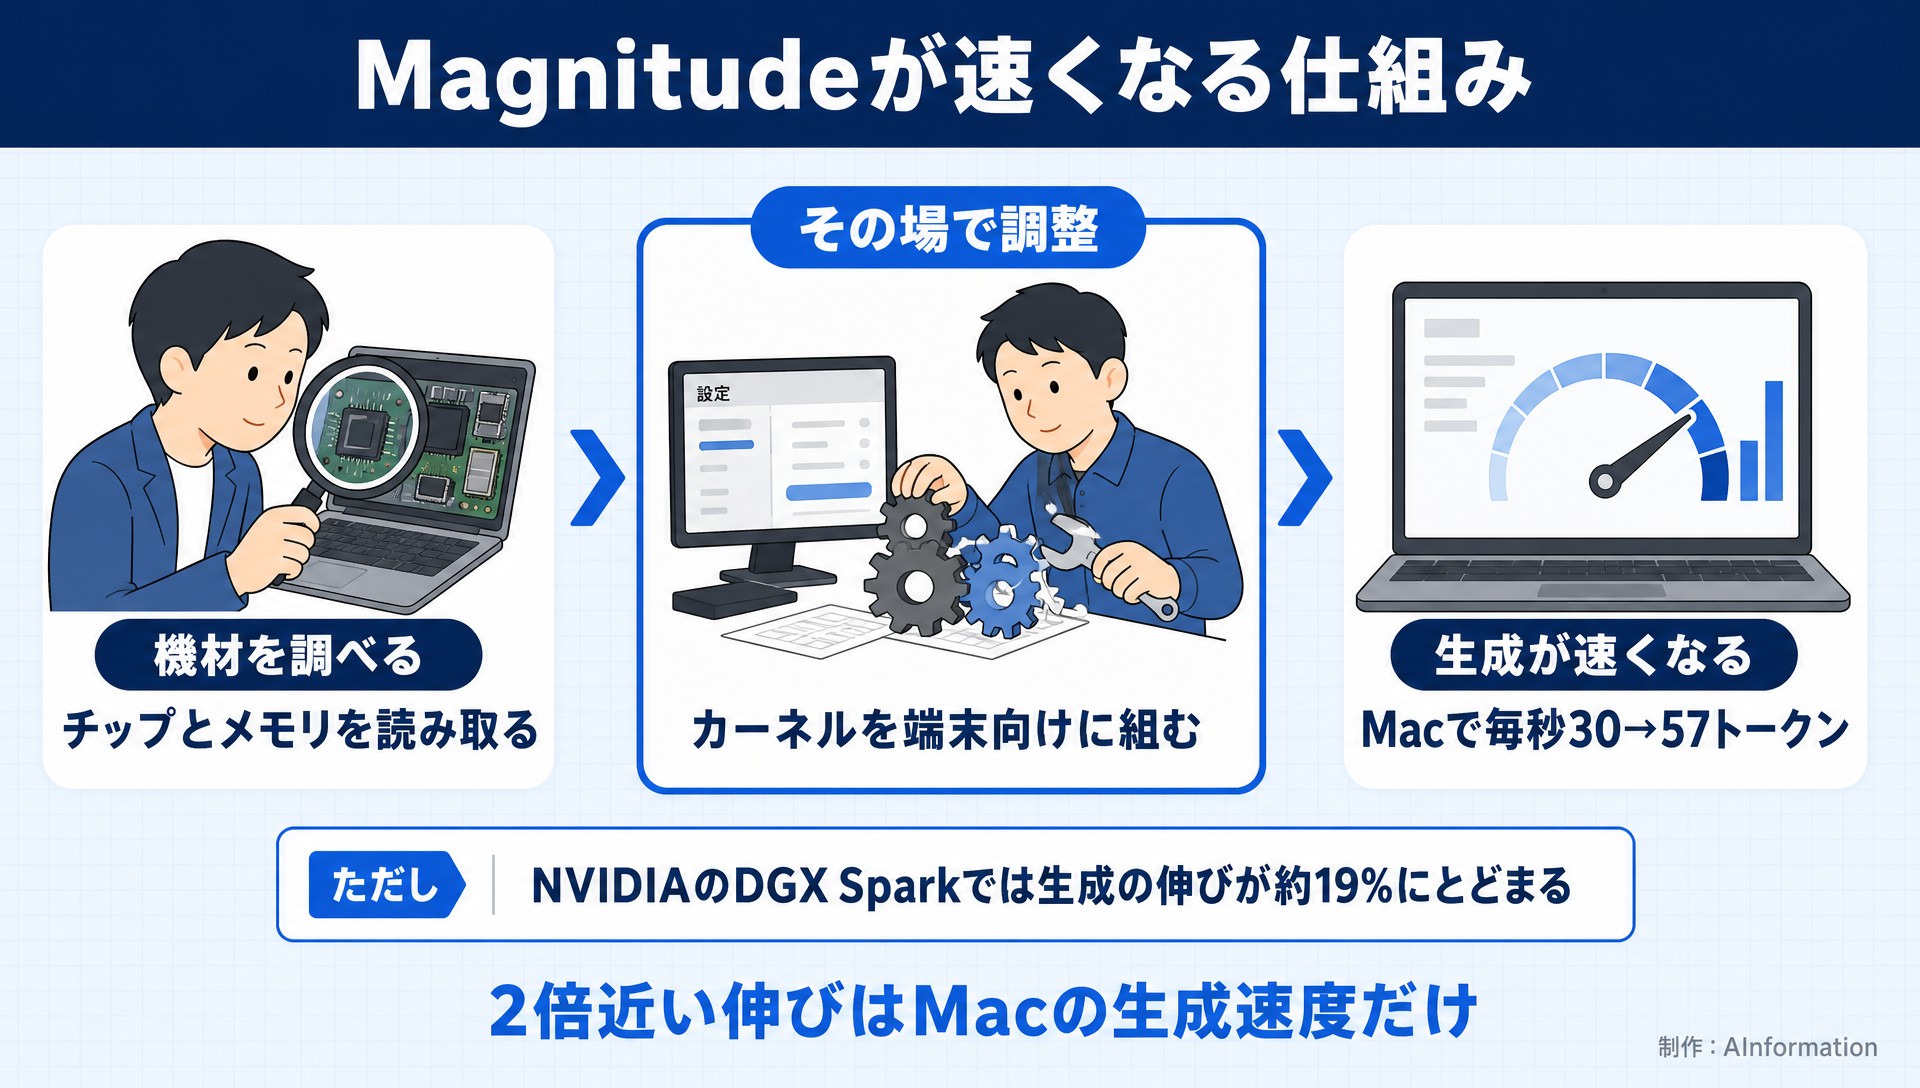
速さの理由は、モデルを動かす端末の上で処理を組み直す作りにあります。AIの計算を受け持つ小さな処理単位「カーネル」を、その機材に合わせてコンパイルし直します。同じAppleシリコンやNVIDIA製GPUでも、製品ごとに性能とメモリの構成が違うためです。
2倍近いのはMacの生成だけ NVIDIAでは約19%増だ
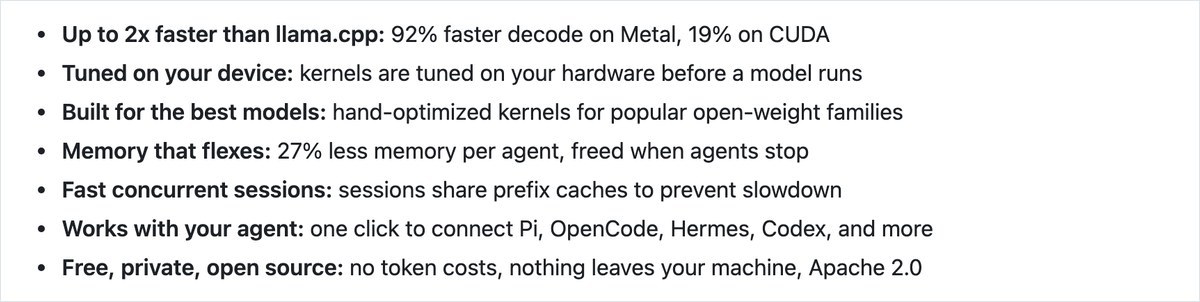
「llama.cppの最大2倍」という触れ込みが当てはまるのは、Macで文章を生成する速さだけです。NVIDIA DGX Sparkでは、生成速度が毎秒49トークンから58トークンへの約19%増にとどまりました。10月2日にGitHubのページを開くと、機能一覧にもMetalで92%とCUDAで19%が並べて書かれていました。
入力を読み込む速さ(プリフィル)では、差がさらに小さくなります。Macではllama.cppの毎秒466トークンに対して毎秒507トークンで、約9%の伸びでした。DGX Sparkでは毎秒2033トークンから2507トークンへ約23%伸びています。
メモリでは、両方の環境で目に見える差が出ています。エージェント1つ当たりの使用量はMetalで約28%、CUDAで約27%減りました。Magnitudeのほうがllama.cppを上回るのは確かですが、伸び幅は機材と処理の種類でばらつきが大きいです。
llama.cppとの速さの比較
| 測った項目 | llama.cpp | Magnitude | 伸び |
|---|---|---|---|
| Macの生成(Metal) | 毎秒30トークン | 毎秒57トークン | 約92%増 |
| Macのプリフィル | 毎秒466トークン | 毎秒507トークン | 約9%増 |
| DGX Sparkの生成(CUDA) | 毎秒49トークン | 毎秒58トークン | 約19%増 |
| DGX Sparkのプリフィル | 毎秒2033トークン | 毎秒2507トークン | 約23%増 |
| エージェント1つのメモリ | 比べる元 | Metal約28%減・CUDA約27%減 | 減った |
Claude Codeにもつなげる ファイルはPCの外に出ない
Magnitudeは、ふだん使っているAIエージェントのモデルを手元のオープンモデルに替える使い方を想定しています。モデルを選んでダウンロードしたあと、「Connections」の画面からClaude Code・Codex・Clineなどへつなげます。ほかのアプリからはOpenAI互換のAPIで呼び出せる作りです。
モデルは一度ダウンロードすれば、インターネットにつながなくても動きます。プロンプトとファイルはPCの中に残るという説明です。導入のときは搭載している機材を調べて、合うモデルを薦めてくれます。
AIエージェントはファイルの読み書きやコマンドの実行を繰り返すので、会話が長くなりがちです。Magnitudeは複数のセッションで共通する冒頭部分の計算結果を使い回す「プレフィックスキャッシュ」を共有します。セッションが長くなるにつれてメモリを足し、エージェントが止まると手放します。同じPCで別の作業を続けやすくする作りです。
開発チームは、llama.cppが幅広い機材への対応を重視してきたのに対し、手元でエージェントを長く動かすには別の調整が要ると考えました。社内のコードをクラウドのAIへ送れない開発チームにとっては、Macの生成が2倍近くになるだけでも試す理由になりそうです。
大きなモデルの読み込みは計画段階 試すならMacから
GPUメモリに収まらない大きなモデルを動かす工夫は、まだ計画の段階です。大規模モデルの「エキスパート」と呼ばれる一部のパラメーターをRAMやストレージに置き、必要なときに読み込む「Expert streaming」が予定に入っています。CPU・GPU・RAM・ストレージをまとめて使う最適化も、これから取り組むと書かれています。
メモリの少ないPCで大きなモデルを動かしたい人は、今の版を前提に機材を買うのは避けたほうがよさそうです。まずは手元のMacで、ふだん使っているモデルの速さをllama.cppと比べてみるのが早道です。開発チームの数字は64Kトークンの長い文脈で測ったものなので、短い会話では差の出方が変わる可能性があります。
Expert streamingが入れば、手元のPCで動かせるモデルの大きさそのものが変わってきます。
- カーネル
- AIモデルの計算を受け持つ小さな処理単位。Magnitudeは動かすPCに合わせてこれをコンパイルし直し、速さを引き上げる
- プレフィックスキャッシュ
- 複数のセッションで共通する冒頭部分の計算結果を使い回す仕組み。ツールの説明など毎回渡す文の処理を省ける
社内のソースコードをクラウドのAIに渡せない会社は、日本ではまだ多いとみています。Magnitudeは手元のMacで生成を2倍近くにします。Claude CodeやCodexにもつながるので、そうした開発チームが試す候補に入りそうです。一方でNVIDIAの機材では伸びが約19%にとどまり、GPUを積んでいない社用PCでの速さは発表の数字から読めません。情報システム部門は、社内PCに入れてよいモデルを先に決めておきたいところです。現場の判断で入れ始めてからでは、モデルごとのライセンスの確認が追いつかない可能性があります。
- Magnitudeは本当にllama.cppの2倍速い?
- 2倍近く速いのはMacで文章を生成する速さだけです。M4 Proと48GBメモリのMacでは毎秒30トークンから57トークンへ約92%伸びました。NVIDIA DGX Sparkの生成は毎秒49トークンから58トークンで約19%増です。入力の読み込みはMacで約9%増にとどまります。どれも開発チームの測定です。
- Magnitudeはどの機材で動く?
- Magnitudeは、AppleシリコンのMacとNVIDIA製・AMD製のGPUを積んだPCで動きます。GPUが無くCPUだけのPCでも使える作りです。OSはmacOS・Windows・Linuxに対応しています。ただし開発チームが速さを示したのはM4 ProのMacとNVIDIA DGX Sparkの2つだけです。CPUだけのPCでの速さは示されていません。
- Claude CodeでMagnitudeのモデルを使える?
- 使えます。Magnitudeでモデルをダウンロードしたあと、「Connections」の画面からClaude Code・Codex・Cline・OpenCodeなどにつなげます。ほかのアプリからはOpenAI互換のAPIで呼び出す形です。ただし手元で動くのはオープンモデルです。Claude本体のモデルがPCで動くわけではありません。
- GPUメモリに入らない大きなモデルは動く?
- 大きなモデル向けの仕組みはまだ計画の段階です。開発チームは、大規模モデルの一部のパラメーターをRAMやストレージに置いて必要なときに読み込む「Expert streaming」を予定に挙げています。CPU・GPU・RAM・ストレージをまとめて使う最適化も今後の話です。大きなモデルを前提に機材を選ぶのは、これらが出てからでも遅くありません。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年10月2日