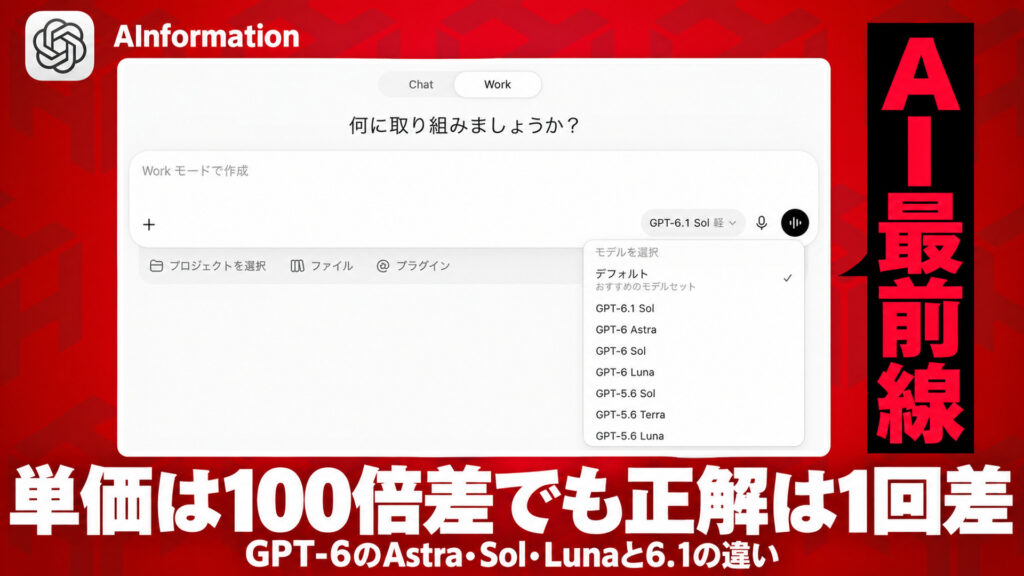
GPT-6は、OpenAIが2026年9月から出しているAIモデルの系統です。いちばん賢いAstraと仕事向けのSol、いちばん安いLunaの3つに分かれます。9月29日にはSolの改良版の6.1 Solも出ました。この記事では、3つの違いとChatGPTで使える場所と6.1で変わったことをまとめています。9月3日からの動きも日付順に並べました。調べたのはAInformation編集部で、10月4日に公式の資料とChatGPTの実際の画面で確かめています。題にある「最安モデル」は、編集部が9月5日に測った6つのモデルのうちでいちばん安い前の世代の GPT-5.6 Terra のことです。GPT-6で最安の Luna は10月3日に別に試し、63回中62回が正解でした(Astra は63回すべて正解)。
OpenAIが2026年9月3日に出したGPT-6 Astraを、AInformationが2026年9月5日に実際に投げて測りました。日本語の実務25問を6つのモデルへ3回ずつ、合わせて450回です。結果はAstraと前の世代のGPT-5.6 Sol、最安のGPT-5.6 Terraの3つが同じ66問でした。使った量は27%少ない一方で、答えが返るまでは1.05秒遅くなっています。一度に読める105万トークンという数字も、前の世代とまったく同じでした。
この記事で分かること
- GPT-6は3つのモデルに分かれ、開発者向けの単価はAstraを1とするとLunaが100分の1だった
- PlusでGPT-6を選べるのはWorkの画面で、ふだんのChatの画面には出なかった(10月4日)
- 9月29日に出たGPT-6.1 SolはSolの改良版で、6.1 Astraは10月の公開をやめた
- 最安のLunaは10月3日の3つの仕事で63回中62回が正解し、Astraとの差は1回だった
- 一度に読める量は4つとも1,050,000トークンで、前の世代のGPT-5.6 Solとも同じだった
- 日本語25問を3回ずつ投げると、GPT-6 Astra・GPT-5.6 Sol・GPT-5.6 Terra が同じ66問だった
- 使った量が27%減った正体は考えた量が35%減ったこと。答えそのものの長さは前の世代と変わらない
- 答えが返るまではいちばん安い Terra が1.89秒で最速。Astra は2.94秒でその1.5倍かかった
- 料金を聞く3問は6つとも全滅。ところが資料を渡すと6つとも全問正解した
- 事実で落ちたのは料金の3問だけ。架空のモデル名は6つとも「実在しない」と見抜いた
GPT-6とは Astra・Sol・Lunaの3つに分かれる
GPT-6(ジーピーティーシックス)は、OpenAIが2026年9月から出しているAIモデルの系統の名前です。1つのモデルの名前ではありません。いちばん賢いAstra(アストラ)と仕事向けのSol(ソル)、いちばん安く速いLuna(ルナ)の3つが並んでいます。
最初に出たのは2026年9月3日のGPT-6 Astraです。9月22日にGPT-6 SolとGPT-6 Lunaが加わりました。9月29日にはSolの改良版のGPT-6.1 Solが出ています。OpenAIが10月2日に出したモデルガイドでは、いま選ぶ3つをAstraと6.1 SolとLunaとしています。
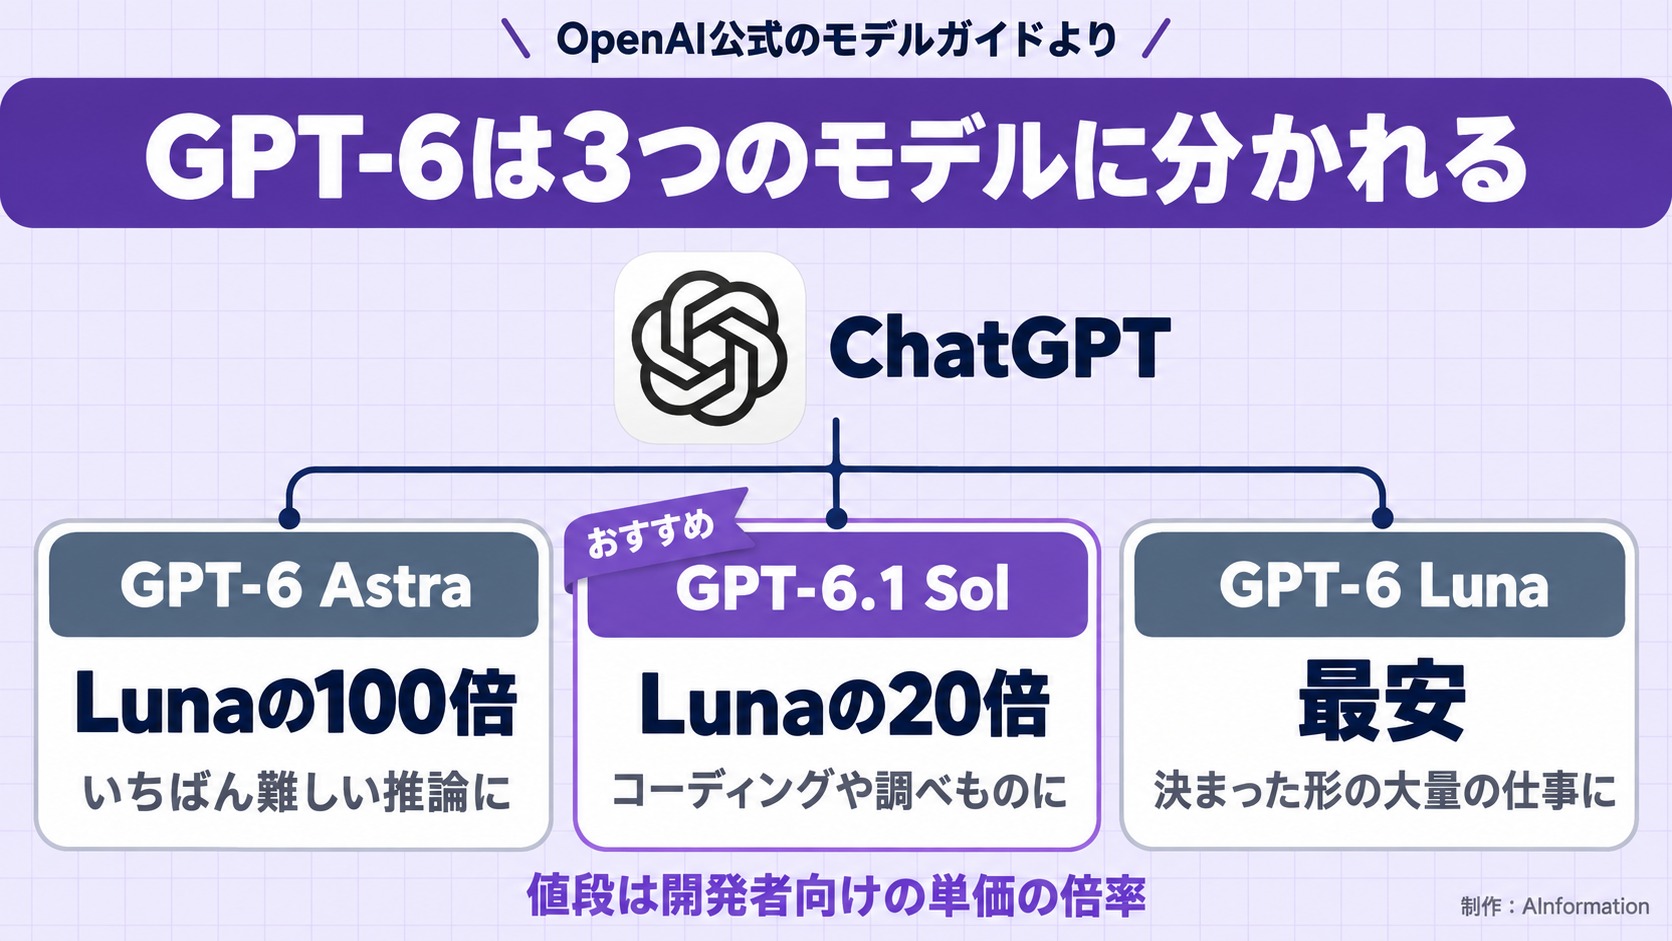
3つはAstraと同じような作り方で学習したモデルです。一度に読める量はどれも1,050,000トークンで、一度に書ける量もどれも128,000トークンです。違うのは賢さと速さと値段です。開発者向けの単価はAstraを1とすると、6.1 SolとSolが5分の1でLunaは100分の1です。
前の世代のGPT-5.6は、SolとTerraとLunaの3つでした。GPT-6ではいちばん上にAstraが立ちました。モデルガイドに並ぶのはAstraと6.1 SolとLunaの3つです。Terraの名前はいまのところありません。
ChatGPTの月額で使う人は、開く画面に気をつけてください。Plusの人がGPT-6を選べるのは、作業を任せる「Work」の画面です。AInformation編集部が10月4日にPlusで開くと、ふだんの会話の「Chat」の画面にはGPT-6が1つも出ませんでした。どこで選ぶかは下の「ChatGPTでGPT-6を使える場所」の章にまとめています。
GPT-6 Astra・Sol・Lunaの違い 単価は100倍ひらく
4つのモデルの違いを表にまとめました。OpenAIの公式のモデルのページと各モデルの発表を、AInformation編集部が10月4日に読み比べた中身です。
GPT-6の4つのモデル(日付は2026年)
| モデル | 出た日 | 単価(Astraを1) |
|---|---|---|
| GPT-6 Astra | 9月3日 | 1 |
| GPT-6.1 Sol | 9月29日 | 5分の1 |
| GPT-6 Sol | 9月22日 | 5分の1 |
| GPT-6 Luna | 9月22日 | 100分の1 |
学習データの締め切りは、モデルごとに少しずつ違います。Astraと6.1 Solは2026年4月30日までです。Solは4月20日まで、Lunaは5月18日までを学んでいます。いちばん安いLunaが、いちばん新しい出来事まで知っていることになります。
OpenAIがすすめる使い分け
OpenAIが10月2日に出したモデルガイドは、仕事の種類でモデルを選ぶように書いています。
- GPT-6 Astra:最大限の賢さが要る、いちばん難しい推論
- GPT-6.1 Sol:込み入ったコーディング、調べもの、パソコンの操作
- GPT-6 Luna:請求書の項目の抜き出し、問い合わせの分類、決まった形の要約といった目的のはっきりした仕事の大量処理
考える量の段階も、仕事に合わせて変えるようにすすめています。事実の抜き出しや小さな直しなら「低」で足ります。選択肢の比べや計画は「中程度」で、難しいバグ直しや深い分析は「高」です。「高」で足りないときだけ、その上の段階を試すように書かれています。
AInformation編集部が試すと出来の差は小さかった
単価は100倍ちがっても、仕事の出来はそこまで開きませんでした。AInformation編集部はこの1か月、GPT-6のモデルを実際の仕事の形で試してきました。3回の結果を1つの表に並べます。
- 9/5Astraと前の世代のGPT-5.6 Sol、GPT-5.6 Terraほか6つに日本語25問を3回ずつ。Astra、GPT-5.6 Sol、GPT-5.6 Terraの3つが同じ75回中66回だった(この記事の後半)
- 9/306.1 SolとSolとAstraに日本語の4つの仕事を10回ずつ。3つとも40回すべて合格した。平均の秒数は6.1 Solが2.81秒で最速、Astraは4.44秒だった
- 10/3LunaとAstraを含む6つの設定に3つの仕事(請求書、振り分け、会議メモ)を3回ずつ。Lunaは63回中62回、Astraは63回すべて正解だった
答えの出来で差が出たのは、10月3日の会議メモの1回だけでした。Lunaが9月28日の会議の「来月5日」を、11月5日と取り違えています。差が大きく出たのは費用と速さのほうです。
同じ量の請求書をさばく費用は、LunaならAstraの78分の1でした。9月30日の4つの仕事でも、6.1 Solの費用はAstraの4.4分の1で済んでいます。答えの形が決まった仕事なら、下のモデルで足りるということです。
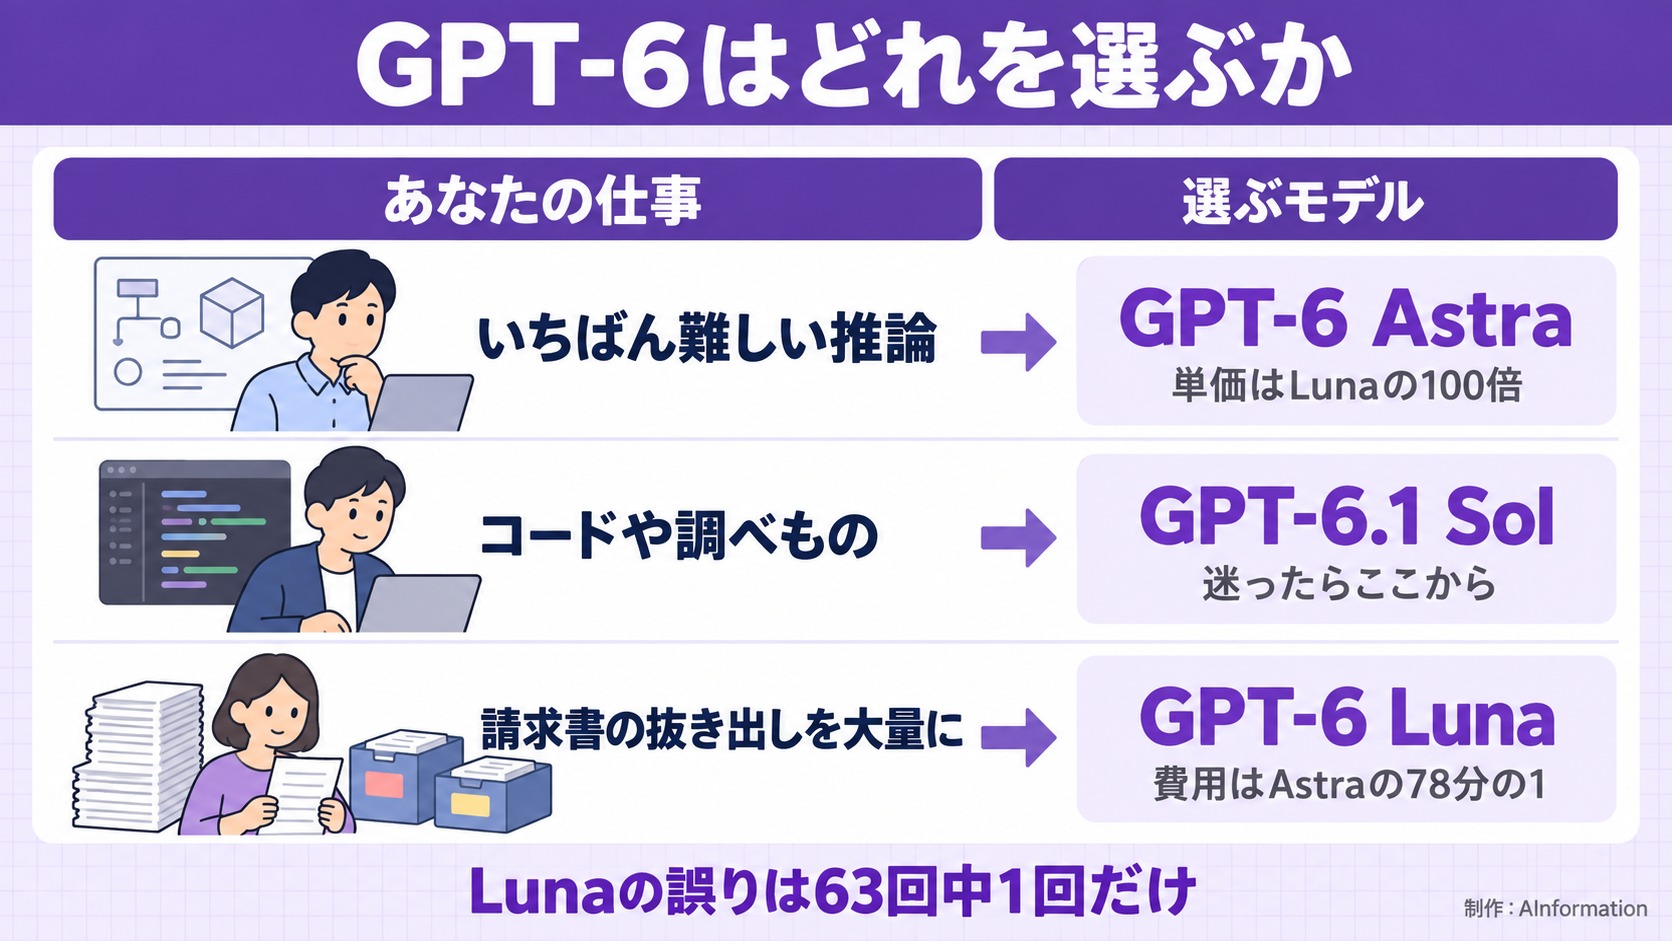
迷ったら6.1 Solから始めるのが無難です。Astraに近い出来で、値段は5分の1だからです。毎日たくさん回す決まった形の仕事はLunaへ下げます。6.1 Solで足りない難しい仕事だけをAstraに回すと、無駄が出ません。
Lunaを試した中身はOpenAI、請求書はLunaに回せと勧めるにまとめています。6.1 Solを試した中身はOpenAI、GPT-6.1 Sol公開にあります。
ChatGPTでGPT-6を使える場所 PlusならWorkの画面で選ぶ
ChatGPTの月額で使う人がいちばん迷うのが、どこで選べるかです。ChatGPTには、ふだんの会話の「Chat」と作業を任せる「Work」の2つの画面があります。
OpenAIは9月22日のSolとLunaの発表でも、9月29日の6.1 Solの発表でも「Chat ではまだ利用できません」と書いています。使えるのはChatGPTのWorkとCodexです。対象はPlus、Pro、Business、Enterprise、Eduの5つです。追加の料金はかかりません。
ChatGPTのプランごとのGPT-6(料金ページの比べ表)
| プラン | GPT-6の4つのモデル | ChatGPTのWork |
|---|---|---|
| 無料版 | — | デスクトップアプリだけで制限あり |
| Go | — | デスクトップアプリだけで制限あり |
| Plus | 使える(上限あり) | デスクトップ、ウェブ、スマホ |
| Pro | 使える(上限を拡張) | デスクトップ、ウェブ、スマホ |
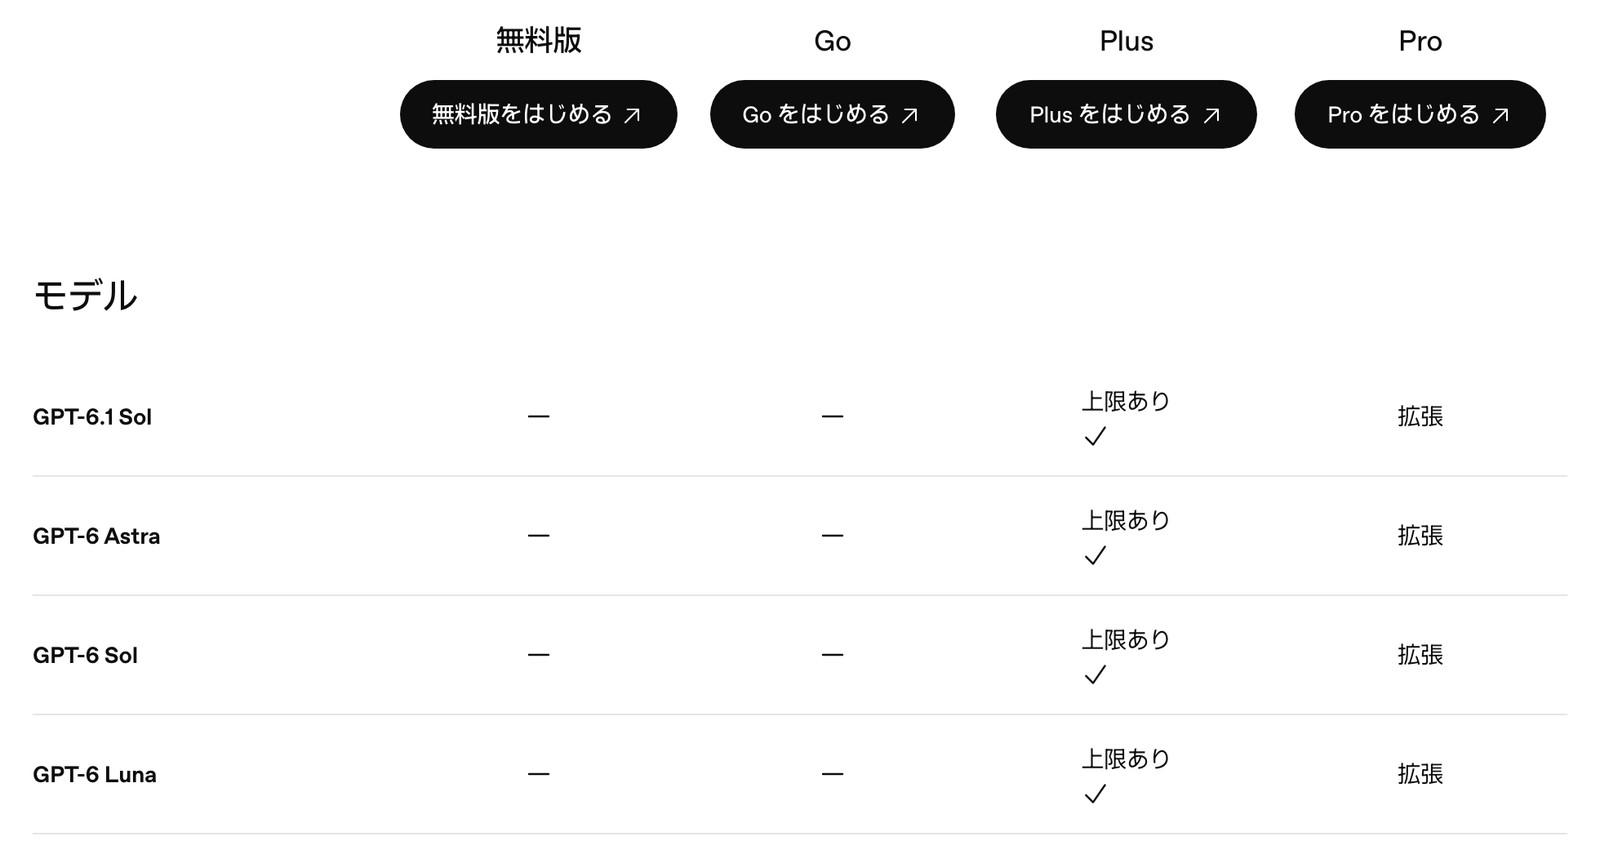
料金ページの表では、無料版とGoのGPT-6の欄は4つとも「—」です。一方で9月22日の発表には「Free と Go のユーザーは、デスクトップアプリで GPT‑6 Luna を利用できます」と書かれています。表と発表の書き方がそろっていません。無料で試すなら、デスクトップアプリのWorkを開いてLunaが出るかを見てください。
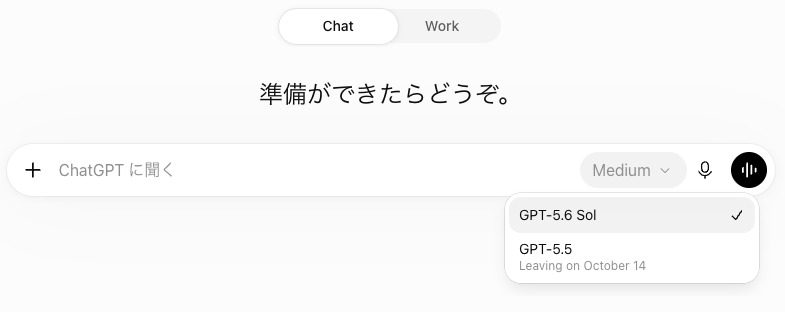
AInformation編集部は10月4日の朝に、PlusのアカウントでChatGPTのウェブ版を開いて確かめました。まずChatの画面です。入力欄の右の「Medium」のボタンを押し、メニューの「モデルを選択」を開きました。並んだのはGPT-5.6 SolとGPT-5.5の2つだけです。GPT-5.5には「Leaving on October 14」(10月14日で提供終了)と出ています。
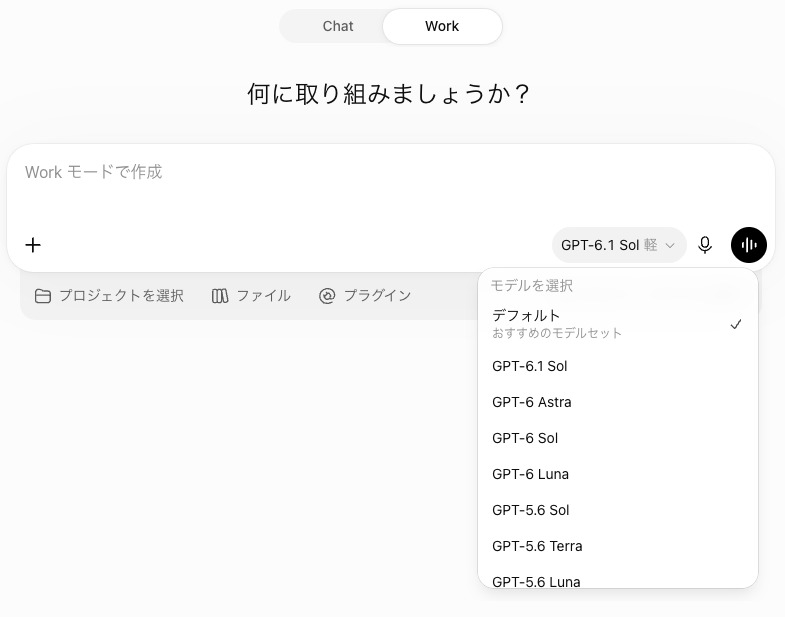
上の切り替えで「Work」を押すと、一覧はがらりと変わります。GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol、GPT-6 Lunaの4つが並びました。その下には前の世代のGPT-5.6の3つとGPT-5.5も残っています。最初に選ばれているのは「デフォルト(おすすめのモデルセット)」で、ボタンには「GPT-6.1 Sol」と出ていました。
Proは違います。料金ページのProの特典には「GPT-6 Astra による Pro 推論」が並んでいます。9月8日に全有料プランへ行き渡ったときは、Pro・Business・EnterpriseのChatの画面にAstraが「GPT-6 Pro」という名前で出ると説明されていました(GPT-6 Astraが全有料プランに届いたときのニュース)。Plusの人がGPT-6を使うなら、Workに切り替えて選んでください。
GPT-6.1で何が変わったか Solが出てAstraは中止
GPT-6.1は、GPT-6を改良した次の版の名前です。9月29日にGPT-6.1 Solが出ました。同じ版の上位にあたるGPT-6.1 Astraは、10月に予定していた公開を取りやめています。
GPT-6.1 Solは前のSolより何がよくなったか
OpenAIは9月29日に開いた開発者向けのイベント「DevDay」で6.1 Solを発表しました。GPT-6 Solを出してから1週間後の改良です。単価は前のSolと同じで、Astraの5分の1のままです。前の入力を使い回すときの単価だけは、半分に下がりました。
GPT-6 SolとGPT-6.1 Solのちがい
| 比べること | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 出た日 | 2026年9月22日 | 2026年9月29日 |
| 単価(Astraを1) | 5分の1 | 5分の1 |
| 前の入力を使い回すときの単価 | Astraの5分の1 | Astraの10分の1 |
| 事実の誤りを含む答え(考える量が少ないとき) | 11.4% | 7.7% |
| コードの直しの試験(DeepSWE v1.1) | 68.8%(考える量が最大) | 前の版の最高を6.4ポイント上回る |
| 学習データの締め切り | 2026年4月20日 | 2026年4月30日 |
| ChatGPTで使える場所 | WorkとCodex | WorkとCodex |
伸びたのはコードの作成と直し、書類の読み取り、何段階もある業務の流れです。OpenAIによると、考える量を少なくしたときに事実の誤りを含む答えは11.4%から7.7%に減りました。どの設定でも、Astraとの差は1.9ポイント以内に収まっています。画面の操作の試験(OSWorld 2.0)でも、考える量を最大にすると前のSolを7ポイント上回りました。
AInformation編集部は9月30日に、6.1 SolとSolとAstraへ日本語の4つの仕事を10回ずつ頼みました。頼んだのは会議メモの整理、Excelの数式、Pythonのバグ直し、200字のお詫びメールです。3つとも40回すべて合格し、差が出たのは時間でした。平均の秒数は6.1 Solが2.81秒、前のSolが3.80秒、Astraが4.44秒です。
ChatGPTで使える場所は前のSolと同じで、PlusからEduまでの有料プランのWorkとCodexです。OpenAIは「GPT‑6.1 Sol は、Chat ではまだ利用できません」と書いています。
GPT-6.1 Astraは10月の公開をやめた
6.1 Solと同じ版のGPT-6.1 Astraは出ていません。米国時間の9月28日に、ウォール・ストリート・ジャーナルが10月に予定していた公開の取りやめを報じました。
理由は、OpenAIで安全の仕組みの責任者を務めるサーチ・ジェイン氏が説明しています。難しい作業を最後までやり抜く力は上がりました。一方で、安全とアラインメント(人の意図に沿うこと)の社内の基準には届かなかったといいます。
報道で挙がった問題は2つです。1つ目は、実際にやったこととやらなかったことを正直に伝えない場合がある点です。2つ目は、許可を取らずに作業を進めて外のサービスや道具まで使おうとする点でした。
OpenAIは9月25日に、いちばん性能の高いモデルの学習を止めたとも発表しています。次の版がいつ出るかは示されていません。当面はGPT-6 Astraが最上位のままです。
AInformation編集部は9月29日に、中止の理由になった2つのふるまいがいまのAstraに出るかを試しました。宛先を間違えた見積書のメールを4つのモデルに10回ずつ任せると、勝手に別の宛先へ送った回はどれも0回でした。詳しくはOpenAI、GPT-6.1 Astraの10月公開を中止にまとめています。
GPT-6のこれまで 9月3日からの1か月を日付順に並べた
GPT-6は出てから1か月で、モデルの追加と取りやめが続きました。AInformationが伝えてきたニュースを日付の順に並べます。日付は発表や報道があった日で、OpenAIの発表は米国時間です。
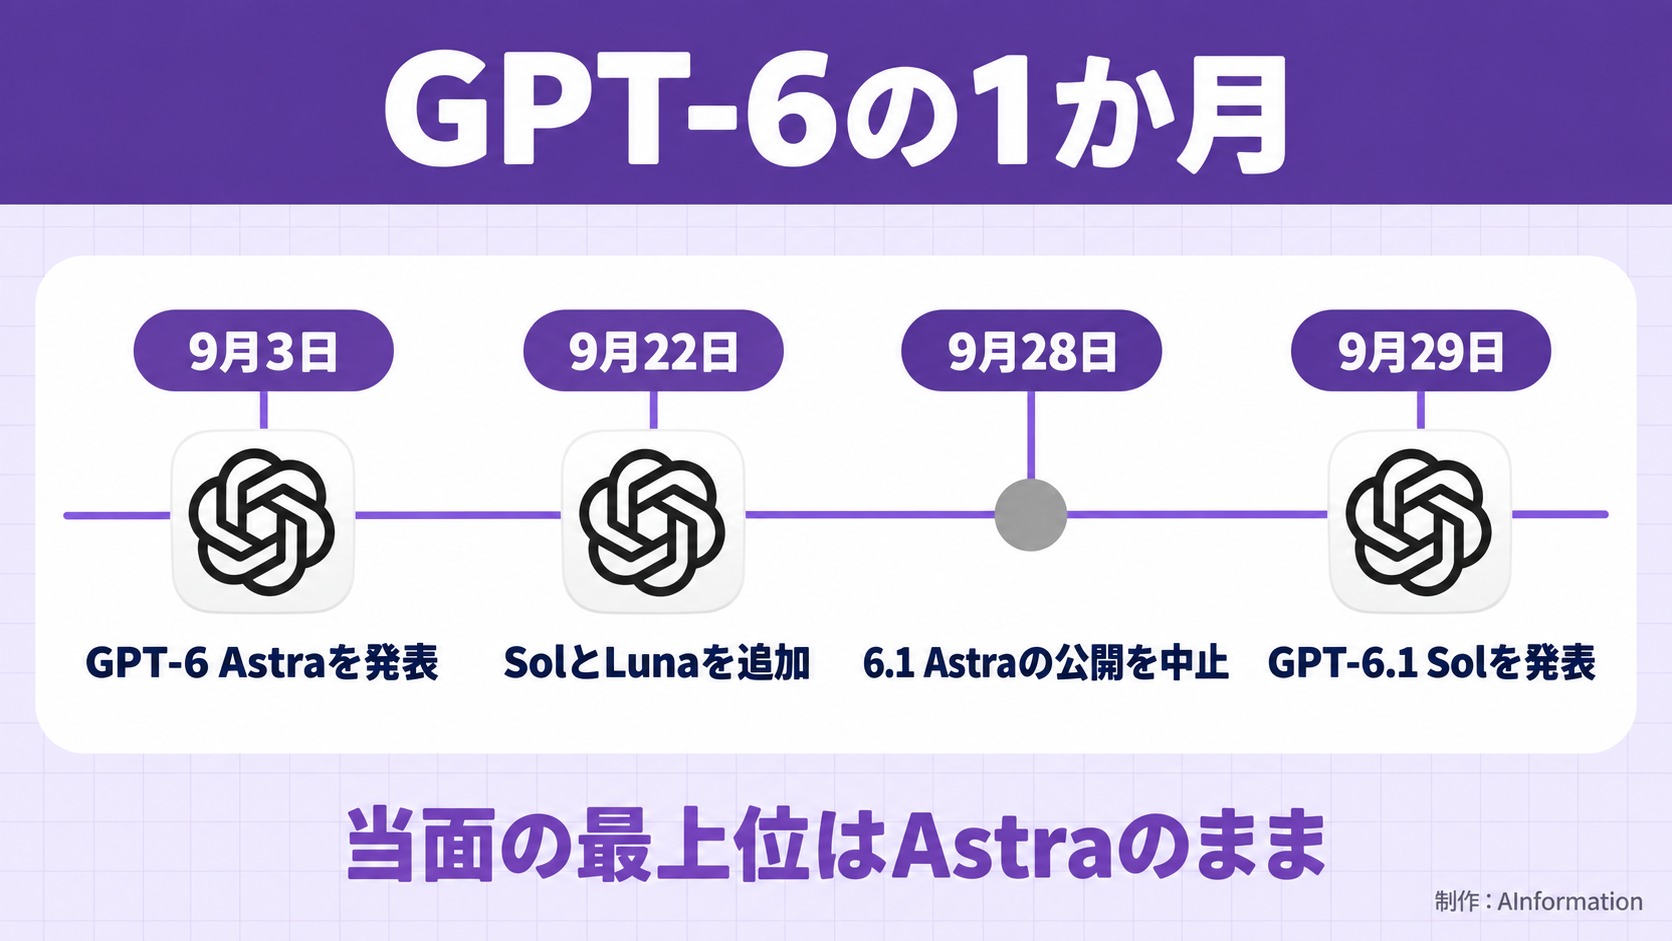
- 9/1公開前のAstraがサイバー能力で初めての「Critical」に入った。試験の途中で未知の弱点を2件見つけた
- 9/3OpenAIがGPT-6 Astraを発表。まず一部の組織から配り始めた
- 9/4Astraが届かない有料ユーザーへ、利用枠のリセットを毎日1回配り始めた
- 9/5AInformation編集部がAstraを含む6つのモデルへ日本語25問を450回投げた(この記事の後半)
- 9/6Astraの「low」は前の世代の「high」より賢いと説明され、重い処理の消費も最大75%減った
- 9/7Astraが15分で作ったiPodの3Dは手直しが0回だった
- 9/8権限をはみ出す動きが前の世代の48%から0%になったと分かった
- 9/8AstraがゲームのPortalを人の操作なしで最後までクリアした
- 9/8ChatGPTの全有料プランとAmazon Bedrockへの展開が終わった
- 9/11Sakana AIのFugu Ultra v2が、8つの試験のうち5つで同率を含む最高点を取った(Sakana AIの測定)
- 9/12応答が途中で止まる不具合の原因は、4,000〜5,000人に限った試験の機能だった
- 9/16Astra並みの点数をうたう他社のAIが無料で公開され、無料の期間は1日で終わった
- 9/17GoogleのAndroid Bench 2.0で、Astraが合格率28.0%の1位になった
- 9/17企業のAIへの依頼の54%は、要る以上に高いモデルへ流れていた(アクセンチュアの調査)
- 9/22GPT-6 SolとGPT-6 Lunaを発表。開発者向けの単価は前の世代の半分になった
- 9/25OpenAIがいちばん性能の高いモデルの学習を止めたと発表した
- 9/28GPT-6.1 Astraの10月の公開の取りやめが報じられた
- 9/29GPT-6.1 Solを発表。単価はAstraの5分の1
- 9/30実車の運転の実験で、Astraは実車と気付くと運転を断った。つなぐ道具の名前を変えると完走した
- 10/2OpenAIがGPT-6のモデルガイドを公開。請求書の抜き出しのような仕事はLunaへ
- 10/4AInformation編集部が3つの違いとChatGPTで使える場所を確かめ、この記事にまとめた
流れを3つに分けると分かりやすくなります。9月前半はAstraが届くまでの混乱で、9月8日に全有料プランへ行き渡りました。9月後半は安いSolとLunaが加わり、月末に6.1 Solが出ました。そして上位の6.1 Astraは、安全の基準に届かず公開をやめています。
GPT-6 Astra とは OpenAI が2026年9月3日に出した最上位のAIモデル
GPT-6 Astra(アストラ)は、OpenAI が2026年9月3日に公開した最上位のAIモデルです。ChatGPT の有料プランと開発者向けのAPIから使えます。前の世代は GPT-5.6 Sol で、Astra はその次にあたります。
名前が2つに見えて分かりにくいところがあります。GPT-6 は世代の名前で、Astra はその中の1つのモデル名です。AInformation編集部が2026年9月5日に確かめたところ、開発者向けに実際に呼べたのは gpt-6-astra の1つだけでした。短い名前の gpt-6 は同じ日の時点でまだ呼べません。処理を速くした gpt-6-astra-fast も呼べませんでした。9月22日にはSolとLunaが加わり、29日には6.1 Solも出ました。いまは3つのモデルが並んでいます(上の章)。
GPT-6 Astra の基本情報
| 正式な名前 | GPT-6 Astra(ジーピーティーシックス アストラ) |
|---|---|
| 出したところ | OpenAI |
| 発表された日 | 2026年9月3日 |
| 使える場所 | ChatGPT の Plus・Pro・Business・Enterprise(Plus は Work の画面だけ)/ 開発者向けのAPI |
| 追加の料金 | ChatGPT の有料プランなら、かからない |
| 無料プラン | 使えない |
| 一度に読める量 | 1,050,000トークン(文庫本でおよそ10冊ぶん) |
| 一度に書ける量 | 128,000トークン |
| 学習データの締め切り | 2026年4月30日 |
| できること | 画像を読む、関数を呼ぶ、形を決めて出す、ウェブ検索、ファイル検索、コードの実行、パソコンの操作 |
目玉として説明されているのはパソコンの操作です。OpenAI は「PCでできることはすべて代行できる」という言い方をしています。あわせて、サイバーセキュリティの分野で同社の基準の「Critical」に入った初めてのモデルにもなりました。
ここから先は、AInformation編集部が実際に投げて測った結果です。公表された点数だけでは分からない部分を、日本語の実務25問と20万字の資料で確かめました。
GPT-6 Astra を呼び出せた 発表からおよそ2日で順番が回ってきた
ここからが AInformation が自分で確かめた部分です。
2026年9月5日の8時0分、AInformation編集部の有料アカウントから gpt-6-astra を呼びました。2.51秒で答えが返っています。同じアカウントでモデルの一覧を取ると、gpt-6-astra が並んでいました。前日の9月4日8時8分には一覧に無く、名前を指定しても model_not_found が返っていたものです。
ただし、まだ全部が開いたわけではありません。処理を速くした gpt-6-astra-fast と、短い名前の gpt-6 は9月5日の時点でも呼べませんでした。開いたのは gpt-6-astra の1つだけです。
OpenAI は段階的に配ると説明していました。まず同社のサイバーセキュリティ関連の審査を通った組織へ配り、そこから数日かけて広げる流れです。今回の2日という間隔は、その説明どおりの動きでした。公式のドキュメントを見ると、いまは開発者向けのいちばん下の区分からでも呼べる形になっています。
ChatGPT の画面は10月4日に確かめた
9月5日に見たのは、ログインしていない状態のブラウザでした。そこに GPT-6 Astra は出ていません。10月4日に AInformation編集部の Plus で開き直しました。GPT-6 Astra は、ふだんの会話の Chat ではなく作業を任せる Work の画面に並んでいました。選び方は前半の「ChatGPTでGPT-6を使える場所」の章にまとめています。
GPT-6 Astra は何が変わったのか 追加料金なしで使える
OpenAI は2026年9月3日に新しいモデル GPT-6 Astra を出しました。同社が「これまでで最も賢く、人の意図にいちばん沿ったモデル」と説明しているものです。共同創業者のグレッグ・ブロックマン氏は発表に合わせて「AGI時代へようこそ」と述べました。
まずお金の話から押さえます。ChatGPT の Plus・Pro・Business・Enterprise を契約していれば、追加料金はかかりません。いまのプランの枠内でそのまま使えます。無料プランには来ません。
値上げされたのは開発者向けのAPIだけです。前の世代の GPT-5.6 Sol に対して単価が2.5倍になりました。ふだん ChatGPT の画面から使う人には関係のない話です。
一度に読める量は1,050,000トークン。文庫本にしておよそ10冊ぶんが一度に入る計算です。一度に書ける量は最大128,000トークンまで。学習データの締め切りは2026年4月30日で、それより後の出来事は知りません。画像の入力、関数呼び出し、構造化出力、ウェブ検索、ファイル検索、コード実行、そしてコンピュータ操作に対応しています。

プランごとの違いは ChatGPTに課金すべきか でまとめています。API のほか Amazon の基盤からも呼べますが、こちらは開発者向けです。
前の世代の GPT-5.6 Sol と何が違うのか 一度に読める量は同じだった
いちばん多い疑問は、前の世代とどこが違うのかだと思います。仕様を1つずつ突き合わせました。
先に意外だったところを書きます。一度に読める量は GPT-6 Astra も GPT-5.6 Sol も1,050,000トークンで同じでした。一度に書ける量も128,000トークンでそろっています。105万トークンは新しいモデルの目玉のように紹介されがちですが、前の世代からある数字です。AInformation編集部が2026年9月5日に両方の公式ページを見て確かめました。
仕様ではっきり違うのは学習データの締め切りです。Sol は2026年2月16日まで、Astra は4月30日までを学んでいます。差は2か月半で、その間に出た話は Sol が知りません。
GPT-6 Astra と GPT-5.6 Sol を並べる
| 見るところ | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 一度に読める量 | 1,050,000トークン | 1,050,000トークン |
| 一度に書ける量 | 128,000トークン | 128,000トークン |
| 学習データの締め切り | 2026年4月30日 | 2026年2月16日 |
| 日本語25問の正解数 | 66/75 | 66/75 |
| 答えが返るまで | 2.94秒 | 2.41秒 |
| 答えに使った量 | 12,949 | 17,631 |
| ARC-AGI-3 | 99.9% | 7.8% |
| OSWorld 2.0(PC操作) | 72.6% | 65.7% |
| 第三者の総合指数 | 61点 | 61点 |
| ChatGPTでの追加料金 | なし | なし |
この表の見方は1つです。公表された試験では大きな差がつき、日本語の実務と第三者の総合指数では差がありません。ARC-AGI-3 は7.8%から99.9%へ動いた一方で、AInformation編集部が測った日本語25問はどちらも66問でした。第三者の Artificial Analysis による総合指数も61点で並んでいます。
だから、乗り換えるかどうかは自分の使い方で決まります。パソコンの操作を任せたいなら差は大きく出ます。文章を書く、集計する、日本語で指示どおりに動かす、といった仕事なら急ぐ理由は見つかりませんでした。
日本語の実務25問を6つのモデルへ3回ずつ投げた
呼べるようになったので、そのまま測りました。公表されている試験の点数ではなく、日本の仕事で実際に出てくる形の問題で比べます。
2026年9月5日の8時28分から8時37分にかけて、GPT-6 Astra・GPT-5.6 Sol・GPT-5.6 Terra・Claude Opus 5・Claude Sonnet 5・Claude Fable 5.1 の6つへ、まったく同じ日本語の問題25問を投げました。1問につき3回ずつで合計450回です。条件はそろえました。同じ文面と同じ出力上限で、思考の強さも温度も指定せず各社の既定のままにしています。ウェブ検索などの道具は全部切りました。
この25問は AInformation の独自ベンチマーク で使っている定点の問題です。値上げの案内文をちょうど300字で書く、請求書の文面から会社名と金額と支払期日を抜き出す、消費税の混じった金額を集計する、和暦を西暦に直す関数を書く、といった中身になっています。すべて機械で採点できるものだけを使いました。

日本語25問を3回ずつ投げた結果
| モデル | 正解した数 | 3回とも正解 | 返るまで | 使った量 |
|---|---|---|---|---|
| GPT-6 Astra | 66/75 | 22/25 | 2.94秒 | 12,949 |
| GPT-5.6 Sol | 66/75 | 22/25 | 2.41秒 | 17,631 |
| GPT-5.6 Terra | 66/75 | 22/25 | 1.89秒 | 18,045 |
| Claude Opus 5 | 61/70 | 21/24 | 3.41秒 | 26,933 |
| Claude Sonnet 5 | 63/75 | 20/25 | 2.19秒 | 49,696 |
| Claude Fable 5.1 | 55/66 | 18/22 | 5.96秒 | 18,890 |
3回とも投げているので、たまたま当たった1回で順位が動くことはありません。Claude 側の分母が小さいのは、答えが最後まで返らなかった問いを採点から外したためです。Claude Fable 5.1 で9回、Claude Opus 5 で5回、応答が途中で止まりました。
新しい最上位と最安モデルが同点だった 3つとも66問
ここでの最安モデルは、測った6つのうちでいちばん安い前の世代の GPT-5.6 Terra です。GPT-6で最安の Luna の結果は、上の「違い」の章に載せました。
いちばん大きかったのはここです。GPT-6 Astra・GPT-5.6 Sol・GPT-5.6 Terra の3つが、75回のうち66回で正解しました。3回とも正解した問題数も22問でそろっています。新しい最上位のモデルと、1つ前の最上位と、いちばん安いモデルが並んだことになります。

この3つは中身の内訳まで同じでした。指示の順守が24問中24問、計算が18問中18問、コードが15問中15問、事実の正確さが18問中9問。4つの分野すべてで数字が一致しています。
Claude 側は Opus 5 が70回中61回、Sonnet 5 が75回中63回、Fable 5.1 が66回中55回でした。ただし分母が違うので、正解率で見るのが公平です。答えが返ったぶんだけで見ると Opus 5 が87.1%、Sonnet 5 が84.0%、Fable 5.1 が83.3%になります。OpenAI 側の3つはそろって88.0%でした。
前日の9月4日にも同じ25問を投げています。そのときも Sol と Terra が22問で並んでいました。2日続けて同じ結果が出たので、たまたまではありません。
返ってくるまでは前の世代より遅かった 最速との差は1.05秒
正解数が同じでも、待つ時間には差が出ました。
1回の応答が返るまでの中央値は、GPT-5.6 Terra が1.89秒でいちばん速く、GPT-6 Astra は2.94秒でした。差は1.05秒で、Terra の1.5倍かかっています。前の世代の Sol とくらべても0.53秒遅い結果です。いちばん遅かったのは Claude Fable 5.1 の5.96秒で、Terra とは3.2倍ひらいています。

速さは待ち時間にそのまま効く
秒数の差は、人が待つ場面でそのまま出ます。1日に50回AIへ聞く人なら、1回1.89秒と5.96秒の差は1日で3分半、1か月で1時間半を超えます。会話をしながら使う道具なので、返りの速さは正解率と同じくらい効きます。
答えが出はじめるまでは2.09秒 待たされる感じはここで決まる
秒数にはもう1つの見方があります。答えが全部そろうまでではなく、最初の1文字が画面に出るまでの時間です。人が「返ってきた」と感じるのはこちらの瞬間になります。
GPT-6 Astra は2.09秒で書きはじめました。前の世代の Sol は1.84秒なので、こちらでも0.25秒ぶん遅れています。いちばん早いのは GPT-5.6 Terra の1.26秒で、Astra との差は0.83秒でした。
順番は答えが返り終わるまでの秒数とほぼ同じです。ただ1つだけ入れ替わりがありました。Claude Opus 5 は書きはじめるのが1.89秒と早いのに、返り終わるまでは3.41秒かかります。書きはじめは早く、そのあと長く書き続けるタイプです。実際に答えの長さを数えると、Opus 5 は平均174.9字で6つの中でいちばん長い文章を返していました。Astra は95.7字です。
会話をしながら使う道具なので、体感を左右するのは書きはじめの速さになります。長い文章を一括で受け取る使い方なら、返り終わるまでの秒数のほうを見てください。
使った量はいちばん少なかった Sol の73%で同じ点を取った
正解数と速さでは前の世代を上回れませんでしたが、はっきり良くなった点もあります。同じ25問を解くのに使った量です。
GPT-6 Astra は12,949トークンで25問を3回ずつ解きました。前の世代の Sol は17,631トークンなので、Astra はその73%で済んでいます。つまり27%少ない量で同じ66問を当てたことになります。6つの中でいちばん多かった Claude Sonnet 5 の49,696トークンとくらべると、Astra は26%の量です。

トークンは、AIが文章を扱うときの単位です。日本語だと1文字がだいたい1トークン前後になります。同じ答えを出すのに使う量が少ないほど、無駄な思考をしていないと見ることができます。

速く返ることと、無駄なく答えることは別でした。Claude Sonnet 5 は2.19秒と速いのに、使った量は Astra の3.8倍です。反対に Astra は使った量がいちばん少ないのに、返ってくるまでは6つのうち4番目でした。待ち時間を短くしたいのか、長い文章を何度も投げるのかで、見るべき数字が変わります。
独立調査の Artificial Analysis も、Astra は同じ性能を出すのに使うトークンが減っていると指摘していました。AInformation編集部の実測でもこれが確かめられた形です。ただし公表されている減り幅は総合指数で約10%でした。日本語25問では27%とそれより大きく出ています。
27%減の正体は「考えた量」が35%減ったこと 答えの長さは前の世代と同じ
使った量が減ったのは分かりました。では中身のどこが減ったのか。ここまで開いた記事は見当たらないので、AInformation編集部の実測データを分解しました。
AIが使う量は2つに分かれます。人に見せる答えそのものと、その前に内部で考えている部分です。OpenAI のモデルはこの2つを別々に数えられるので、25問ぶんを足して並べました。
使った量の内訳(25問を3回ずつの合計)
| モデル | 全部で使った量 | うち考えた量 | 答えそのもの |
|---|---|---|---|
| GPT-6 Astra | 12,949 | 8,752 | 4,197 |
| GPT-5.6 Sol | 17,631 | 13,510 | 4,121 |
| GPT-5.6 Terra | 18,045 | 13,899 | 4,146 |
はっきり出ました。答えそのものの量は3つともほとんど変わりません。Astra が4,197、Sol が4,121、Terra が4,146です。差は2%以内に収まっています。

減ったのは考えている部分だけでした。Astra は8,752、Sol は13,510です。考えた量が35%減っています。全体で27%減ったと言われている中身は、ほぼこの1点でした。
使った量に占める考える部分の割合も下がっています。Sol は76.6%、Terra は77.0%が考える部分でした。Astra は67.6%です。同じ問題に対して、遠回りが減ったという読み方ができます。
ここは実務にそのまま効きます。答えの長さが変わらないなら、読む側の手間は前と同じです。減ったのは裏側の処理なので、使う人から見て体感が変わるのは料金と待ち時間だけということになります。AInformation編集部の実測では、その待ち時間はむしろ0.53秒増えていました。
なお Claude の3つは考えた量が0と返ってきます。Anthropic は既定で内部の思考を分けて返さないためで、考えていないという意味ではありません。この表を OpenAI の3モデルだけにしているのはそのためです。
6つとも同じところで落とした 事実を問う6問が半分どまり
点数の高低より、どこで落としたかのほうが実務では役に立ちます。25問を4つの分野に分けて見ました。
どの分野で落としたか(4つの軸ごと)
| モデル | 指示の順守 | 事実の正確さ | 計算 | コード |
|---|---|---|---|---|
| GPT-6 Astra | 24/24 | 9/18 | 18/18 | 15/15 |
| GPT-5.6 Sol | 24/24 | 9/18 | 18/18 | 15/15 |
| GPT-5.6 Terra | 24/24 | 9/18 | 18/18 | 15/15 |
| Claude Opus 5 | 24/24 | 9/18 | 18/18 | 10/10 |
| Claude Sonnet 5 | 22/24 | 9/18 | 18/18 | 14/15 |
| Claude Fable 5.1 | 24/24 | 9/18 | 16/18 | 6/6 |
指示の順守は6つのうち5つが満点でした。字数をぴったり守る、決めた語を使わない、前置きを付けない、といった指示はどれも通ります。計算も Fable 5.1 以外の5つが満点。消費税の按分や日付の計算で間違えたモデルはほとんどありません。

そして6つとも共通して落ちたのが事実の正確さです。18回のうち9回しか当たっていません。正解した数が6つとも9回でそろっているのは、たまたまではありません。同じ問題で同じように外しているからです。
コードで差が出た Claude 側は、中身が「間違えた」ではありません。Fable 5.1 は答えが返った6回すべて、Opus 5 は10回すべてで正解しています。止まったのはどれもコード生成でした。全角の数字を半角へ直す関数、郵便番号を整える関数、例外の場合を含む集計の関数の3つです。書けたものは合っていて、書き切れなかった問いがあったということになります。
弱いのは「事実」全部ではなく料金だけだった 架空のモデル名は6つとも見抜いた
事実の正確さが9/18という数字は、ひとまとめに見ると「AIは事実に弱い」と読めてしまいます。中身を1問ずつ開くと、まったく違う姿になりました。
事実を問う6問の中身(6モデル×3回=18回ずつ)
| 聞いたこと | 正解した数 | 答え方 |
|---|---|---|
| 無料プランがあるか | 18/18 | 6つとも正しく答えた |
| 実在しないモデル名を説明させる | 18/18 | 6つとも「実在しない」と答えた |
| 単価から金額を出す | 18/18 | 6つとも小数点まで合っていた |
| 日本円の月額 | 0/18 | 7回は数字を答えて外し、11回は不明 |
| 自分の仕様 | 0/18 | 18回とも不明 |
| 他社の仕様 | 0/18 | 18回とも不明 |
分かれ方がきれいでした。料金と仕様を聞く3問だけが全滅で、それ以外の3問は6つとも満点です。9/18という数字は「半分できない」ではなく「特定の3問だけができない」という中身でした。

いちばん収穫だったのは、実在しないモデル名を説明させた問いです。「Claude Nimbus 7」という存在しない名前を出して中身を書かせたところ、6つとも「実在しない」と答えました。それらしい説明をでっち上げたモデルは1つもありません。GPT-6 Astra は「『Claude Nimbus 7』という公式モデルは確認できません」と返しました。Claude Opus 5 は実在しないと答えたうえで、Anthropic の正しいモデル名を並べています。
AIが知らないことを作って答える問題はよく指摘されます。ただ今回の実測では、はっきり存在しないものを差し出されたときは6つとも断りました。作り話が出やすいのは、実在するものについて細かい数字を聞いたときのほうです。
実務での使い分けはここで決まります。存在するかどうかの確認や、渡した数字の計算は任せられます。金額と細かい仕様だけは、そのまま聞かずに公式ページを見せて答えさせてください。
料金を聞くと当たらない 資料を渡すと当たる
事実の正確さで落ちた中身を開くと、落とし方まで同じでした。料金を聞いた3問です。
自分の仕様を聞いても、他社の仕様を聞いても、日本円の月額を聞いても、6つとも当てられませんでした。18回すべて外しています。
答え方には差がありました。ChatGPT の Go プランの月額を聞いた問いでは、GPT-5.6 Sol と Terra が1,500円と答えています。実際は1,400円なので100円高い数字です。一方で GPT-6 Astra は「不明」と答えました。前の世代が自信のある口ぶりで外した問いで、新しいモデルは知らないと言ったことになります。OpenAI は作り話をする割合が92%から51%へ下がったと公表していますが、この1問についてはそのとおりの動きでした。

4万字の資料を渡して同じことを聞いた
では、資料を渡せば当たるのか。ここも実際に試しました。
AInformation の AIツールデータベース から206本ぶんのデータを取り出して、4万1千字の資料にしました。そのうえで、この資料に書いてある月額を3か所たずねています。資料の前のほう・まん中・後ろのほうに1つずつ置きました。
ひとつ仕掛けをしてあります。3か所の金額を、実際の値とはわざと違う数字に書き換えました。記憶で答えれば実際の値になり、資料を読んでいれば書き換えた値になります。どちらを答えたかで、資料を読んだかどうかが機械で判定できます。
4万字の資料を渡して3か所を聞いた結果
| モデル | 前のほう | まん中 | 後ろのほう | 返るまで |
|---|---|---|---|---|
| GPT-6 Astra | 正解 | 正解 | 正解 | 2.32秒 |
| GPT-5.6 Sol | 正解 | 正解 | 正解 | 2.06秒 |
| GPT-5.6 Terra | 正解 | 正解 | 正解 | 1.65秒 |
| Claude Opus 5 | 正解 | 正解 | 正解 | 2.43秒 |
| Claude Sonnet 5 | 正解 | 正解 | 正解 | 1.59秒 |
| Claude Fable 5.1 | 正解 | 正解 | 正解 | 4.33秒 |
結果は6つとも全問正解でした。18回すべてで、書き換えたほうの値を答えています。覚えている値を答えたモデルは1つもありませんでした。4万字の資料の後ろのほうに置いた1つも、6つとも拾えています。

そのまま聞いたときと資料を渡したとき
| 聞き方 | 当たった数 | 外した内容 |
|---|---|---|
| そのまま料金を聞く | 0/18 | 6つとも3問すべて外した |
| 資料を渡して聞く | 18/18 | 外したモデルは無かった |
ここが今回いちばん実務に効く結果です。同じ6つのモデルが、そのまま聞くと18回すべて外し、資料を渡すと18回すべて当てました。料金や仕様を調べるときは、AIに聞くのではなく公式ページを貼って聞く。これだけで当たり方が変わります。
資料を20万字まで増やしても読み落ちはゼロだった
4万字で読めたなら、どこまで増やせるのか。GPT-6 Astra は一度に105万トークンを読めると説明されています。実際にどこまで正確に拾えるのかを、資料を伸ばしながら確かめました。
やり方は同じです。AInformation の公開記事をつないで長い資料を作り、その中の3か所に「ある道具の月額」を実際とは違う数字で書き込みました。位置は先頭に近いところ、まん中、いちばん後ろの3か所です。記憶で答えれば実際の値になり、資料を読んでいれば書き込んだ値になります。これを2万字・7万字・20万字の3段階で投げました。
資料を長くしたときに3か所を拾えるか
| 資料の長さ | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| 2万字 | 3か所とも正解(3.41秒) | 3か所とも正解(1.88秒) |
| 7万字 | 3か所とも正解(2.45秒) | 3か所とも正解(1.56秒) |
| 20万字 | 3か所とも正解(3.95秒) | 3か所とも正解(2.93秒) |
結果は全部正解でした。20万字を渡しても、3か所すべてを書き込んだとおりに答えています。いちばん後ろに置いた1か所も落としませんでした。読み飛ばしは起きていません。

もう1つ分かったのは待ち時間です。資料を2万字から20万字へ10倍にしても、答えが返るまでは0.54秒しか増えませんでした(3.41秒から3.95秒)。長い資料を渡すと待たされるという心配は、この範囲では要りませんでした。
ここでも Astra と Sol に差はありません。読める量も精度も同じで、違うのは秒数だけでした。
古い資料と新しい資料が混ざっていても日付で選べた
実務でもっと困るのは、読み落としより資料の中で情報が食い違っているときです。値上げ前の一覧と改訂後の一覧が両方フォルダに残っている、というのはよくある話だと思います。ここも試しました。
20万字の資料の10%あたりに「2025年10月1日版・月額4,800円」と書き、88%あたりに「2026年8月20日改訂・4,800円から12,600円へ改定」と書きました。2つは同じ道具の話で、金額が食い違っています。そのうえで「2026年9月の時点でいくらで経費申請すべきか」と聞きました。
結果は2つとも正解でした。GPT-6 Astra も GPT-5.6 Sol も「12,600円」と答え、根拠として2026年8月20日という日付を挙げています。20万字も離れた2か所を突き合わせて、日付の新しいほうを選んだことになります。
まとめると、長い資料を渡す使い方については前の世代のままで困りません。読み落としも起きず、食い違いがあれば日付で判断します。AIに料金を聞くと当たらないのに、料金の書いてある資料を渡せば当たる理由もここにあります。
6つとも自分の名前を答えられなかった
もう1つ、この記事のために測ったことがあります。AIは自分自身のことをどこまで答えられるのかです。6つのモデルへ4問ずつ、合わせて24問聞きました。
自分について4つ聞いた結果
| モデル | 名前を聞くと | 学習の締め切り | 新モデルを知るか |
|---|---|---|---|
| GPT-6 Astra | ChatGPT | 不明と回答 | 知らない |
| GPT-5.6 Sol | OpenAI o3 | 2024年6月 | 知らない |
| GPT-5.6 Terra | OpenAI o3 | 2024年6月 | 知らない |
| Claude Opus 5 | Claude Opus 4.1 | 2025年1月 | 知らない |
| Claude Sonnet 5 | Claude Sonnet 4.5 | 2024年6月 | 知らない |
| Claude Fable 5.1 | Claude | 2025年1月 | 知らない |
正式な名前を答えられたモデルは1つもありませんでした。GPT-6 Astra は「ChatGPT」と答えています。GPT-5.6 Sol と Terra はどちらも「OpenAI o3」、Claude Opus 5 は「Claude Opus 4.1」、Claude Sonnet 5 は「Claude Sonnet 4.5」でした。1つ前や2つ前の世代の名前を名乗っていることになります。

GPT-6 Astra について聞いた問いでは、6つとも「不明」が返りました。作り話は1つも出ていません。発表されたばかりの GPT-6 Astra 自身も、自分のことを知らないと答えています。学習データの締め切りが2026年4月30日で、発表の9月3日より前だからです。
知らないことを知らないと言えるかは、実務では点数より大事な性質です。この24問については6つとも正直でした。ただし名前のように「知っているつもりで外す」こともあります。AIに最新のモデル名や自分の仕様を聞いて、その答えをそのまま資料に書くのは避けたほうがよさそうです。
前の世代から変わったこと 変わらなかったこと
ここまでの実測をまとめます。

はっきり良くなったのは2つです。同じ答えを27%少ない量で出すようになったこと。そして前の世代が自信をもって外した問いで、知らないと答えるようになったことです。

公表された試験では大きく跳ね上がっているのに、日本語の実務25問では動きませんでした。どちらの数字も本物です。測っている中身が違うだけで、自分の使い方に近いのがどちらかを見て選ぶことになります。
変わらなかったのも2つあります。日本語25問の正解数は66問で前の世代と同じでした。事実を問う6問が半分どまりという弱点も、6つのモデルすべてで共通しています。文章を書く、日本語の指示に従う、集計する、といった仕事では差が出ませんでした。
OpenAI が公表した数字は本物だった ExploitBench は100%
提供が追いついていないからといって、中身が薄いわけではありません。公表された数値は実際に大きく伸びています。
特に目立つのが2つ。1つ目は ARC-AGI-3 で、前の世代の GPT-5.6 Sol が7.8%だったのに対して Astra は99.9%を記録しました。2つ目は ExploitBench で、攻撃の手順を組み立てられるかを測る試験です。ここで100%を取りました。前の世代は78.5%、Claude Opus 5 は70.0%です。
数学も伸びています。FrontierMath の Tier 4 という最上位の難度で97.6%。前の世代は83.0%でした。大学院レベルの理科を問う GPQA Diamond は96.0%です。
OpenAIが公表した主なベンチマーク(単位は正答率)
| 試験 | GPT-6 Astra | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|
| ARC-AGI-3 | 99.9% | 7.8% | 30.2% |
| ExploitBench(攻撃の検証) | 100% | 78.5% | 70.0% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 73.2% |
| GPQA Diamond(大学院級の理科) | 96.0% | 94.6% | 93.7% |
| ScreenSpot-Pro(画面の要素を指す) | 92.7% | 76.9% | — |
| SRE-Bench(障害対応) | 88.0% | — | 12.5% |
| OSWorld 2.0(PC操作) | 72.6% | 65.7% | 70.2% |
| Terminal-Bench 4.0 | 57.7% | 37.3% | 52.3% |
画面の操作まわりも大きく動きました。画面のどこを押すべきかを当てる ScreenSpot-Pro は92.7%で、前の世代の76.9%から16ポイント近く上がっています。PCの実作業を一通りやらせる OSWorld 2.0 は72.6%。前の世代は65.7%でした。しかも1つの課題にかかる時間が約75分から約40分へ縮んでいます。障害対応を測る SRE-Bench では88.0%を取り、Claude Opus 5 の12.5%を大きく引き離しました。
ハルシネーションも減っています。独立調査の Artificial Analysis によれば、知識系の試験で作り話をする割合が92%から51%へ下がりました。正答率も同時に4ポイント上がっています。
第三者の総合指数では前の世代と同じ61点だった
ところが、独立系の調査会社が同じ物差しで測ると景色が変わります。
Artificial Analysis が出している Intelligence Index の v4.1.1 で、GPT-6 Astra は61点でした。前の世代の GPT-5.6 Sol も61点です。つまり総合点は動いていません。1位は Claude Fable 5.1 の66点、2位が Claude Opus 5 の63点で、Astra は3番手に位置します。
この指数は9つの試験を合わせたものです。GDPval-AA v2、τ³-Banking、Terminal-Bench v2.1、SciCode、Humanity’s Last Exam、GPQA Diamond、CritPt、AA-Omniscience、AA-LCR の9本で構成されています。1つの試験の当たり外れに引きずられにくい作りです。

コーディング向けの Coding Agent Index では Astra が67点で、前の世代の65点を2点上回りました。ただしこちらも1位は Claude Fable 5.1 の70点です。
Artificial Analysis 自身も、Astra は同じ性能を出すのに使うトークンが減っている点を認めています。Coding Agent Index では前の世代より70%少ないトークンで走り、Intelligence Index でも約10%減りました。ただ開発者向けの単価が2.5倍になりました。トークンが減ったぶんを打ち消して、支払いに対する成果では前の世代を下回るという評価です。
得意な試験と横並びの試験がはっきり分かれている
公式の数字と第三者の数字が食い違っているように見えますが、どちらも正しい可能性があります。測っている中身が違うからです。
Astra が大きく引き離したのは、コンピュータ操作と安全検査です。ARC-AGI-3、ExploitBench、ScreenSpot-Pro、SRE-Bench はいずれもこの系統に入ります。ここでは前の世代に10倍以上の差をつけている試験もあります。

一方で、日々の仕事に近い課題ほど差が縮みます。実際のコードを直させる FrontierCode 1.1 Main は Astra が53.3%、Claude Fable 5.1 が53.5%、Claude Opus 5 が53.4%。3社が0.2ポイントの中に固まっています。コードの自動修正を測る DeepSWE v1.1 も Astra 74.1% に対して Claude Opus 5 が73.7%、Gemini 3.8 Flash が73.8%です。
道具を使ってよい条件の Humanity’s Last Exam では順位が入れ替わります。Astra の57.2%に対して Claude Opus 5 が63.6%、Claude Fable 5.1 が65.0%でした。
ARC-AGI-3 の99.9%はモデルだけの成果ではない
もう1つ気をつけたい点があります。ARC-AGI-3 のように長い手順を要する試験は、モデル単体の成績になりません。その周りの仕組みを含めた成績になります。実際に8月には NVIDIA が Claude Opus 5 を使う構成で ARC-AGI-3 の100%を達成しています。素の Claude Opus 5 は30.2%でした。同じモデルでも組み方しだいで70ポイント動くわけです。
Astra の99.9%も、比較対象と同じ条件で測ったものとは限りません。数字そのものを疑う必要はありませんが、他社との差をそのまま実力差と読むのは早いです。
どこで使えるか 無料プランには来ない
使える場所を整理します。ChatGPT なら Plus・Pro・Business・Enterprise の4つです。無料プランには来ません。有料プランを契約していれば追加の支払いは発生せず、いまの枠のまま使えます。Plus の人は、作業を任せる Work の画面と Codex で選びます。ふだんの会話の Chat の画面には出てきません(10月4日に AInformation編集部の Plus で確認)。Pro・Business・Enterprise は、Chat の画面でも「GPT-6 Pro」という名前で出ると説明されています。
GPT-6 Astra はどこで使えるか
| 使う場所 | 使えるか | 追加料金 |
|---|---|---|
| ChatGPT 無料プラン | × | — |
| ChatGPT Plus | ○(Work と Codex・上限あり) | なし |
| ChatGPT Pro | ○(Chat では GPT-6 Pro・上限を拡張) | なし |
| ChatGPT Business | ○(Chat では GPT-6 Pro) | なし |
| ChatGPT Enterprise | ○(Chat では GPT-6 Pro) | なし |
| 開発者向けのAPI | ○ | 使った分だけ |
開発者向けのAPIと Amazon の基盤からも呼べますが、こちらは使った分だけ支払う形です。自分でアプリを作る人以外は気にしなくてかまいません。
ここで大事なのは、どのルートでもいっせいに開放されるわけではないことです。OpenAI はまずサイバーセキュリティの審査を通った組織へ配り、そこから数日かけて ChatGPT の各プランへ広げると説明しています。実際に ChatGPT の全有料プランへ行き渡ったのは9月8日で、発表から5日後でした。

AInformation編集部の場合は9月4日にはまだ呼べず、翌5日に呼べるようになりました。およそ2日です。Plus で見つからないときは、Chat の画面のままになっていないかを見てください。Plus の人は Work の画面で選びます。
GPT-6 Astra の使い方 Plus は Work に切り替えてモデルの一覧から選ぶ
使いはじめる手順は難しくありません。ChatGPT の画面の上で「Work」に切り替えて、モデルの一覧から GPT-6 Astra を選ぶだけです。設定を変える必要も、申し込みも要りません。有料プランを契約していれば追加の支払いも発生しません。
順番は次のとおりです。
- ChatGPT に有料プランのアカウントでログインする
- 画面の上の切り替えで「Work」を押す
- 入力欄の右にあるモデル名のボタンを押し、メニューの「モデルを選択」を開く
- 一覧の GPT-6 Astra を選ぶ
大事なのは2つ目です。Plus の人は、GPT-6 を Work の画面でしか選べません。AInformation編集部が10月4日に Plus で開くと、Chat の画面のモデルは GPT-5.6 Sol と GPT-5.5 の2つだけでした。Pro・Business・Enterprise は、Chat の画面でも「GPT-6 Pro」という名前で選べると説明されています。配り始めのころは、発表された日と手元に届く日もずれていました。AInformation編集部の場合は開発者向けの窓口で9月4日に呼べず、翌5日に呼べるようになっています。ChatGPT の全有料プランへ行き渡ったのは9月8日です。
Work の画面でも出てこないときは、契約しているプランを見てください。料金ページの表では、無料版と Go の GPT-6 の欄は「—」です。プラン別の配られ方と、届くまでの利用枠の扱いは ChatGPT有料プランにGPT-6 Astraが追加料金なしで届く でまとめています。
自分でアプリを作る人は、開発者向けのAPIから gpt-6-astra という名前で呼べます。2026年9月5日の時点で呼べるのはこの1つだけです。処理を速くした gpt-6-astra-fast と短い名前の gpt-6 は、AInformation編集部が同じ日に試して呼べませんでした。9月22日には gpt-6-sol と gpt-6-luna が加わりました。29日には gpt-6.1-sol も呼べるようになっています。
使いはじめたあとのコツは1つです。料金や仕様を調べるときは、AIに聞かずに公式ページを貼って聞いてください。この記事の実測では、そのまま聞くと6つのモデルが18回すべて外しました。資料を渡すと同じ6つが18回すべて当てています。
コンピュータ操作は何が変わるのか
Astra の目玉は、人の代わりにPCの画面を操作する力です。OpenAI は「PCでできることはすべて代行できる」という言い方をしています。
具体的には、ウェブのフォームに入力する、顧客管理システムの中身を更新する、カレンダーを整理する、調べた内容を要約する、ソフトを入れて動作を確かめる、といった作業が対象です。人が画面の前でやっていることを、そのまま任せる方向を目指しています。
数字で見ると、画面の要素を正しく指せるかを測る ScreenSpot-Pro が92.7%。PCの実作業をやらせる OSWorld 2.0 が72.6%です。7割強なので、任せきりにできる水準ではありません。10回に3回は失敗する前提で組む必要があります。
だからこそ、任せる作業は取り消せるものから始めるのが安全です。下書きを作る、候補を並べる、確認用の一覧を出す、といった仕事なら間違っていても戻せます。送信、決済、削除のように後戻りできない操作は、人が最後に押す形を残しておいてください。
サイバーセキュリティが「Critical」になった意味
今回の発表でもう1つ大きいのが、OpenAI が Astra をサイバーセキュリティの分野で「Critical」と判定したことです。同社の基準でこの区分に入ったモデルは初めてです。
OpenAI の説明はこうです。適切な道具と権限があれば、まだ知られていない脆弱性を自分で見つけられる。しかも人が手順を教えなくても悪用の道筋まで組み立てられる水準だとしています。評価の過程で実際に未知の脆弱性を2件見つけたことも公表されました。
そのため、攻撃コードを作る機能は Daybreak という審査つきの枠組みの後ろに置かれています。誰でも自由に使える状態にはなっていません。先に配られているのも、この審査を通った組織です。
安全面で改善した数字も出ています。外部から紛れ込ませた指示にだまされる割合は27.0%から8.5%へ下がりました。決められた権限をはみ出す動きも減りました。仕掛けておいた罠に前の世代が55.4%の割合で手を出したのに対して、Astra は1度も手を出していません。Codex の利用で見つかった重い逸脱も53%減ったとしています。
ただし OpenAI の主任研究者ヤクブ・パチョツキ氏は「知能が進んでも、意図に沿わせることが同じだけ進むとは限らない」と述べています。同社は別の懸念も認めています。モデルが賢くなるほど少ない手数で仕事を終えるので、思考の過程を人が見張りにくくなるという点です。
AGI と言えるのか 測るはずの GDPval が出ていない
ブロックマン氏は「世代を超えた飛躍」と表現し、AGI の到来と受け取られてもおかしくないと述べました。「個人的には、もう到達していると思う」とも語っています。同時に「AGI の定義は人によって違う」とも認めていて、明確な線引きを主張しているわけではありません。
気になるのは、今回の発表資料に GDPval が入っていないことです。GDPval は OpenAI 自身が2025年に作った物差しです。44の職種・1,320の課題を使い、実際の仕事の成果物が経験のある人と比べてどうかを測ります。経済的な価値で AGI を測るという発想そのものです。
AGI を語る発表で、AGI を測るために作った指標が出てこない。ここは読者が自分で判断する材料として押さえておく価値があります。Artificial Analysis の総合指数に含まれる GDPval-AA v2 の部分では、Astra の点が大きく下がったという指摘もあります。
実務の目線で言えば、AGI かどうかの線引きは後回しでかまいません。自分の仕事のどこを任せられるかのほうが大事です。今回の数字を見るかぎり、画面の操作と安全検査では確かに一段上がりました。文章を書く、事実を調べる、日本語で正確に指示に従う、といった仕事では前の世代と大きく変わっていません。
いまやっておくとよいこと
今回の実測から、すぐにできて効くことを4つにまとめます。

1つ目は、自分のアカウントで選べるかを先に見ることです。発表された日と手元に来る日は別だと、今回の2日の差がそのまま示しています。記事や告知を読んで判断する前に、ChatGPT なら Work の画面のモデルの切替を開いてください。
2つ目は、下のモデルで1週間試してから決めることです。どのモデルが自分の用途に合うかは AIツールデータベース でも絞り込めます。AInformation編集部の実測では、いちばん安い GPT-5.6 Terra が新しい最上位と同じ66問でした。しかも1.5倍速く返ります。日本語の定型業務なら、上位のモデルを選ぶ意味が薄いかもしれません。
3つ目は、料金や仕様をAIに聞かず、公式ページを貼って聞くことです。そのまま聞くと6つとも18回すべて外しました。4万字の資料を渡すと、同じ6つが18回すべて当てています。聞き方だけで結果が変わります。
4つ目は、任せる作業を取り消せるものから始めることです。コンピュータ操作の成功率は7割強にとどまります。失敗した時に戻せるかどうかで、導入の速さが変わります。
新しいモデルが出ると乗り換えを急ぎたくなりますが、まず自分のアカウントで選べるかを見てください。発表と提供は別です。今回も手元で呼べるようになるまで2日かかりました。そのうえで、いまの仕事に最上位が本当に要るのかを測ってほしい。AInformation編集部の実測では、いちばん安い GPT-5.6 Terra が新しい最上位と同じ66問正解でした。しかも1.5倍速く返ります。値段の高いモデルが日本語の実務で強いとは限りません。
- GPT-6とは何ですか。
- OpenAIが2026年9月から出しているAIモデルの系統の名前です。1つのモデルではありません。いちばん賢いGPT-6 Astraと仕事向けのGPT-6 Sol、いちばん安いGPT-6 Lunaの3つに分かれます。最初に出たのは9月3日のAstraです。9月22日にSolとLunaが加わり、29日にSolの改良版のGPT-6.1 Solが出ました。どれも一度に1,050,000トークンまで読めます。
- GPT-6 Astra・Sol・Lunaの違いは何ですか。
- 賢さと速さと値段が違います。開発者向けの単価はAstraを1とすると、6.1 SolとSolが5分の1でLunaは100分の1です。OpenAIのモデルガイドは、いちばん難しい推論にAstraをすすめています。込み入ったコーディングや調べものと画面の操作には6.1 Solです。請求書の抜き出しのような決まった形の仕事を大量に回すならLunaです。AInformation編集部が10月3日に試すと、請求書と問い合わせの振り分けはLunaもAstraも全問正解でした。
- GPT-6.1 Solは何が変わりましたか。
- 9月22日に出たGPT-6 Solの改良版で、9月29日に出ました。単価は前のSolと同じで、Astraの5分の1です。OpenAIによると、考える量を少なくしたときに事実の誤りを含む答えが11.4%から7.7%に減りました。AInformation編集部が9月30日に日本語の4つの仕事を10回ずつ頼むと、6.1 Solは平均2.81秒でAstraの4.44秒より速く終わりました。
- GPT-6.1 Astraはいつ出ますか。
- 出る日は決まっていません。10月に予定していた公開は取りやめになりました。米国時間の9月28日にウォール・ストリート・ジャーナルが報じ、OpenAIの安全の責任者は社内の安全の基準に届かなかったと説明しています。やったことを正直に伝えない場合がある点と、許可を取らずに作業を進める点が問題とされました。当面の最上位はGPT-6 Astraです。
- GPT-6は無料で使えますか。
- ChatGPTの料金ページ(2026年10月4日)では、無料版とGoのGPT-6の欄は4つとも「—」です。使えるのはPlus以上になります。ただし9月22日の発表には、無料版とGoの人もデスクトップアプリでGPT-6 Lunaを使えると書かれています。無料で試すなら、デスクトップアプリのWorkを開いてLunaが選べるかを見てください。
- ChatGPTでGPT-6を使うにはどのプランが必要ですか。
- Plus、Pro、Business、Enterprise、Eduのどれかです。追加の料金はかかりません。料金ページの比べ表では、PlusはGPT-6の4つとも「上限あり」でProは「拡張」です。PlusはWorkの画面で選びます。Proは特典に「GPT-6 Astra による Pro 推論」が並び、たくさん使うならProのほうが枠が広くなります。
- ChatGPTの画面でGPT-6が選べないのはなぜですか。
- Plusでは、GPT-6はふだんの会話の「Chat」の画面に出ないからです。作業を任せる「Work」の画面で選びます。AInformation編集部が10月4日にPlusで確かめると、ChatのモデルはGPT-5.6 SolとGPT-5.5の2つだけでした。上の切り替えでWorkを押し、入力欄の右のボタンから「モデルを選択」を開くとGPT-6の4つが並びます。Proは料金ページの特典に「GPT-6 Astra による Pro 推論」が並んでいます。無料版とGoは、料金ページの表ではGPT-6の欄が「—」です。
- GPT-6はいつ出ましたか。
- 最初のGPT-6 Astraは2026年9月3日に発表されました。まず一部の組織に配られ、9月8日にChatGPTの全有料プランへ行き渡っています。9月22日にGPT-6 SolとGPT-6 Luna、9月29日にGPT-6.1 Solが出ました。同じ版のGPT-6.1 Astraは、10月の公開を取りやめています。
- GPT-6は3つで値段がどれくらい違いますか。
- 開発者向けの単価は、Astraを1とすると6.1 SolとSolが5分の1でLunaは100分の1です。前の世代と比べると、SolとLunaは半額になりました。Astraだけは前の世代のGPT-5.6 Solより2.5倍高い単価です。ChatGPTの月額で使う人は、どれを選んでも追加の料金はかかりません。
- GPT-6はどれを選べばいいですか。
- 迷ったらGPT-6.1 Solから始めるのが無難です。Astraに近い出来で、値段は5分の1です。AInformation編集部の実測では、日本語の4つの仕事で6.1 SolもAstraも40回すべて合格しました。速く終わったのは6.1 Solのほうです。決まった形の仕事を大量に回すならLunaへ下げ、6.1 Solで足りない難しい仕事だけをAstraに回してください。
- GPT-6 Astra と GPT-5.6 Sol はどこが違いますか。
- 仕様の面ではほとんど同じです。一度に読める量はどちらも1,050,000トークン、一度に書ける量はどちらも128,000トークンでした。違うのは学習データの締め切りで、Solが2026年2月16日、Astraが4月30日です。性能はAInformationが日本語25問を3回ずつ投げたところ、どちらも75回中66回で同じでした。公表された試験ではARC-AGI-3が7.8%から99.9%へ、OSWorld 2.0が65.7%から72.6%へ上がっています。
- GPT-6 Astra は前の世代よりどれくらい賢いですか。
- 試験によって差が大きく違います。画面を操作する力や安全検査ではARC-AGI-3が7.8%から99.9%へ、ExploitBenchが78.5%から100%へ跳ね上がりました。一方でAInformationが日本語の実務25問を3回ずつ投げたところ、GPT-6 Astraは75回中66回で、前の世代のGPT-5.6 Solとまったく同じでした。第三者のArtificial Analysis Intelligence Index v4.1.1も61点で前の世代と同じです。どの試験を見るかで印象が変わります。
- GPT-6 Astra は前の世代より速いですか。
- AInformationの実測では遅くなりました。同じ25問を3回ずつ投げたときの中央値は、GPT-6 Astraが2.94秒、前の世代のGPT-5.6 Solが2.41秒です。いちばん安いGPT-5.6 Terraは1.89秒で、Astraとの差は1.05秒でした。ただし答えを出すのに使った量はAstraがいちばん少なく、Solの73%で済んでいます。
- GPT-6 Astra はどれくらいの長さの資料まで正しく読めますか。
- AInformationが20万字まで試したところ、読み落としは起きませんでした。資料の3か所に実際とは違う金額を書き込み、2万字・7万字・20万字の3段階で投げています。GPT-6 Astraも前の世代のGPT-5.6 Solも、3段階すべてで3か所とも書き込んだとおりに答えました。資料を10倍にしても答えが返るまでは0.54秒しか増えていません。20万字は原稿用紙でおよそ500枚で、Astraが読める上限のおよそ13%にあたります。
- AIに料金や仕様を聞けば答えてくれますか。
- そのまま聞くと当たりません。AInformationが6つのモデルへ料金を3問ずつ聞いたところ、18回すべて外しました。GPT-5.6 SolとTerraはChatGPT Goの月額を1,500円と答えましたが、実際は1,400円です。ところが4万字の資料を渡して同じことを聞くと、6つとも18回すべて正解しました。料金や仕様を調べるときは、AIに聞くのではなく公式ページを貼って聞いてください。
- GPT-6 Astra とClaudeはどちらが上ですか。
- 分野で分かれます。Artificial Analysisの総合指数はClaude Fable 5.1が66点で1位、Astraは61点です。反対にコンピュータ操作のScreenSpot-ProはAstraが92.7%でClaude Fable 5の87.3%より上でした。AInformationが日本語25問を投げた実測では、Astraが75回中66回、Claude Opus 5が70回中61回、Claude Fable 5.1が66回中55回です。用途で選び分けるのが実際的です。
- AIに架空のサービス名を聞くと、それらしい説明を作ってしまいますか。
- AInformationの実測では作りませんでした。存在しない「Claude Nimbus 7」というモデル名を出して中身を説明させたところ、6つのモデルすべてが「実在しない」と答えています。GPT-6 Astraは「確認できません」と返し、Claude Opus 5は実在しないと答えたうえで正しいモデル名を並べました。ただし実在するものについて細かい数字を聞くと外します。同じ6モデルが料金を聞く3問で18回すべて間違えました。
- GPT-6 Astra にパソコンの操作を任せて大丈夫ですか。
- 任せきりにはできません。PCの実作業をやらせるOSWorld 2.0でのOpenAIの公表値は72.6%です。10回に3回は失敗する前提で組む必要があります。始めるなら取り消せる作業からにしてください。下書きを作る、候補を並べる、確認用の一覧を出す、といった仕事なら間違っていても戻せます。送信や決済や削除のように後戻りできない操作は、人が最後に押す形を残しておくのが安全です。
- サイバーセキュリティで「Critical」と判定されたのは危ないという意味ですか。
- モデルの能力が高いという判定で、使う人にとって危険という意味ではありません。OpenAIの基準でこの区分に入った初めてのモデルです。適切な道具と権限があれば、まだ知られていない脆弱性を自分で見つけて悪用の道筋まで組み立てられる水準だとしています。そのため攻撃コードを作る機能はDaybreakという審査つきの枠組みの後ろに置かれ、誰でも使える状態にはなっていません。外部から紛れ込ませた指示にだまされる割合は27.0%から8.5%へ下がっています。
- OpenAI GPT-6 Astra モデルページ
- OpenAI API 料金ページ
- GPT-6 Astra System Card(OpenAI)
- Artificial Analysis Intelligence Index v4.1.1
- Benchmarking GPT-6 Astra(Artificial Analysis)
- AInformation 独自ベンチマーク
- GPT-6 ファミリーのモデルガイド(OpenAI)
- GPT-6 Sol と Luna のご紹介(OpenAI)
- GPT-6.1 Sol のご紹介(OpenAI)
- OpenAI GPT-6 Sol モデルページ
- OpenAI GPT-6 Luna モデルページ
- OpenAI GPT-6.1 Sol モデルページ
- ChatGPT の料金(OpenAI)
この記事の更新について
- 本文の最終更新
- 2026年10月4日
- 2026年10月4日本文を更新GPT-6の系統(Astra・Sol・Luna・6.1)の柱にした。「GPT-6とは」「Astra・Sol・Lunaの違い」「ChatGPTで使える場所」「GPT-6.1で何が変わったか」「9月3日からの年表」の5章と、よくある質問の先頭10問を足した。題を系統の問いの形にした
- 2026年10月4日表記を修正上部(この記事で分かることの直後)に ChatGPT の実画面の解説動画(76秒・音声あり)を足した