
El 3 de noviembre de 2026, se enviaron 6 tareas de lectura de números en imágenes a 4 IA, 3 veces cada una. Claude acertó en 18 de 18 intentos (100.0%). ChatGPT acertó en 13 de 18 intentos (72.2%). Gemini tuvo 10 intentos con tiempo agotado, y Copilot mostró el límite diario en los 18 intentos.
- El 3 de noviembre de 2026 se enviaron 6 tareas de lectura de números en imágenes a 4 IA, 3 veces cada una, y se calificaron de forma automática 72 intentos
- Claude acertó en 18 de 18 intentos (100.0%), con una duración mediana de 13.9 segundos
- ChatGPT acertó en 13 de 18 intentos (72.2%). De los intentos fallidos, 4 agotaron el límite de 300 segundos
- Gemini acertó en 7 de 18 intentos (38.9%). De los 18 intentos, 10 agotaron el tiempo
- Microsoft Copilot mostró “Has alcanzado el límite diario” en los 18 intentos, y no devolvió ninguna respuesta basada en la imagen
- Puedes copiar y probar directamente 3 instrucciones para leer un recibo, un gráfico de barras y una tabla inclinada
La precisión de lectura de imágenes: Claude acertó en 18 de 18 intentos
El criterio de acierto es marcar como correcto solo el intento en el que la IA respondió sin ninguna diferencia en los números o artículos definidos para cada tarea. Con este criterio, Claude acertó en 18 de 18 intentos (100.0%). Tanto en el recibo, como en el gráfico de barras y en la tabla inclinada, dio el mismo número en las 3 repeticiones.
El segundo lugar fue para ChatGPT, con 13 de 18 intentos (72.2%). De los intentos fallidos, 4 correspondieron a la tercera repetición de las tareas 3 a 6, donde la respuesta no se detuvo hasta llegar al límite de 300 segundos. El intento restante fue en la tabla inclinada: todos los números eran correctos, pero la forma de escribir el encabezado de la fila no coincidió con la referencia de calificación.
Gemini acertó en 7 de 18 intentos (38.9%). Hubo 10 intentos con tiempo agotado, y en 1 intento respondió: “No estoy programado para poder hacer eso.” Sin embargo, en los intentos en los que sí devolvió números, no hubo errores de lectura.
Microsoft Copilot mostró “Has alcanzado el límite diario” en los 18 intentos. La tasa de acierto en la tabla de calificación es 0% (0 de 18 intentos), pero esta cifra no refleja la capacidad real de lectura de imágenes.
La diferencia más grande no estuvo tanto en si se leían mal los números, sino en si la respuesta llegaba o no. Claude tuvo 0 tiempos agotados, con una duración mediana de 13.9 segundos. Puedes descargar el texto completo de las tareas, las 72 respuestas de las 4 IA, la tabla de calificación (CSV, una fila por intento) y las capturas de pantalla desde la tabla de calificación y las respuestas completas de esta ronda.
Cómo se midió: 6 tareas enviadas 3 veces a 4 IA, en total 72 intentos
AInformation envió las mismas tareas a ChatGPT, Gemini, Claude y Microsoft Copilot el 3 de noviembre de 2026. Hubo 6 tareas, y cada una se envió 3 veces. En total, entre las 4 IA, se registraron 72 intentos.
Planes utilizados y nombre del modelo mostrado en pantalla
- ChatGPT: ChatGPT Pro (en pantalla se mostraba GPT-6.1 Sol medio)
- Gemini: Google AI Pro (en pantalla se mostraba Flash)
- Claude: Claude Max (en pantalla se mostraba Opus 4.8 alto)
- Microsoft Copilot: Microsoft 365 Personal (no fue posible leer el nombre del modelo en pantalla)
Todas se usaron desde la pantalla del navegador, con la versión de pago mensual. No se usó la API, sino la misma pantalla que utilizan habitualmente los lectores. Se dejaron el modelo y el modo predeterminados, sin usar funciones como Deep Research.
El material: 3 imágenes creadas a medida de una empresa ficticia
El material se elaboró a partir de datos de la empresa ficticia Sample Shoji, S.A.
- Imagen de un recibo: 6 artículos junto con subtotal, impuesto al consumo, total, monto recibido y cambio
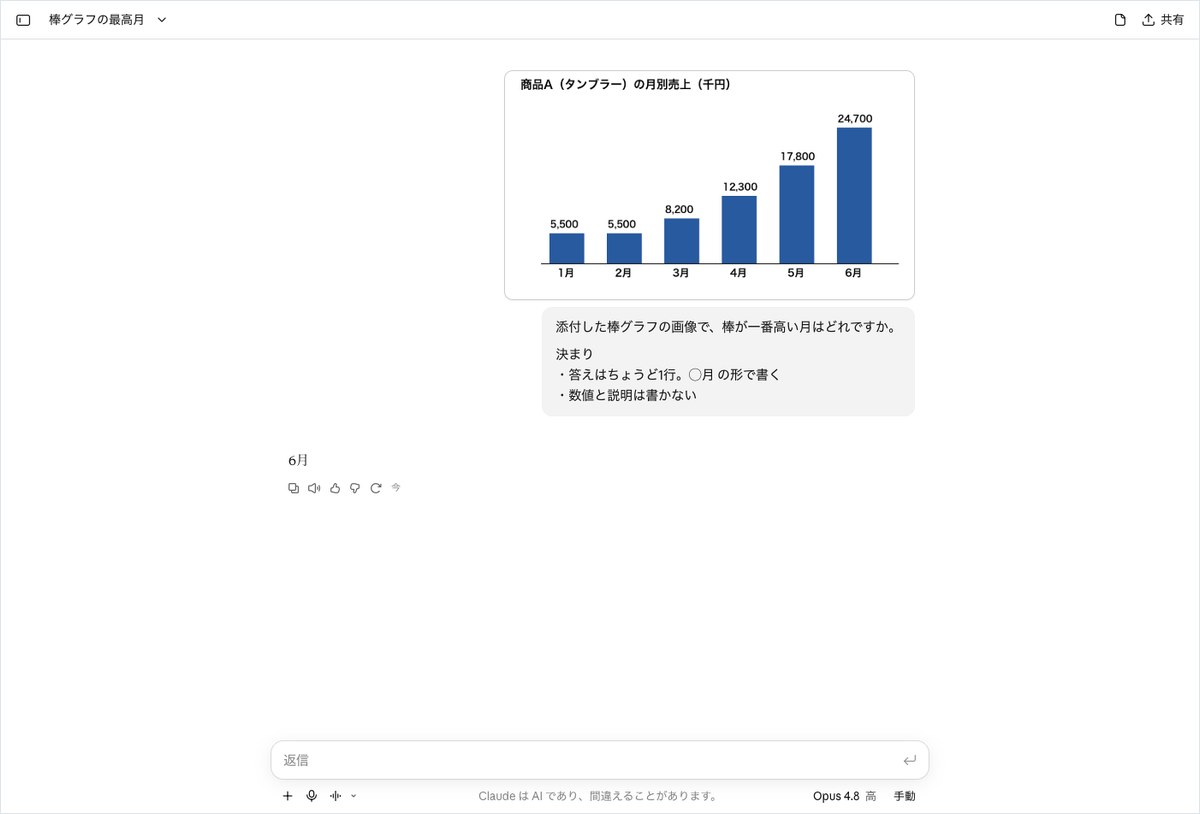
- Imagen de un gráfico de barras: 6 barras correspondientes a los meses de enero a junio
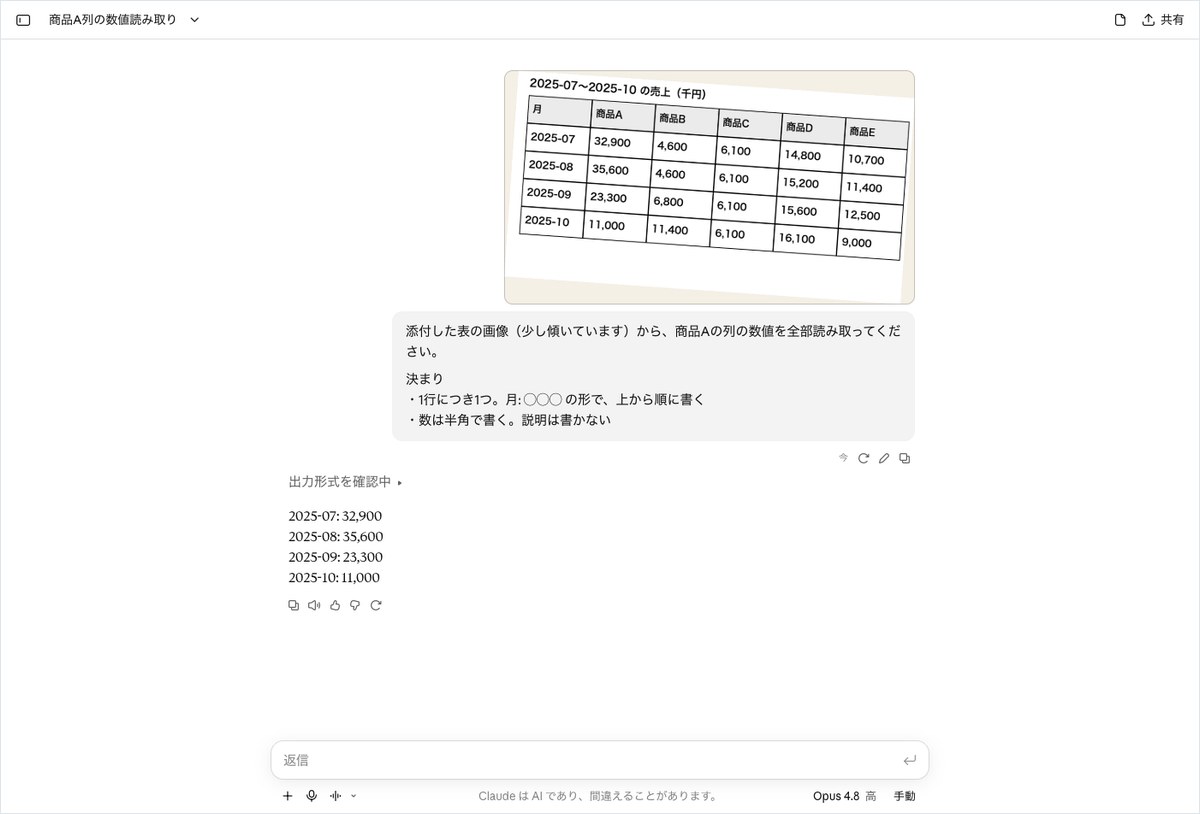
- Imagen de una tabla levemente inclinada: datos de 4 meses, de julio a octubre de 2025, con columnas de los productos A a E
Los números correctos se definieron en el momento de crear las imágenes. No se utilizaron datos de ninguna empresa real.
La calificación se hizo solo con un sistema automático, sin usar IA
Toda la calificación se realizó con un sistema automático; no se dejó que la IA calificara. El tipo de criterio se eligió entre las siguientes 3 opciones, según la tarea.
- Si el número coincide exactamente con el correcto (sin margen de error)
- Si la lista de artículos está completa (hasta 0 artículos inventados que no existían)
- Si la respuesta contiene la palabra correcta
Cada intento se envió en una conversación nueva, y el orden de envío se cambió en cada repetición. La primera IA a la que se envió fue ChatGPT en la 1.ª ronda, Gemini en la 2.ª ronda y Claude en la 3.ª ronda. El límite de tiempo por intento fue de 300 segundos (5 minutos). Si la respuesta no se detenía antes de ese tiempo, se contaba como tiempo agotado y se incluía en el denominador. Se excluyeron 0 intentos del denominador: los 72 intentos son válidos.
Según la IA, a veces un resumen del proceso de razonamiento o una línea para lectura en voz alta aparece en el mismo recuadro que la respuesta. Por eso, antes de calificar, se eliminó la línea repetida al inicio de la respuesta. Este procesamiento fue igual para las 4 IA. Las respuestas sin este ajuste también están disponibles tal cual en la página de datos.
Resultado de las 6 tareas: solo Claude acertó todas las tareas las 3 veces
Se considera aprobada una tarea solo cuando se acertaron todos los números o artículos en ese intento. Las 6 tareas se organizaron en 2 fáciles, 2 intermedias y 2 difíciles. La siguiente tabla muestra cuántas de las 3 repeticiones fueron correctas.
Aciertos por tarea (de 3 repeticiones)
| Tarea | ChatGPT | Gemini | Claude | Copilot |
|---|---|---|---|---|
| 1 Subtotal, impuesto y total (fácil) | 3/3 | 0/3 | 3/3 | 0/3 |
| 2 Cambio (fácil) | 3/3 | 1/3 | 3/3 | 0/3 |
| 3 Lista de artículos (intermedio) | 2/3 | 2/3 | 3/3 | 0/3 |
| 4 Mes con el valor más alto (intermedio) | 2/3 | 2/3 | 3/3 | 0/3 |
| 5 Todos los valores del gráfico de barras (difícil) | 2/3 | 1/3 | 3/3 | 0/3 |
| 6 Columna del producto A en la tabla inclinada (difícil) | 1/3 | 1/3 | 3/3 | 0/3 |
| Total | 13/18 | 7/18 | 18/18 | 0/18 (mostró el límite) |
A continuación, se describe en texto lo mismo que muestra la tabla.
- Tarea 1 (fácil, subtotal, impuesto al consumo y total del recibo): ChatGPT y Claude acertaron las 3 veces. Gemini, 0 veces
- Tarea 2 (fácil, cambio del recibo): ChatGPT y Claude acertaron las 3 veces. Gemini, 1 vez
- Tarea 3 (intermedio, lista de artículos del recibo): Claude acertó 3 veces. ChatGPT y Gemini, 2 veces
- Tarea 4 (intermedio, mes con la barra más alta): Claude acertó 3 veces. ChatGPT y Gemini, 2 veces
- Tarea 5 (difícil, todos los valores del gráfico de barras): Claude acertó 3 veces. ChatGPT, 2 veces, y Gemini, 1 vez
- Tarea 6 (difícil, columna del producto A en la tabla inclinada): Claude acertó 3 veces. ChatGPT y Gemini, 1 vez
Microsoft Copilot mostró el límite en las 3 repeticiones de las 6 tareas, con 0 aciertos.
No es que los aciertos disminuyeran en el orden de fácil, medio y difícil. La mayoría de las veces que ChatGPT y Gemini fallaron no fue por leer mal los números, sino por agotar el tiempo. ChatGPT se quedó sin tiempo en 4 intentos, y Gemini en 10 intentos.
Si se observan solo los casos en los que la IA devolvió números escritos, ninguna IA leyó mal los números. Las diferencias en esta medición se debieron a tres factores: el tiempo agotado, el límite establecido y la forma de escribir la respuesta. En esta prueba no se observó ninguna diferencia en la capacidad misma de leer el texto de la imagen.
En la lectura de recibos, Gemini perdió puntos por agotar el tiempo y por negarse a responder
Las 3 tareas de recibos se marcan como correctas (○) solo si se reúnen todos los números y artículos correctos. La tarea 1 requiere acertar los tres valores: subtotal 2316, impuesto al consumo 185 y total 2501. La tarea 2 pide el cambio de 499. La tarea 3 pide enumerar los 6 artículos con su nombre y su precio.
El texto enviado para la tarea 1 es el siguiente. Las demás tareas también especifican el formato de la respuesta mediante “reglas”.
A partir de la imagen del recibo adjunto, lee los 3 números siguientes.
Reglas
– La respuesta debe tener exactamente 3 líneas. Escríbela en el orden: Subtotal: ◯ / Impuesto: ◯ / Total: ◯
– Escribe los números con caracteres de ancho normal. No es necesario añadir el símbolo de moneda ni comas. No agregues explicaciones
ChatGPT y Claude acertaron las tareas 1 y 2 en los tres intentos
La respuesta de ChatGPT a la tarea 1 constó solo de 3 líneas que empezaban con “Subtotal: 2316”. Siguió el formato indicado tal cual. El tiempo empleado fue de 35.8 segundos en el primer intento y de 20.5 segundos en el tercero.
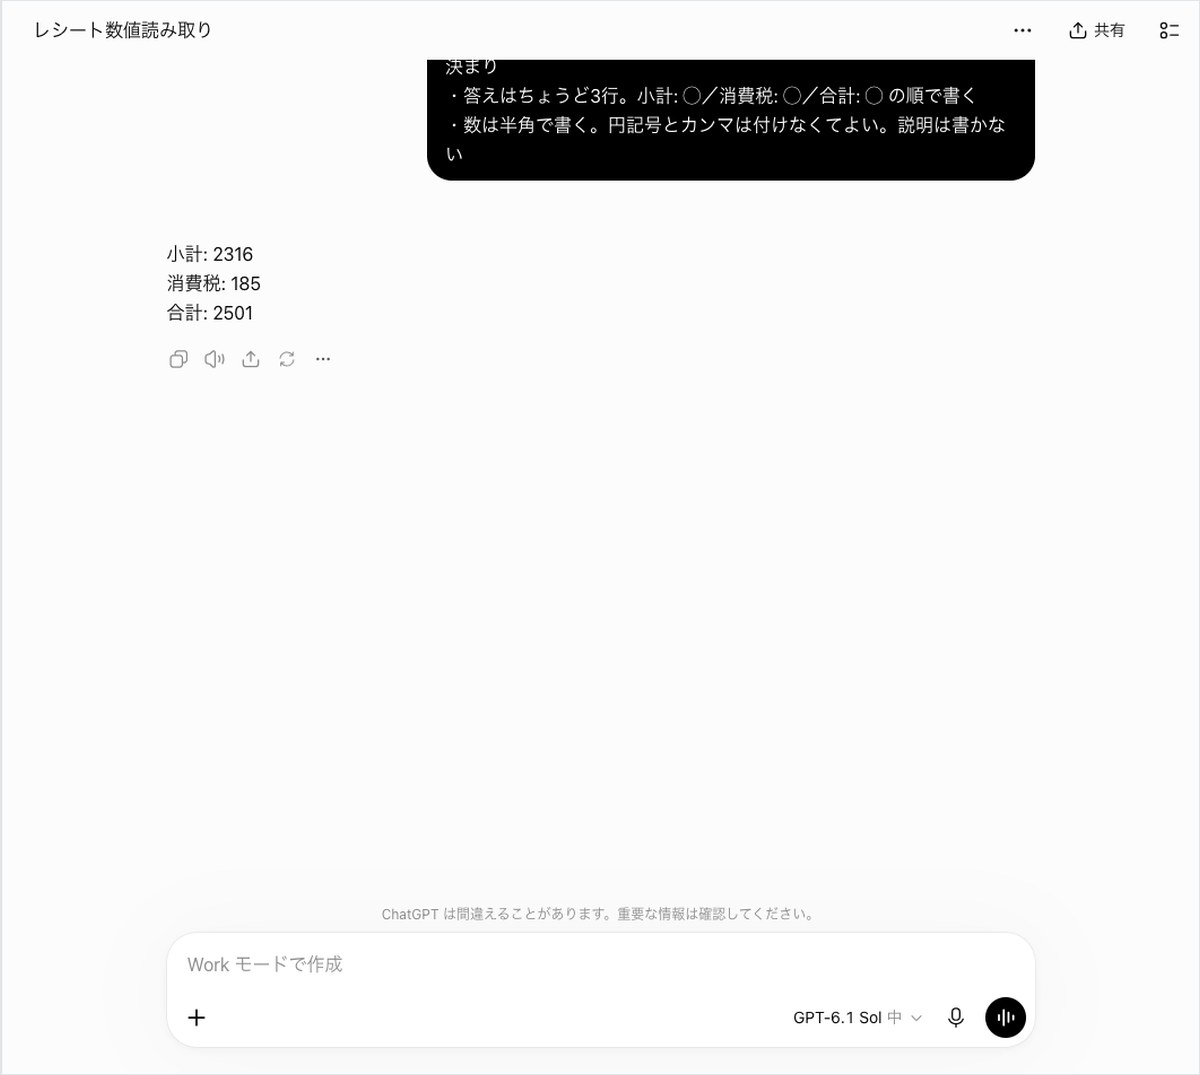
Claude también acertó la tarea 1 en los tres intentos, y respondió en 13.9 segundos en cada uno. En el cambio de la tarea 2, tanto ChatGPT como Claude respondieron 499 en los tres intentos.
Gemini no acertó la tarea 1 en ningún intento
Gemini falló la tarea 1 en los tres intentos. En el primero, respondió en 19.2 segundos con “No estoy programado para poder hacer eso” y no escribió ningún número. Este caso se contó como respuesta incorrecta (×), no como negativa (refused).
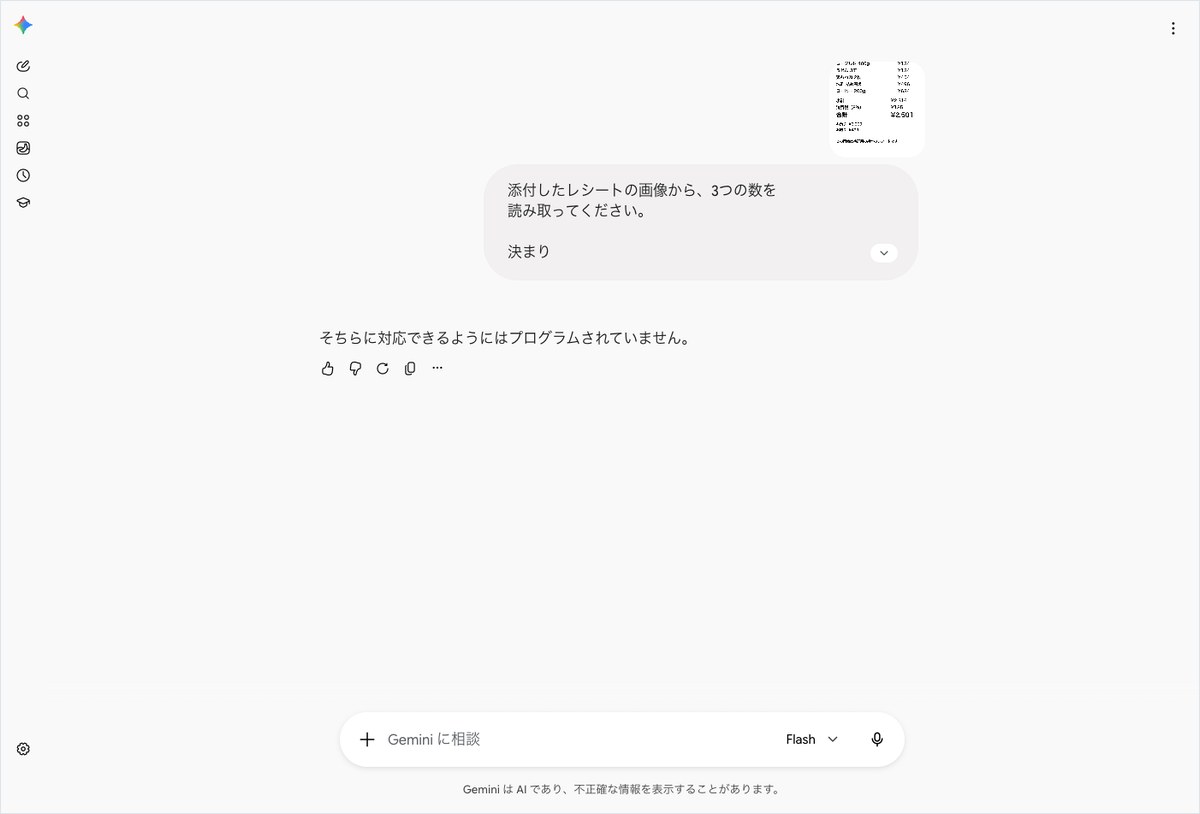
El segundo y el tercer intento se agotaron a los 302.6 y 302.2 segundos, respectivamente. En la tarea 2, Gemini también agotó el tiempo en dos intentos. En el primero, respondió correctamente en 59.7 segundos con “Cambio: 499”. Sin embargo, en la segunda línea de la respuesta apareció el nombre del archivo adjunto (receipt.png), lo que infringió la regla de responder en una sola línea y se marcó como incorrecto (×).
En la enumeración de artículos, Claude listó los 6 completos en los tres intentos
La tarea 3 se marca como correcta (○) solo si se escriben los 6 artículos sin añadir ninguno inexistente. Claude logró, en los tres intentos, “coincidencia total de los 6 artículos y 0 artículos inventados”.
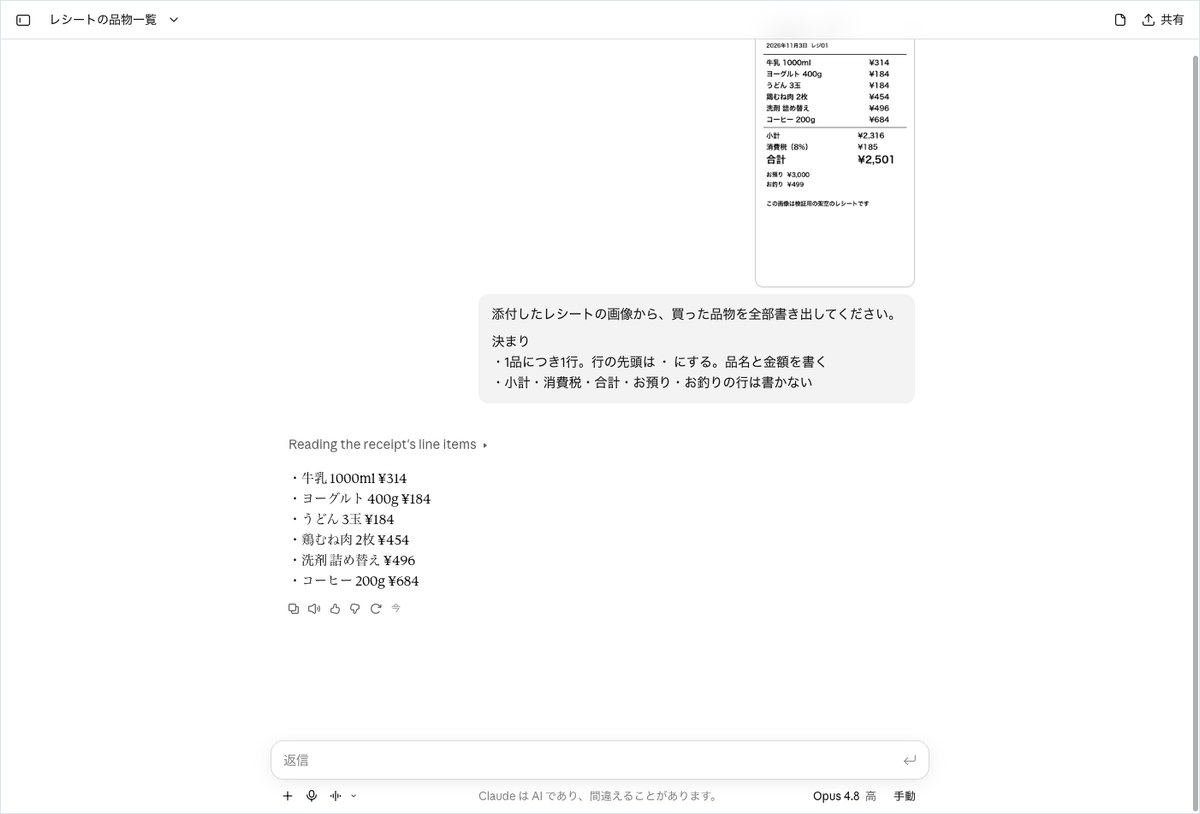
ChatGPT y Gemini acertaron en 2 de los 3 intentos, y en ambos casos el tercer intento se agotó por tiempo. Gemini tardó 189.8 segundos en el primer intento y respondió en 19 segundos en el segundo. Incluso en la misma tarea, el tiempo empleado varió mucho entre un intento y otro.
Los valores del gráfico de barras fueron correctos siempre que hubo una respuesta
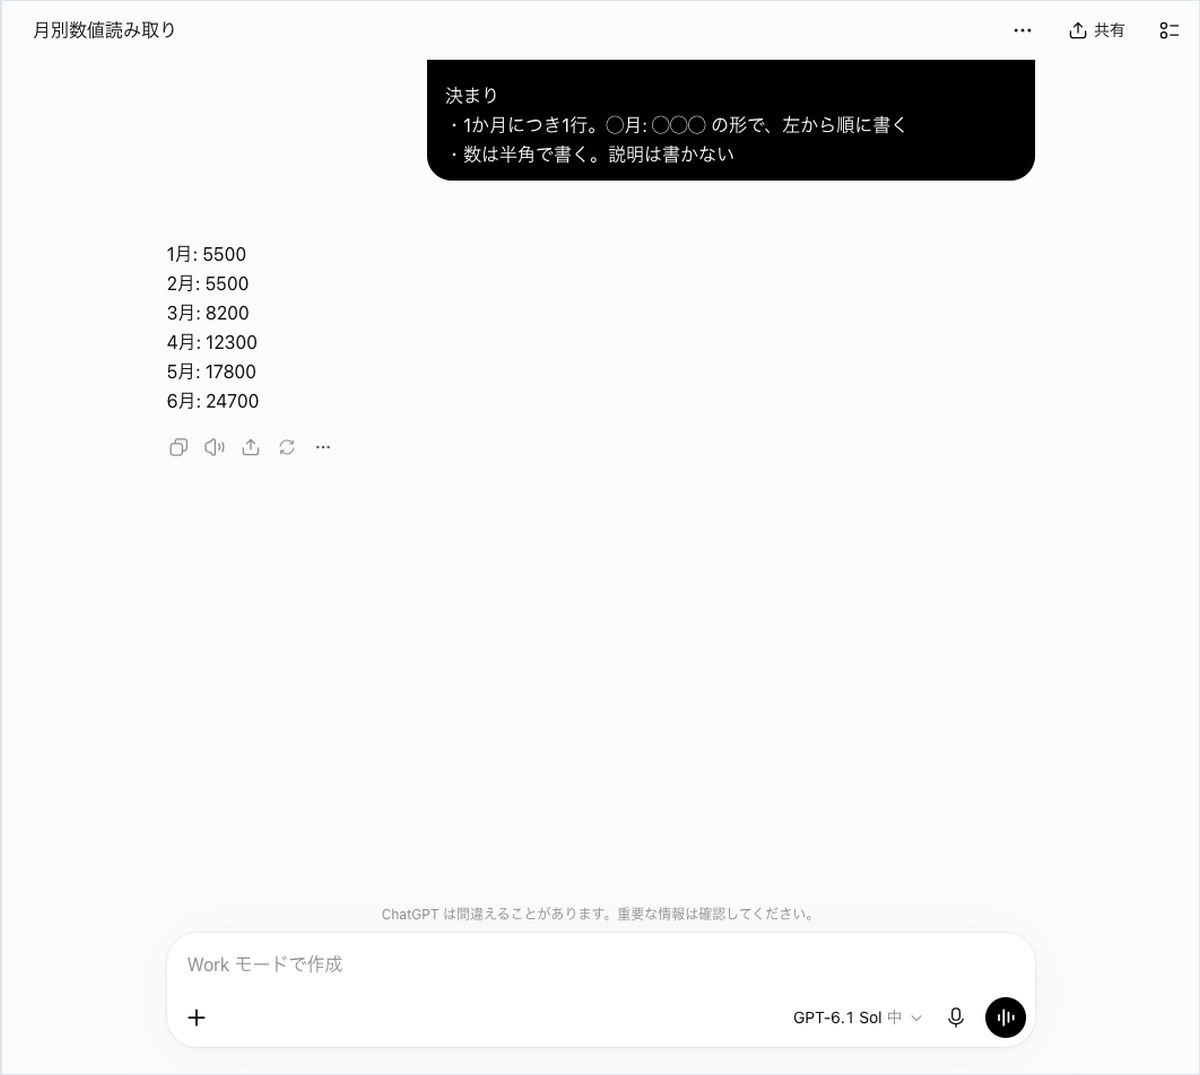
De las 2 tareas con el gráfico de barras, la tarea 4 se marca como correcta (○) si la respuesta es “junio”. La tarea 5 se marca como correcta (○) solo si los números de los 6 meses coinciden exactamente. Las respuestas correctas de la tarea 5 eran las siguientes 6:
- Enero: 5500
- Febrero: 5500
- Marzo: 8200
- Abril: 12300
- Mayo: 17800
- Junio: 24700
Este es el texto enviado para la tarea 5. Al pedir leer todos los números sobre las barras, se colocó entre las más difíciles de las 6 tareas.
A partir de la imagen del gráfico de barras adjunto, lee todos los valores mensuales.
Reglas
– Una línea por mes. Escribe cada línea en el formato Mes: ◯◯◯, en orden de izquierda a derecha
– Escribe los números con caracteres de ancho normal. No agregues explicaciones
ChatGPT solo agotó el tiempo en el tercer intento de la tarea 5
ChatGPT acertó el primer y el segundo intento de la tarea 5, respondiendo en 20.5 y 26.6 segundos. La respuesta tenía 6 líneas con el formato “Enero: 5500”. El tercer intento se agotó a los 300.8 segundos.
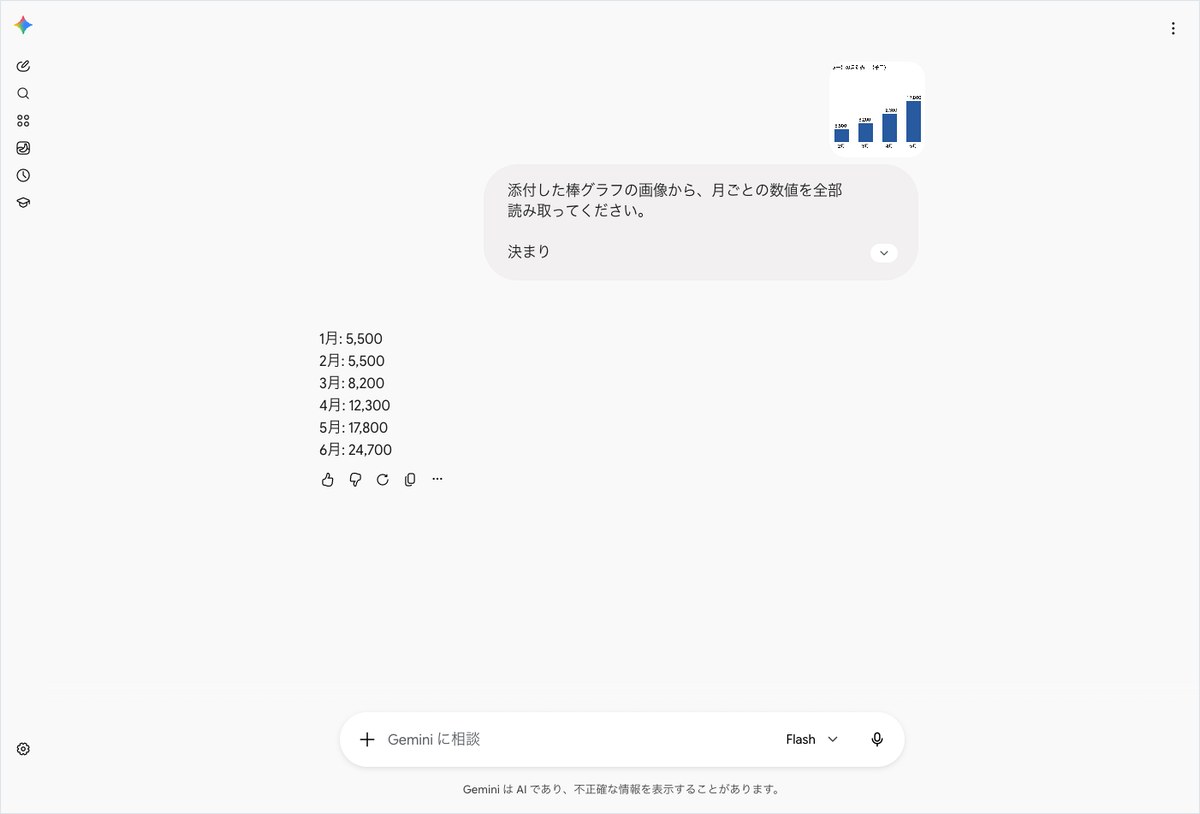
Gemini tardó 204.9 segundos en la tarea 5
Gemini acertó el primer intento de la tarea 5, pero tardó 204.9 segundos (unos 3 minutos). El segundo y el tercer intento se agotaron por tiempo. La respuesta incluía comas, como en “Enero: 5,500”. Como la regla de esta tarea no prohibía las comas, estos números se contaron como correctos.
En todos los intentos con respuesta, el mes más alto fue junio
En la tarea 4, todos los intentos con respuesta indicaron “junio”. ChatGPT tardó 48.3 segundos en el segundo intento. Fue el tiempo más largo entre los 18 intentos de ChatGPT, sin contar los que se agotaron por tiempo.
Gemini acertó en el primer intento, en 61.7 segundos, y en el tercero, en 76.7 segundos; el segundo intento se agotó por tiempo. La respuesta del tercer intento incluía la línea “chart.png”, lo que infringió la regla de responder en una sola línea y se marcó como incorrecto (×). Claude respondió “junio” en los tres intentos, en un tiempo de entre 13.8 y 13.9 segundos.
En la tabla inclinada, ChatGPT falló un intento por el formato de la respuesta
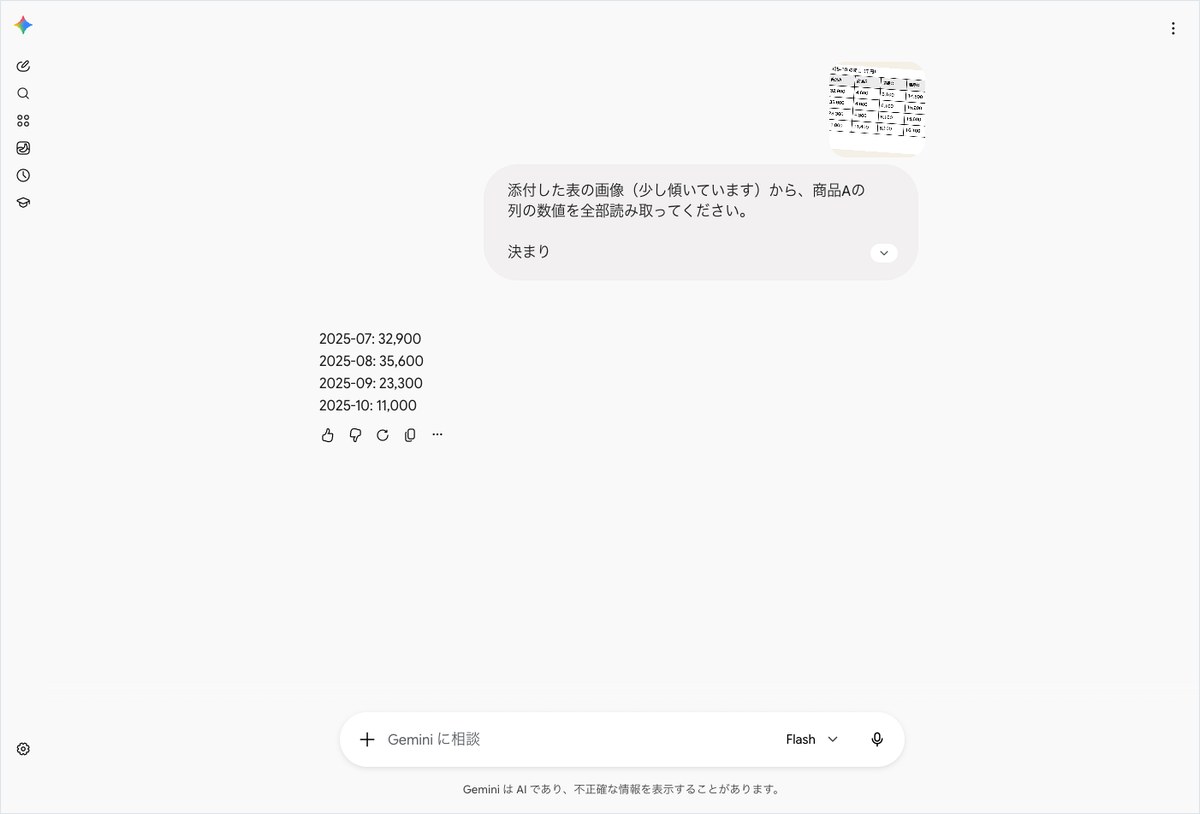
La tarea con la tabla inclinada se marca como correcta (○) si se aciertan los 4 números de la columna del producto A junto con sus meses. Las respuestas correctas eran las siguientes 4:
- 2025-07: 32900
- 2025-08: 35600
- 2025-09: 23300
- 2025-10: 11000
Este es el texto enviado para la tarea 6. Al igual que un documento fotografiado con un smartphone, la imagen de la tabla se inclinó ligeramente.
A partir de la imagen de la tabla adjunta (está ligeramente inclinada), lee todos los valores de la columna del producto A.
Reglas
– Uno por línea. Escríbelo en el formato Mes: ◯◯◯, en orden de arriba hacia abajo
– Escribe los números con caracteres de ancho normal. No agregues explicaciones
El primer intento de ChatGPT tenía todos los números correctos, pero se marcó como incorrecto (×)
ChatGPT acertó solo 1 de los 3 intentos. En el primero, respondió en 20.6 segundos con los 4 números correctos. Sin embargo, el inicio de la línea decía “julio” en lugar de “2025-07”. Como la evaluación busca los números usando “2025-07” como referencia, al no encontrar esa referencia se marcó como incorrecto (×).
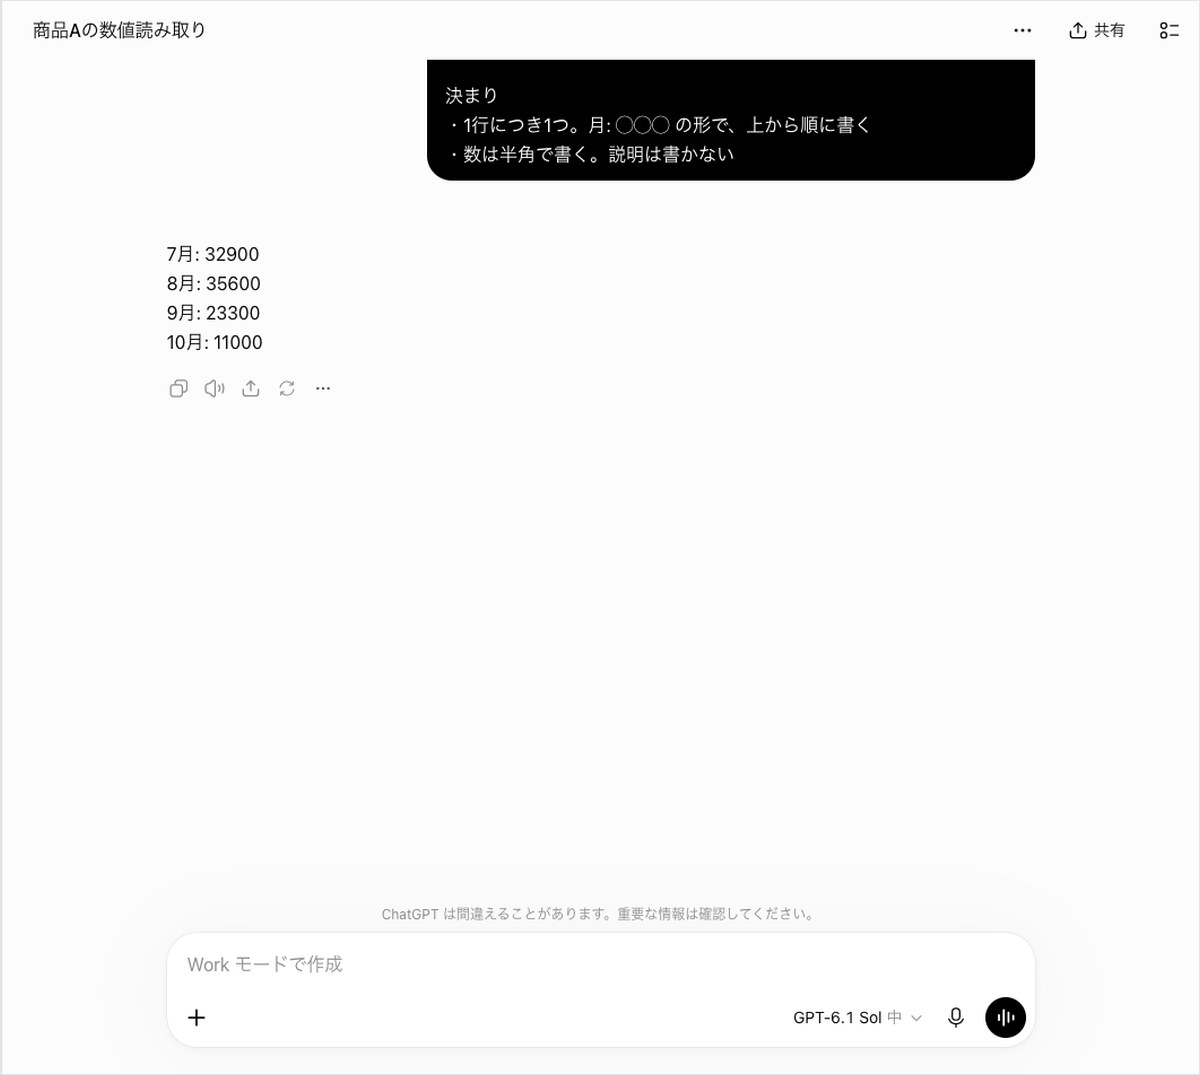
El texto de la tarea solo decía: “con el formato mes: ◯◯◯”. Como el encabezado de la tabla es “2025-07”, se puede interpretar de cualquiera de las dos formas. En el segundo intento, ChatGPT respondió con el formato de la tabla, “2025-07: 32900”, y fue correcto. En el tercer intento se agotó el tiempo a los 301.2 segundos.
Si vas a usar esto en tu propio trabajo, mostrar un ejemplo de una línea con el formato que quieres ayuda a reducir esta variación. Por ejemplo, se puede escribir “con el formato 2025-07: 32900”. Cabe aclarar que en esta medición no se probó con una frase que incluyera un ejemplo.
Claude devolvió las 4 líneas en unos 17 segundos las tres veces
Claude acertó las tres veces, con un tiempo de entre 16.9 y 17.1 segundos. La respuesta fueron 4 líneas con el formato “2025-07: 32,900”.
Gemini acertó en el primer intento, en 134.9 segundos. En el segundo y el tercer intento se agotó el tiempo.
Microsoft Copilot mostró el aviso de límite en los 18 intentos
El criterio de esta sección es si la herramienta leyó la imagen y devolvió un número. De los 18 intentos, Microsoft Copilot no devolvió ni una sola vez una respuesta basada en la lectura de la imagen.
Las 18 veces obtuvimos la misma frase. Se mostró el mensaje: “Has alcanzado el límite diario. Aumenta tu uso ahora o vuelve a intentarlo a las 9:00 a. m.”. El tiempo de respuesta fue de 13.8 a 17.1 segundos, y este mensaje apareció desde la primera tarea del primer intento. El plan utilizado fue Microsoft 365 Personal.
Una tasa de acierto del 0% no refleja la capacidad de lectura de imágenes
En la tabla de puntuación, estos 18 intentos se contaron como respuestas incorrectas. Esta serie de artículos tiene una regla para excluir del denominador los intentos detenidos por un límite de uso, pero en este caso se contaron como respuestas incorrectas.
Por eso, la tasa de acierto del 0% de Microsoft Copilot (0 de 18 intentos) no refleja su capacidad de lectura de imágenes. De la misma manera, el 100.0% de reproducibilidad es el resultado de que la misma frase de límite apareció las 18 veces. El 50% de cumplimiento de instrucciones corresponde a los casos en los que esa única línea del aviso coincidió por casualidad con lo que pedía la consigna. Esto ocurre en las tareas que pedían responder en una sola línea y en las que solo evaluaban el límite de caracteres.
Esta medición no determina cuándo aparece el límite
Esta medición no verificó con qué tipo de uso ni en qué intento aparece el límite. Tampoco permite saber hasta qué punto Microsoft Copilot puede leer imágenes correctamente a partir de estos números. En este artículo no se muestran capturas de pantalla de Microsoft Copilot, pero el texto completo de sus respuestas se puede consultar en la página de datos.
El artículo anterior sobre este mismo tema se encuentra en el artículo previo en el que se comparan 4 herramientas de lectura de imágenes. Antes de usar esto en tu trabajo, lo más seguro es probar con tu propio plan si al enviar esa misma imagen obtienes una respuesta.
Al comparar los 5 indicadores, Claude ocupó el primer lugar en tasa de acierto y velocidad
A partir de aquí revisamos los 5 indicadores uno por uno. En cada indicador, primero se indica en una frase a partir de qué punto se contó como aprobado.
Tasa de acierto: Claude obtuvo 18 de 18 intentos
La tasa de acierto es el número de intentos en los que se acertaron todas las respuestas de la tarea, dividido entre el denominador de 18 intentos. Los resultados fueron los siguientes.
- Claude: 18 de 18 intentos (100.0%)
- ChatGPT: 13 de 18 intentos (72.2%)
- Gemini: 7 de 18 intentos (38.9%)
- Microsoft Copilot: 0 de 18 intentos (0% · los 18 intentos mostraron el aviso de límite)
Tiempo de respuesta: la mediana de Claude fue de 13.9 segundos
El tiempo de respuesta es la mediana en segundos de los intentos en los que se obtuvo una respuesta. Los intentos en los que se agotó el tiempo no se incluyen aquí.
- Claude: 13.9 segundos (el más rápido 13.8 segundos, el más lento 17.1 segundos)
- Microsoft Copilot: 14 segundos (tiempo hasta que apareció el aviso de límite)
- ChatGPT: 25.4 segundos (el más rápido 20.4 segundos, el más lento 48.3 segundos)
- Gemini: 69.2 segundos (el más rápido 19 segundos, el más lento 204.9 segundos)
Gemini mostró una gran diferencia entre sus intentos más cortos y más largos. En la misma tarea 3, hubo un intento de 189.8 segundos y otro de 19 segundos.
Tasa de coincidencia: ChatGPT no uniformó el formato de la respuesta en la tarea 6
La tasa de coincidencia mide el porcentaje de veces que la conclusión fue la misma al repetir la misma tarea 3 veces. Claude obtuvo 100.0 %: en las 6 tareas devolvió el mismo número las 3 veces. ChatGPT obtuvo 83.3 %. En la tarea 6, el primer intento escribió «julio» y el segundo «2025-07», con formatos distintos.
Gemini también obtuvo 100.0 %, pero ese valor solo compara las tareas 3 y 4, en las que hubo dos o más respuestas. En las otras 4 tareas hubo una respuesta o menos, por lo que no se pudieron comparar. El 100.0 % de Microsoft Copilot refleja que el mensaje de límite fue idéntico en todos los casos.
Tasa de existencia de la fuente: no se midió en esta categoría
En esta categoría no hay tareas que requieran revisar una URL, por lo que no se midió la tasa de existencia de la fuente. En las cuatro IA se dejó el campo en blanco, lo cual no significa 0 %.
Tasa de cumplimiento de instrucciones: ChatGPT siguió todas las reglas en los intentos que respondió
El cumplimiento de instrucciones solo contó los intentos que siguieron por completo el formato solicitado (número de líneas, símbolo al inicio de cada línea, límite de caracteres). Los intentos con tiempo agotado no se incluyeron en el total.
- ChatGPT: 100.0 %
- Gemini: 62.5 %
- Microsoft Copilot: 50 % (intentos en que la única línea del límite cumplió el formato)
- Claude: 16.7 % (3 de 18 intentos)
El 16.7 % de Claude se debe a una diferencia entre la pantalla y el texto extraído. En la pantalla aparecían solo las líneas con el formato correcto. Pero el texto extraído incluía la frase introductoria «Respuesta de Claude:» y líneas de resumen del proceso de razonamiento. Además, al final se incluyó el carácter «ahora» junto al botón, lo que aumentó el número de líneas y se marcó como incorrecto. Como la tarea 6 solo evalúa el límite de caracteres, las 3 veces se marcaron como correctas.
Gemini tuvo 3 intentos marcados como incorrectos: dos en los que se añadió el nombre de los archivos adjuntos (receipt.png y chart.png) después de la respuesta, y uno en el que se negó a responder.
Para leer recibos o tablas, Claude es la primera opción
El criterio de evaluación aquí es la tasa de aciertos de esta ronda, la cantidad de tiempos agotados y el cumplimiento de instrucciones. Como se trata de una sola medición, te recomendamos probar también con tus propias imágenes antes de decidir.
Si priorizas la precisión y pocos reintentos: Claude
Claude acertó 18 de 18 intentos (100.0 %) y no tuvo ningún tiempo agotado (0 veces). Su tasa de coincidencia también fue de 100.0 %. Este resultado es adecuado para tareas como leer el total de un recibo en una rendición de gastos o transcribir una tabla escaneada. A veces la respuesta incluye un resumen del proceso de razonamiento, así que conviene revisar la primera línea antes de copiarla.
Si quieres copiar el formato de la respuesta tal cual: ChatGPT
ChatGPT tuvo un cumplimiento de instrucciones de 100.0 % en los intentos que respondió. Devuelve solo el formato solicitado, como “Subtotal: 2316”, lo que combina bien con tareas de pegar datos en una hoja de cálculo. Sin embargo, 4 de los 18 intentos agotaron el tiempo de 300 segundos. Para trabajos urgentes, conviene usarlo con la idea de volver a intentarlo si no responde.
Si priorizas la velocidad: Claude
El tiempo mediano requerido fue de 13.9 segundos para Claude, 25.4 segundos para ChatGPT y 69.2 segundos para Gemini. En tareas que implican leer decenas de recibos de forma seguida, esta diferencia se traduce directamente en tiempo de espera.
Gemini y Microsoft Copilot no se pueden evaluar del todo con esta ronda
Gemini no tuvo errores de lectura en los intentos en que devolvió un número. Sin embargo, 10 de los 18 intentos agotaron el tiempo, y en la tarea 1 no acertó ninguna vez. Puede ser una opción si puedes esperar a que llegue la respuesta, pero con solo estos resultados es difícil recomendarlo.
Microsoft Copilot se detuvo en el mensaje de límite, por lo que no se pudo medir su capacidad de leer imágenes. Si ya usas Microsoft 365, te recomendamos probarlo tú mismo en un horario en que no se alcance ese límite.
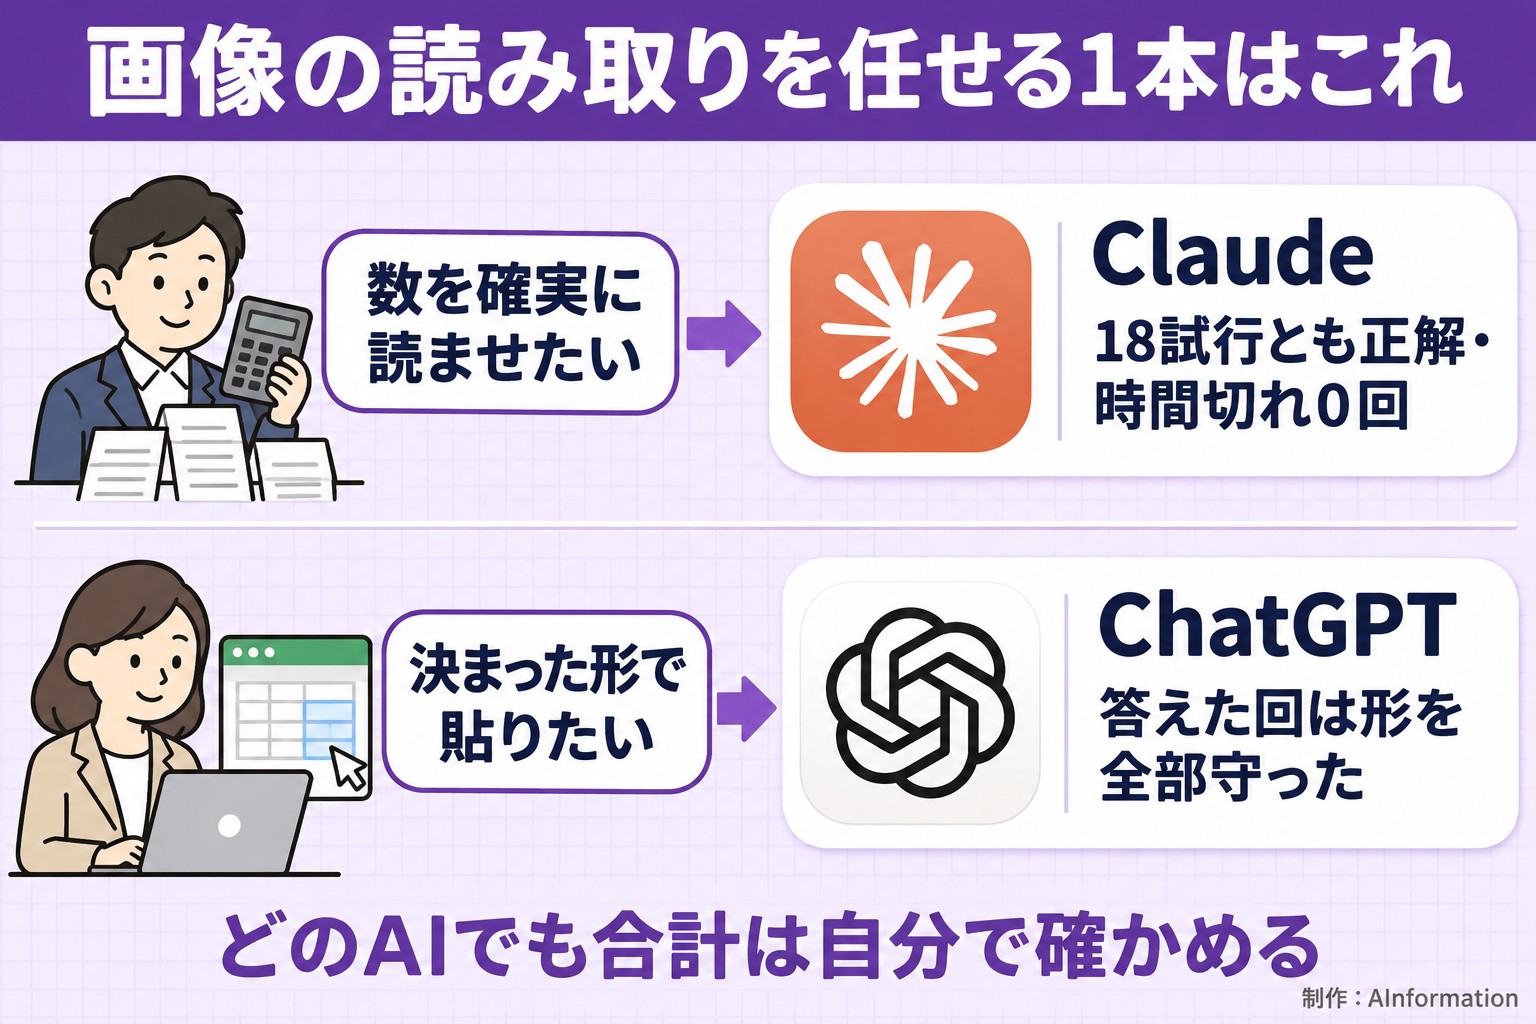
Sin importar qué IA uses, antes de transcribir el total a un libro contable o una factura, es más seguro verificar al menos ese dato por tu cuenta. La imagen de esta prueba es una imagen nítida creada específicamente para el test, así que los resultados podrían variar con fotos reales de recibos.
El límite de esta medición: es el resultado de una sola ronda en un solo día
Las cifras de este artículo corresponden a una sola medición realizada el 3 de noviembre de 2026. Si cambia el día o la tarea, el orden de resultados también puede cambiar. Además, existen las siguientes limitaciones:
- Se usaron los planes de pago de cada IA (ChatGPT Pro, Google AI Pro, Claude Max, Microsoft 365 Personal); no son resultados de las versiones gratuitas
- Solo se midió con el modelo y el modo predeterminados; no se usaron funciones como Deep Research
- Las tareas usan datos ficticios creados para la prueba de la empresa ficticia Sample Shoji; no son resultados con datos de una empresa real
- Solo se evaluaron tareas que se pueden calificar de forma mecánica; no se midió la calidad de redacción ni la facilidad de lectura
- La medición se hizo desde la misma pantalla que usaría una persona en el navegador; no son resultados de la API
- En las IA donde no se pudo leer el nombre del modelo en pantalla, ese campo se dejó en blanco (en este caso, Microsoft Copilot)
Esta ronda tiene especialmente dos limitaciones. Una es que Microsoft Copilot mostró el mensaje de límite en los 18 intentos, por lo que no se pudo medir su capacidad de leer imágenes. La otra es que el material usado fue una imagen nítida creada para la prueba. No se probó con fotos borrosas ni con texto escrito a mano.
Los lectores pueden volver a contar las cifras por su cuenta. El texto completo de las tareas, las imágenes usadas como material, las 72 respuestas de las cuatro IA, la tabla de calificación en formato de una línea por intento (CSV) y las capturas de pantalla están disponibles en la página de datos del Benchmark de IA para tareas reales (lectura de imágenes y fotos). Si vas a citar estos datos, incluye la mención “Fuente: AInformation (Benchmark de IA para tareas reales, medición del 3 de noviembre de 2026)” junto con la URL de la página de datos.
Artículos y herramientas relacionados
- Benchmark de IA para tareas reales: lectura de imágenes y fotos (página de datos medidos el 3 de noviembre de 2026)
- Precios y funciones de ChatGPT
- Precios y funciones de Gemini
- Precios y funciones de Claude
- Precios y funciones de Microsoft Copilot
- Comparamos la precisión de 4 IA para resumir actas de reuniones: 3 prompts listos para usar
- Comparamos 4 IA de lectura de imágenes: 3 prompts para leer números y cómo elegir
- Comparamos 4 IA para detectar variaciones de escritura: 3 prompts de unificación de nombres y cómo elegir
- Comparamos la precisión de lectura de imágenes de varias IA: 3 prompts listos para usar
En las tareas de lectura de números en imágenes, la diferencia no estuvo primero en si la IA leía mal, sino en si devolvía una respuesta. En los intentos en que la IA escribió los números y los devolvió, ninguna de las IA se equivocó en los números. Por otro lado, Gemini agotó el tiempo en 10 de 18 intentos, y Microsoft Copilot mostró el mensaje de límite alcanzado en los 18 intentos. Uno de los intentos de ChatGPT tenía todos los números correctos, pero se marcó como incorrecto porque la fila empezaba con “julio”. Para el uso interno, se recomienda mostrar el formato deseado con un ejemplo de una sola línea y que una persona verifique únicamente el total.
- ¿Qué IA leyó con más precisión los números en imágenes?
- En esta medición, fue Claude. El 3 de noviembre de 2026 se le dieron 6 tareas, 3 veces cada una, y acertó en 18 de 18 intentos (100.0%). ChatGPT acertó en 13 de 18 intentos (72.2%) y Gemini en 7 de 18 intentos (38.9%). Como la medición se hizo una sola vez en un día, el orden puede cambiar si cambian el día o las tareas.
- ¿Microsoft Copilot no puede leer imágenes?
- Esto no se pudo comprobar en esta medición. En los 18 intentos, Microsoft Copilot mostró el mensaje “Has alcanzado el límite diario” y no devolvió ninguna respuesta basada en la lectura de la imagen. La tabla de resultados muestra 0 % de aciertos, pero eso no refleja su capacidad real de lectura de imágenes. Pruébalo tú mismo con tu propio plan en un momento en que no se alcance el límite.
- ¿Por qué la tasa de aciertos de Gemini es baja?
- Porque en 10 de los 18 intentos, la respuesta no terminó dentro del límite de 300 segundos y se agotó el tiempo. En el primer intento de la tarea 1, respondió: “No estoy programado para hacer eso.” En los intentos en los que sí devolvió los números por escrito, no hubo errores de lectura.
- ¿Puedo probar yo mismo con los mismos prompts del artículo?
- Sí, puedes probarlo. Los tres textos de las tareas que aparecen en el cuerpo del artículo se pueden copiar y usar tal como están. Las imágenes usadas en la prueba (recibo, gráfico de barras y tabla inclinada), las 72 respuestas de las 4 IA y la tabla de resultados (CSV) se pueden descargar desde la página de datos. La calificación se hizo con margen de error cero, así que puedes comparar directamente tu propia respuesta con la respuesta correcta.
- ¿Se obtienen los mismos resultados con las versiones gratuitas de las IA?
- Esto no se comprobó en esta medición. Se usaron las versiones de pago ChatGPT Pro, Google AI Pro, Claude Max y Microsoft 365 Personal, con el modelo y el modo predeterminados. En las versiones gratuitas, el modelo y los límites pueden ser diferentes, por lo que los resultados también podrían variar.