AIに画像を読み取らせるときに実際に投げたプロンプト3つを、そのまま使える形で載せました。2026年9月27日にレシートやグラフの画像で3つのAIを比べると、ChatGPTとClaudeは全問正解でした。Geminiはレシートのお釣りを2回外しています。
- AIの画像読み取り精度を比べた結果と、そのまま使えるプロンプト3つ
- レシート・棒グラフ・傾いた表の画像から数字を読む6課題を、2026年9月27日にChatGPT・Gemini・Claudeへ投げて機械だけで採点した結果
- 正解率はChatGPTが12試行のうち12試行でClaudeが13試行のうち13試行となり、どちらも100.0%の同率だった
- Geminiは12試行のうち10試行(83.3%)で、外した2試行はどちらもレシートのお釣りを読む易しい課題だった
- 傾いた表の1列や棒グラフの6か月分を読む難しい課題は、3つのAIとも1回も外さなかった
- 所要時間の中央値はClaudeとChatGPTが14秒台で、Geminiは19.5秒だった
- 採点できたのは予定72試行のうち37試行で、Microsoft Copilotは編集部のログイン切れで1試行も測れていない
画像の読み取り精度はChatGPTとClaudeが全問正解で並んだ
画像から数字を読み取る課題で、正解率がいちばん高かったのはChatGPTとClaudeです。ChatGPTは12試行のうち12試行が正解で、Claudeは13試行のうち13試行が正解でした。正解率はどちらも100.0%なので、この回は1位を決めずに同率として扱います。Geminiは12試行のうち10試行が正解で、正解率は83.3%になりました。
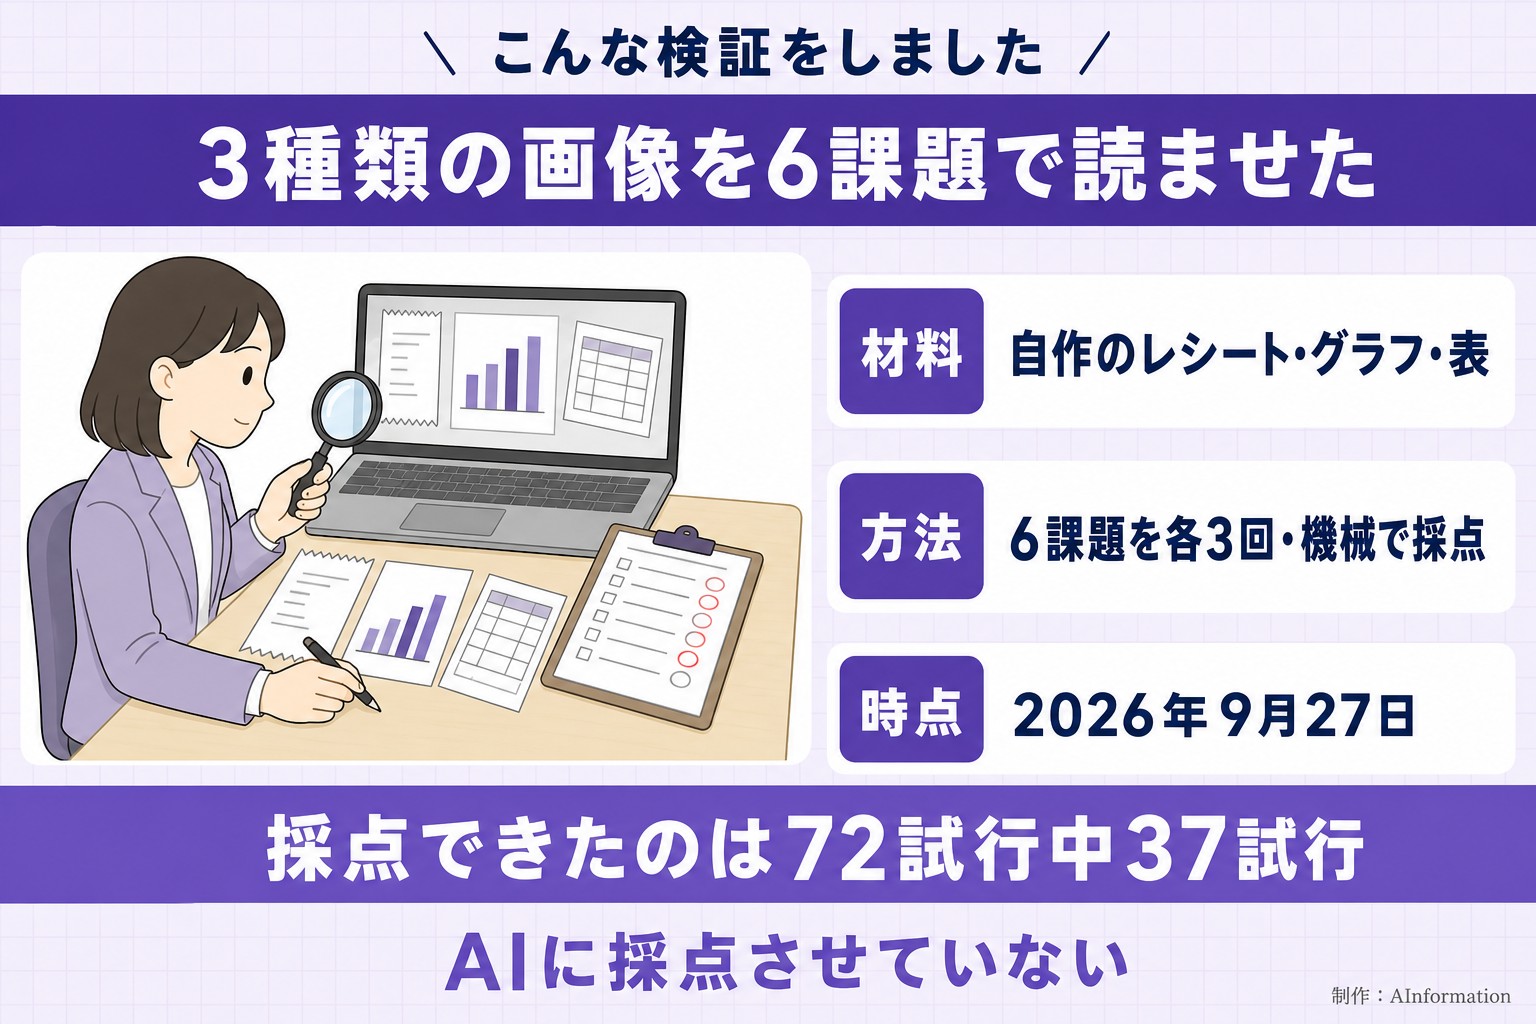
AInformation編集部は2026年9月27日に、6つの課題をChatGPT・Gemini・Claudeへ投げました。材料は編集部が作った架空のレシートと棒グラフ、それに少し傾けた表の画像です。1つの課題を3回ずつ投げる計画で、答えは機械だけで採点しています。ただし1回の測定なので、日や課題が変われば順位は変わります。
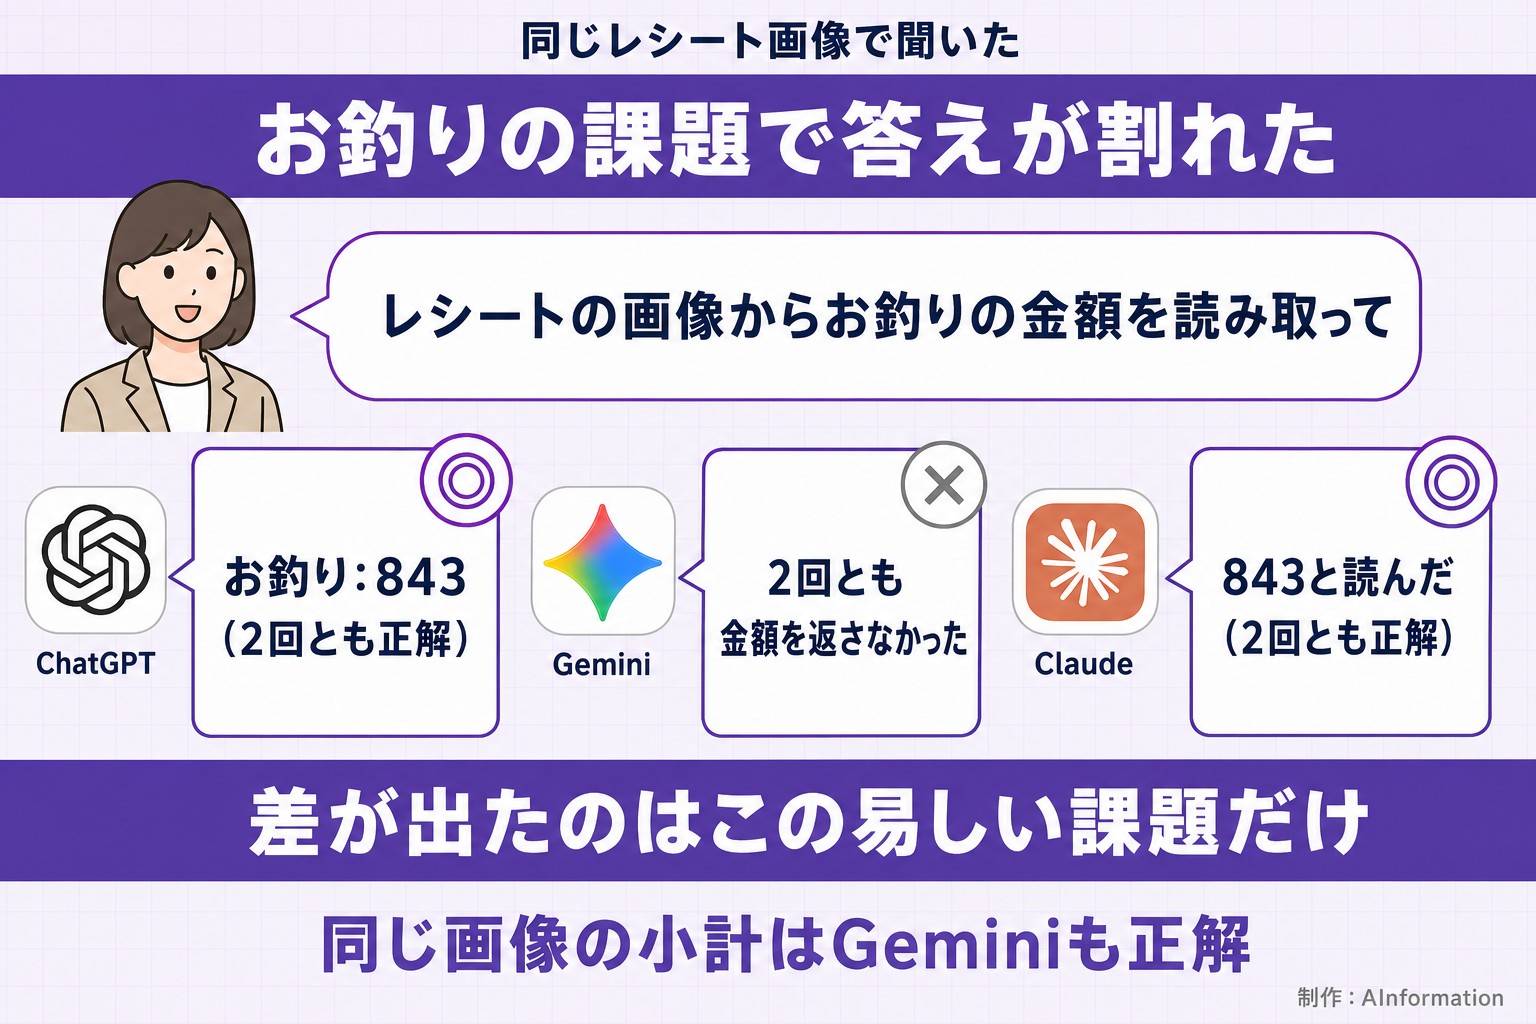
いちばん差が出たのは、易しい課題に分けた「レシートのお釣りを読む課題」でした。ChatGPTとClaudeは2回とも843と答えています。Geminiは2回とも金額を返さず、対応できないという答えでした。
少し傾いた表や棒グラフから数値を全部読む「難」の課題では、3つのAIとも1回も外していません。この回の差は難しい課題ではなく、易しい課題の1つで出ました。
Microsoft Copilotも同じ条件で測る予定でしたが、測定の途中で編集部のログインが切れて1試行も測れていません。そのため、この回の比較は3つのAIです。ほかの3つのAIも一部の試行が測れず、分母がAIごとに少しずつ違います。
1回ごとの結果を数え直したい方は、この回の採点表と回答の全文を開いてください。
レシートとグラフと傾いた表の6課題を機械だけで採点した
課題の材料は、AInformation編集部が毎回作り直している自作のデータです。棒グラフと表は架空の株式会社サンプル商事の売上で、レシートも検証用に作った架空の店のものです。元の数は画像を作るときに決めてあるので、正解は採点の前から決まっています。課題は易・中・難を2つずつ用意しました。
- 課題1(易):レシートの小計・消費税・合計を読む
- 課題2(易):レシートのお釣りの金額を読む
- 課題3(中):レシートの品物を全部書き出す
- 課題4(中):棒グラフで棒が一番高い月を答える
- 課題5(難):棒グラフの6か月分の数値を全部読む
- 課題6(難):傾いた表から商品Aの列を全部読む
毎回あたらしい会話で画像を添付して投げた
1回ごとにあたらしい会話を開き、画像を1枚添付してから課題の文を送りました。投げる順番は3回の繰り返しごとに入れ替えています。
- 1回目:ChatGPT→Gemini→Claude→Microsoft Copilot
- 2回目:Gemini→Claude→Microsoft Copilot→ChatGPT
- 3回目:Claude→Microsoft Copilot→ChatGPT→Gemini
測る前には「はい」とだけ返してもらう空打ちを1回して、その1回は採点に入れていません。答えを待つ上限は300秒(5分)で、この回に時間切れの試行はありませんでした。
採点は機械だけでAIには採点させていない
数を読む課題は誤差0の決まりで、正解とぴったり同じ数でないと○になりません。品物の課題は、7品がそろっているかと作り足しが無いかを機械が数えます。AIに採点はさせていません。
画面から答えを読み取るとき、AIによっては読み上げ用の1行や考えている途中の要約が答えと同じ枠に入ります。こうした行は採点の前にどのAIも同じ決まりで落とし、落とす前の答えもデータページに置きました。
72試行の予定のうち採点できたのは37試行だった
予定は6課題×3回×4つのAIで72試行でした。測定の途中で編集部のログインが切れ、35試行は測れていません。AIの答えとは関係のない失敗なので、分母から外しています。
- ChatGPT(ChatGPT Pro・表示は「中程度」):予定18試行のうち12試行
- Gemini(Google AI Pro・表示は「Flash 拡張」):予定18試行のうち12試行
- Claude(Claude Max・表示は「Opus 5.5 中」):予定18試行のうち13試行
- Microsoft Copilot(Microsoft 365 Personal):予定18試行のうち0試行
かっこの中は使ったプランと、画面に出ていたモデルの表示です。どれも既定のモデルと既定のモードのままで測りました。
6課題の○×を比較するとお釣りの課題だけ割れた
×が付いたのは、課題2(お釣り)のGeminiの2試行だけでした。ChatGPTとClaudeは、採点できたすべての試行で○です。課題ごとの結果を表にまとめました。○が正解で×が不正解です。-は編集部のログイン切れで測れなかった試行です。
6課題×各3回の正解(○)と不正解(×)
| 課題(難しさ) | ChatGPT | Gemini | Claude | Microsoft Copilot |
|---|---|---|---|---|
| 1 小計・消費税・合計(易) | ○○- | ○○- | ○○○ | --- |
| 2 お釣り(易) | ○○- | ××- | ○○- | --- |
| 3 品物7品の書き出し(中) | ○○- | ○○- | ○○- | --- |
| 4 棒が一番高い月(中) | ○○- | ○○- | ○○- | --- |
| 5 棒グラフ6か月の数値(難) | ○○- | ○○- | ○○- | --- |
| 6 傾いた表の商品Aの列(難) | ○○- | ○○- | ○○- | --- |
| 正解率 | 12/12(100.0%) | 10/12(83.3%) | 13/13(100.0%) | 測れず(0試行) |
Geminiもお釣り以外の5つの課題では、2回とも○が付いています。難しさで分けると、次のようになります。
- 易(課題1・2):Geminiだけ課題2で2試行とも×
- 中(課題3・4):3つのAIとも全部○
- 難(課題5・6):3つのAIとも全部○
難しい課題で差がつくとは限らない、というのがこの回の結果です。一方で、答えの書き方には違いが出ました。課題5と課題6でChatGPTは「9300」のようにカンマなしで返し、GeminiとClaudeは「9,300」とカンマを付けています。どちらの課題も決まりは「数は半角で書く」だけなので、書き方の違いで×にはしていません。
1回ごとの結果と答えの全文は、データページの採点表で1行ずつ確かめられます。
レシートのお釣りをGeminiは2回とも金額で答えなかった
課題2では、Geminiだけが2回ともお釣りの金額を返しませんでした。ChatGPTとClaudeは2回とも正解の843を返しています。レシートの画像はデータページから落とせるので、同じ文と画像で試せます。投げた文は次のとおりです。
添付したレシートの画像から、お釣りの金額を読み取ってください。
決まり
・答えはちょうど1行。お釣り: ◯ の形で書く
・数は半角で書く。説明は書かない
レシートの下のほうには「お預り ¥3,000」と「お釣り ¥843」の2行があります。ChatGPTは2回とも「お釣り: 843」の1行だけを返しました。Claudeも2回とも843と読んでいます。

Geminiの1回目の答えは「大規模言語モデルとして私はまだ学習中であり、そちらには対応できません。」です。採点では「断られた(ポリシー)」として扱い、不正解として分母に入れています。

2回目の答えは「私はテキストベースのAIです。そちらに対応できる機能がありません。」でした。こちらは答えにお釣りの行が無いため、数値が違う不正解として採点しています。この2回目は36.6秒かかり、Geminiの試行の中でいちばん長くなりました。
画面を見ると、レシートの画像は会話の上に添付されています。同じレシートの画像でも、小計や品物を聞いた課題1と課題3ではGeminiも正しく答えました。なぜこの課題だけ金額を返さなかったのかは、この測定では分かりません。
この回は、あたらしい会話で投げ直した2回目も金額は返りませんでした。この回の結果から言えば、同じ画像をChatGPTかClaudeに渡したほうが早く答えが出ます。どちらも2回とも正しく読んでいるためです。
同じレシートの小計と7品は3つのAIとも全部読めた
お釣りと同じレシートを使った課題1と課題3は、3つのAIとも採点できた試行をすべて正解しました。課題1は、レシートの小計・消費税・合計の3つの数を読む課題です。正解は小計1998・消費税159・合計2157でした。Claudeは3回目も測れていて、3試行とも○です。
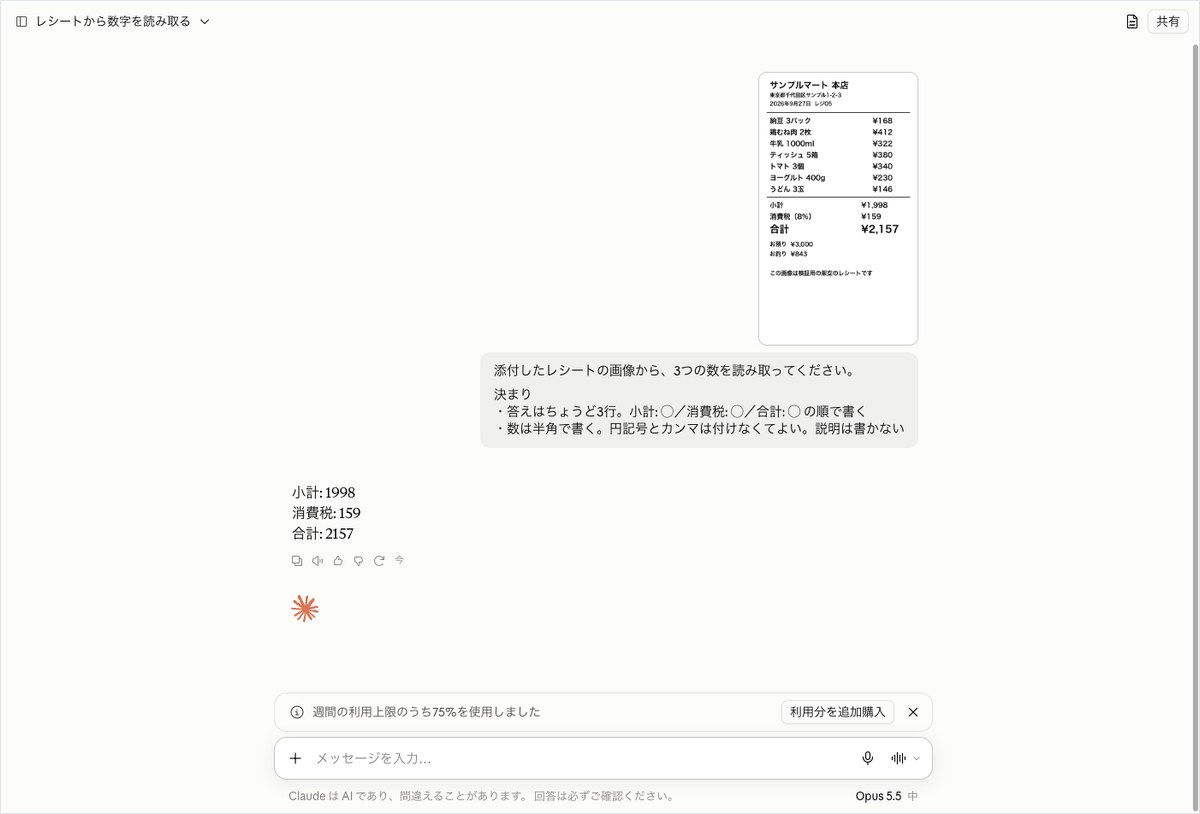
お釣りで金額を返さなかったGeminiも、この課題では「小計: 1998」から始まる3行を決まりどおりに返しています。同じ画像でも、聞いた中身によって答えが返ったり返らなかったりしたことになります。
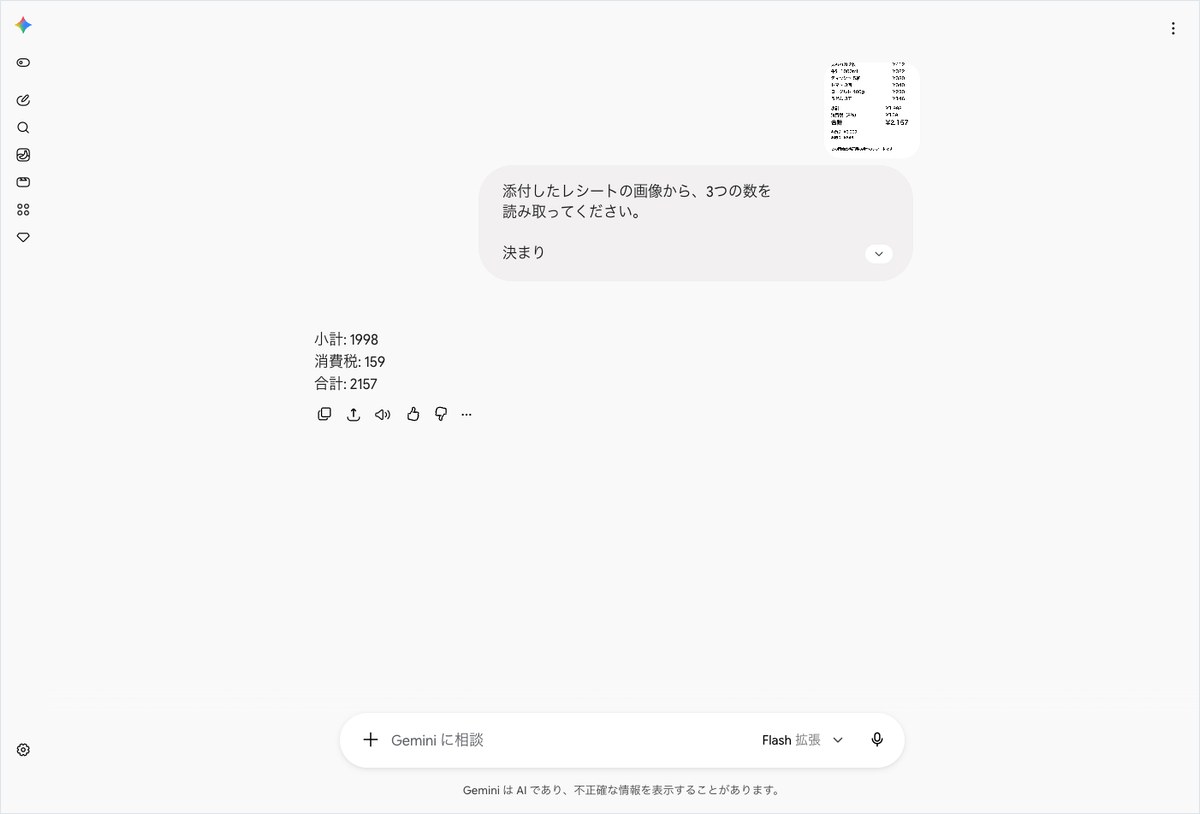
課題3は、レシートの品物を1品1行で書き出す課題です。正解は「納豆 3パック」から「うどん 3玉」までの7品で、レシートに無い品物を1つでも足すと不正解になります。投げた文は次のとおりです。
添付したレシートの画像から、買った品物を全部書き出してください。
決まり
・1品につき1行。行の先頭は ・ にする。品名と金額を書く
・小計・消費税・合計・お預り・お釣りの行は書かない
3つのAIとも2回とも7品をすべて書き出し、作り足しは0件でした。金額の書き方はAIで分かれています。ChatGPTの1回目は「168円」と書き、Claudeは「¥168」と書きました。

指示の遵守では、Geminiだけ2回とも×が付きました。採点表の理由は「形のそろわない行 2/9本」です。Geminiの答えの最後に「PNG」と「他 4 件」の2行が入り、行の先頭が「・」でない行として数えられました。

画面では、最後の品物の行の右に「PNG 他 4 件」という灰色の小さな札が出ています。品物の7行そのものは決まりどおりでした。この札の文字を答えに含めるかどうかで、Geminiの指示の遵守率は変わります。
傾いた表と棒グラフの数値は3つとも1つも外さなかった
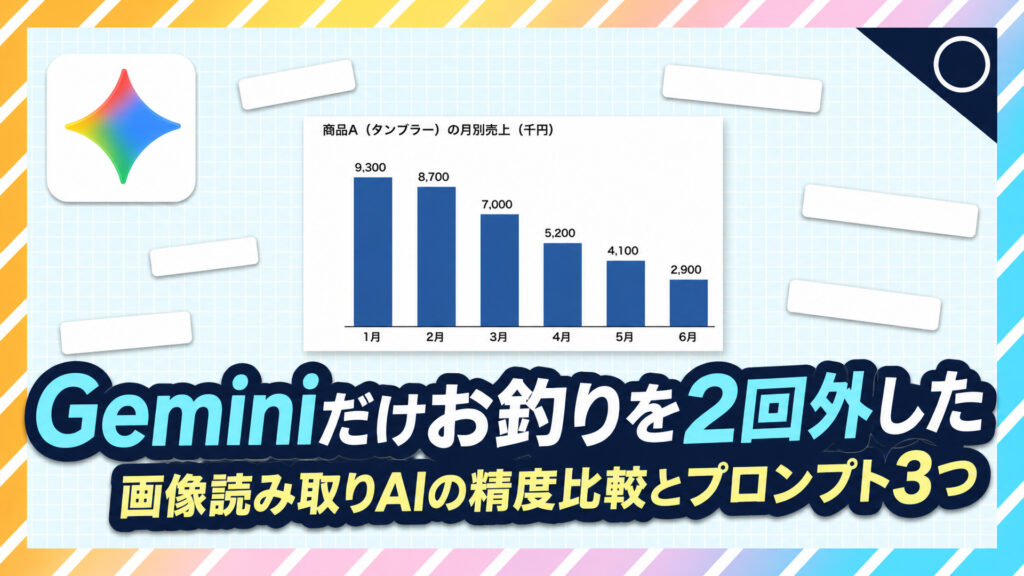
グラフと表を読む課題4〜6は、3つのAIとも採点できた試行をすべて正解しました。材料は架空の株式会社サンプル商事の売上です。棒グラフは商品A(タンブラー)の1月〜6月の売上で、単位は千円になります。棒の上には、それぞれの月の数値が書いてあります。
棒が一番高い月は3つとも1月と答えた
課題4は、棒グラフで棒が一番高い月を「◯月」の形で1行だけ答える課題です。正解は1月で、3つのAIとも2回とも「1月」とだけ返しました。数値や説明を足したAIはありません。
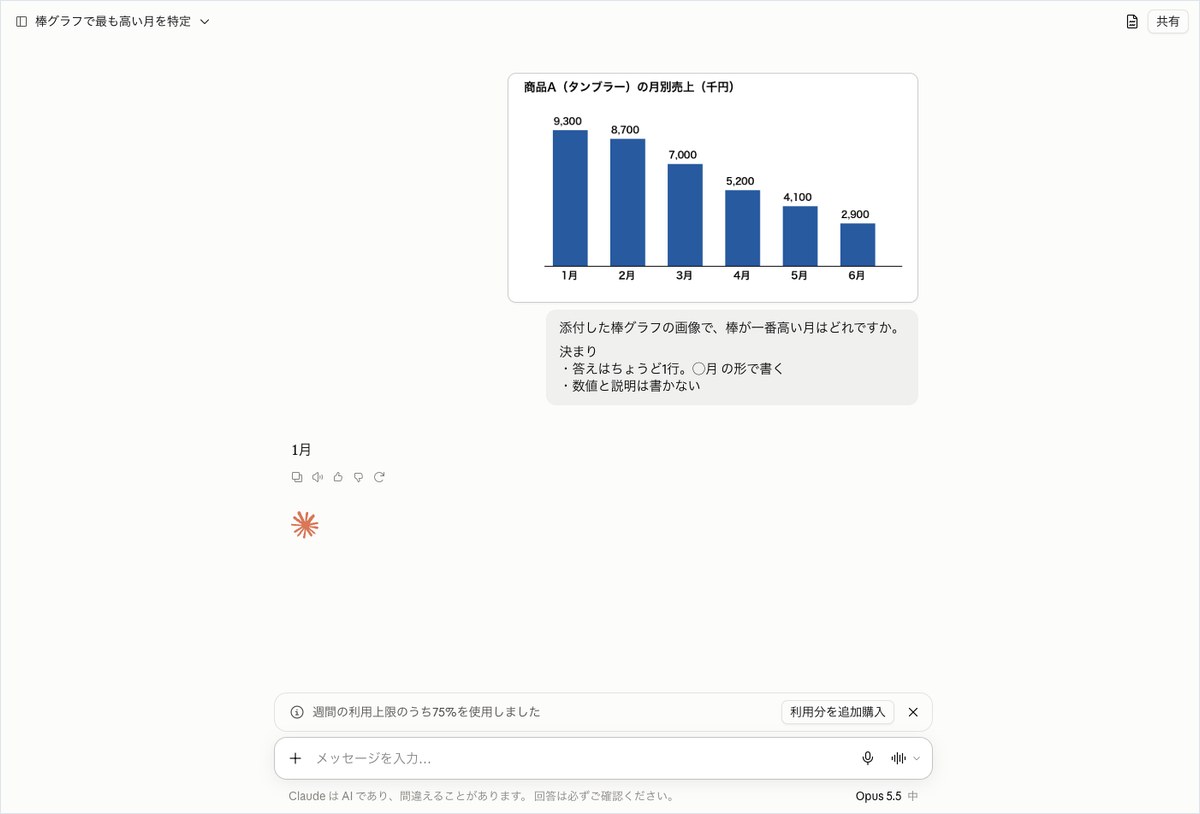
6か月分の数値も3つとも全部当てた
課題5は、同じ棒グラフの6か月分の数値を左から順に全部読む課題です。正解は1月の9,300から6月の2,900までの6つで、誤差は認めていません。3つのAIとも2回とも6つの数値をすべて当てました。下の画面はChatGPTの1回目です。18.3秒かかり、ChatGPTの試行の中ではいちばん長い時間でした。

傾いた表から商品Aの列だけを読む課題も全問正解だった
課題6は、少し傾けた表の画像から商品Aの列だけを上から順に読む課題です。投げた文は次のとおりです。
添付した表の画像(少し傾いています)から、商品Aの列の数値を全部読み取ってください。
決まり
・1行につき1つ。月: ◯◯◯ の形で、上から順に書く
・数は半角で書く。説明は書かない
表には商品A〜Eの5列と、2025-07から2025-10までの4行が並んでいます。正解は2,300・2,300・3,500・5,800の4つです。2025-10の商品Aは5,800で、隣の商品Bの列にも5,800が4行続いています。3つのAIとも2回とも、商品Aの列だけを正しく読みました。

この回の画像は、編集部が作った文字のはっきりした画像です。しわや影のある実物のレシートを撮った写真で同じ結果になるかは、この測定では確かめていません。ChatGPTだけでレシートを崩していった結果は、レシートを4段階に崩して照合した記事にまとめています。
正解率はGeminiだけ83.3%で再現率は3つとも100.0%だった
5つの指標のうち正解率はGeminiだけが83.3%で、再現率は3つとも100.0%でした。どの指標も、採点できた37試行だけで数えた値です。
正解率はChatGPTとClaudeが100.0%で並んだ
ChatGPTは12試行のうち12試行が正解で、Claudeは13試行のうち13試行が正解でした。正解率はどちらも100.0%です。Geminiは12試行のうち10試行が正解で、83.3%でした。Geminiが落とした2試行は、断られた1試行と数値が違った1試行です。断られた試行も、不正解として分母に入れています。
再現率は3つとも100.0%だった
再現率は、同じ課題を3回投げたときに結論がそろうかを見る指標です。3つのAIとも100.0%で、答えが揺れた課題はありませんでした。ただしこの回は3回目の多くが測れていないため、ほとんどの課題は2回分の答えを比べた値です。Geminiのお釣りの課題は比べられる答えが1つしか無く、再現率の計算から外れています。
出典の実在率はこの分野では測っていない
出典の実在率は、AIが示したURLが実在するかを見る指標です。この分野ではURLを見る課題が無いので、この回は測っていません。表の欄も「測っていない」にしてあります。
所要時間と指示の遵守率はChatGPTとClaudeが上回った
所要時間の中央値と指示の遵守率は、どちらもChatGPTとClaudeがGeminiより良い値でした。
所要時間の中央値はClaudeとChatGPTが14秒台だった
所要時間は、1回の試行で答えが返るまでにかかった秒数です。中央値と、最短・最長は次のとおりでした。
- Claude:中央値14.0秒(最短13.9秒・最長15.0秒)
- ChatGPT:中央値14.4秒(最短14.1秒・最長18.3秒)
- Gemini:中央値19.5秒(最短19.4秒・最長36.6秒)
ClaudeとChatGPTはどちらも14秒台で、ほぼ並びました。Claudeは最短と最長の差が小さく、どの試行もほぼ同じ時間で返っています。Geminiは中央値が19.5秒で、ほかの2つより長くかかりました。最長の36.6秒は、お釣りの課題で金額を返さなかった2回目です。
指示の遵守率はChatGPTだけ100.0%だった
指示の遵守率は、行数・文字数・行の先頭の形が決まりどおりかを機械で見た割合です。ChatGPTは12試行のうち12試行で決まりを守り、100.0%でした。Claudeは13試行のうち12試行で92.3%です。Geminiは形を見られた11試行のうち9試行で、81.8%になりました。Geminiの分母が11なのは、断られた1試行では形を見ていないためです。
Claudeの×は課題2の2回目です。答えの枠に「お釣りの金額を計算中。」という行が2回入り、機械は行数を4行と数えました。答えの本体は「お釣り: 843円」の1行で、数字は正解です。Geminiの2試行は、前の章で書いた「PNG 他 4 件」の札が行として数えられたものでした。3試行とも答えの中身は正解で、落とす前の全文はデータページで読めます。
画像の読み取りでこの回のおすすめはChatGPTかClaudeだ
レシートやグラフの数字を任せるなら、この回の結果ではChatGPTかClaudeです。仕事の場面ごとに任せる先をまとめます。どれも2026年9月27日の1回の測定にもとづく目安です。
数字を正確に写したいならChatGPTかClaude
経費精算のレシートや、報告書に貼るグラフの数字を写す作業です。ChatGPTとClaudeは、この回に採点できた試行をすべて正解しました。2つのあいだに正解率の差はありません。
待ち時間を短くしたいならClaude
所要時間の中央値はClaudeがいちばん短く、ChatGPTの14.4秒とほぼ同じでした。差は小さいので、速さだけでどちらかに絞る必要はありません。Geminiの19.5秒と比べると、どちらも早く返っています。
答えの形を崩したくないならChatGPT
表計算ソフトにそのまま貼るなど、決まった形で返してほしい場面です。指示の遵守率はChatGPTだけが100.0%で、12試行のうち1回も形を崩していません。行数を決めて頼むと、その行数どおりに返しました。
Geminiは答えが返らないときに別のAIで確かめる
Geminiも、6つの課題のうち5つは2回とも正解しています。ただしお釣りの課題では、2回とも金額が返りませんでした。Geminiで答えが返らないときは、同じ画像をほかのAIに渡して確かめると安心です。
Microsoft Copilotはこの回の結果では判断できない
Microsoft Copilotは測れていないので、この回の数字からは何も言えません。同じ連載の議事録の回では4つのAIとも測れていて、Microsoft Copilotの結果も載せています。
この測定は1日1回の37試行で日が変われば順位も変わる
この記事の数字は、2026年9月27日の1回の測定の結果です。日や課題が変われば順位は変わります。とくに次の点に気をつけて読んでください。
- 採点できたのは予定72試行のうち37試行です。再現率の多くは2回分の答えを比べた値になります
- Microsoft Copilotは測定中にログインが切れたため測れていません。表の欄は試行0で、ほかのAIと比べられる数字ではありません
- プランは4つとも有料版です。無料版の結果ではありません
- 既定のモデルと既定のモードだけで測りました。Deep Researchのような機能は使っていません
- 材料は架空の株式会社サンプル商事の自作データです。実在の企業のデータや、実物のレシートを撮った写真での結果ではありません
- ブラウザで人が使うのと同じ画面から測っています。APIの結果ではありません
- 機械で採点できる課題だけを扱っています。答えの読みやすさは測っていません
数字は読者の手元で数え直せます。この回のデータページからは、次のものを落とせます。
- 6課題の全文と材料の画像3枚(レシート・棒グラフ・傾いた表)
- 3つのAIの回答の全文37本(採点の前に落とした行も残したまま)
- 1行=1試行の採点表(CSV・72行)
- 撮った画面
この記事やデータを引用するときは、出典として「AInformation調べ」と書いてください。あわせてデータページのURLと、測定日の2026年9月27日も添えてください。
関連する記事とツール
- AI実務ベンチ「画像・写真の読み取り」のデータページ(2026年9月27日)
- ChatGPTの個別ページ
- Geminiの個別ページ
- Claudeの個別ページ
- Microsoft Copilotの個別ページ
- 議事録AIを4つ比較!要約プロンプト2つと選び方
- 画像読み取りAIを比較!GeminiとClaudeの違いと選び方
- ChatGPTの画像読み取りはどこまで正確?レシートを4段階に崩して照合した
レシートや表の数字を写す作業は、この回の3つのAIならほとんどの課題で正しい数字が返りました。気になったのは、同じレシートの小計は読めたGeminiがお釣りだけ2回とも金額を返さなかった点です。仕事で使うなら、最初の数回は元の画像と答えを突き合わせてください。答えが返らないときに備えて、別のAIでも確かめられるようにしておくと安心です。
- 画像の数字の読み取りがいちばん正確だったAIはどれですか?
- ChatGPTとClaudeが同率でした。ChatGPTは12試行のうち12試行が正解で、Claudeは13試行のうち13試行が正解です。正解率はどちらも100.0%で、Geminiは12試行のうち10試行(83.3%)でした。2026年9月27日の1回の測定なので、日や課題が変われば順位は変わります。
- Geminiはなぜレシートのお釣りを答えなかったのですか?
- 理由はこの測定では分かりません。1回目の答えは「大規模言語モデルとして私はまだ学習中であり、そちらには対応できません。」で、採点では断られた扱いです。2回目は「私はテキストベースのAIです。そちらに対応できる機能がありません。」で、お釣りの行が無く不正解でした。同じレシートの小計と品物の課題では、Geminiも2回とも正解しています。
- いちばん速く答えたAIはどれですか?
- 所要時間の中央値はClaudeがいちばん短く、ChatGPTの14.4秒とほぼ同じでした。Geminiの中央値は19.5秒です。Geminiの最長は36.6秒で、お釣りの課題で金額を返さなかった2回目でした。どのAIも答えは1分以内に返っています。
- Microsoft Copilotの結果はどうでしたか?
- この回はMicrosoft Copilotを測れていません。測定の途中で編集部のログインが切れたためで、AIの答えの良し悪しとは関係ありません。表のMicrosoft Copilotの欄は試行0で、ほかのAIと比べられる数字ではありません。4つのAIとも測れた回は、同じ連載の議事録の回で読めます。
- 無料版でも同じ結果になりますか?
- この測定では分かりません。使ったのはChatGPT Pro・Google AI Pro・Claude Max・Microsoft 365 Personalの有料版だけで、無料版は測っていないためです。課題の文と材料の画像はデータページから落とせます。手元の無料版に同じ文と画像を渡せば、自分で試せます。