資料の骨子を作る6課題を4つのAIへ各3回投げ、機械だけで採点しました。正解率はChatGPTが18試行中15試行(83.3%)で最も高い結果です。Microsoft Copilotは18試行中5試行で、行を分ける課題では答えの改行が消えて1行につながりました。
- 資料の骨子を作る6課題を2026年10月3日に4つのAIへ各3回投げ、72試行を機械だけで採点した結果
- 正解率はChatGPTが18試行中15試行(83.3%)で最も高く、Geminiが18試行中14試行(77.8%)で続いた
- Microsoft Copilotは18試行中5試行(27.8%)で、タイトル5行や骨子20行の答えは改行が消えて1行につながった
- Claudeは18試行中11試行(61.1%)で、JSONの課題は答えの前に余分な行が残って3回とも×だった
- 所要時間の中央値はMicrosoft Copilotの17.1秒が最も短く、Claudeは35.5秒かかった
- タイトルだけ・20行の骨子・JSONの3つの課題文を、そのままコピーして使える形で載せた
資料作成AIの比較はChatGPTが18試行中15試行で最多だった
資料の骨子づくりを任せるなら、どのAIが決まりを守ってくれるのか。AInformation編集部は2026年10月3日に、ChatGPT・Gemini・Claude・Microsoft Copilotの4つへ同じ6課題を3回ずつ投げました。機械だけで採点すると、正解率はChatGPTが18試行中15試行(83.3%)で最も高くなりました。
ほかの3つのAIの正解の数は次のとおりです。
- Gemini:18試行中14試行(77.8%)
- Claude:18試行中11試行(61.1%)
- Microsoft Copilot:18試行中5試行(27.8%)
いちばん差が出たのは、答えの改行でした。課題1はページのタイトルを5行で書く課題で、課題3と課題5は20行の骨子を作る課題です。この3つで、Microsoft Copilotの答えは3回とも1行につながっていました。採点は行の数を見るので、どれも×になっています。ほかの3つのAIは、同じ課題を3回とも決まりどおりの行数で返しました。
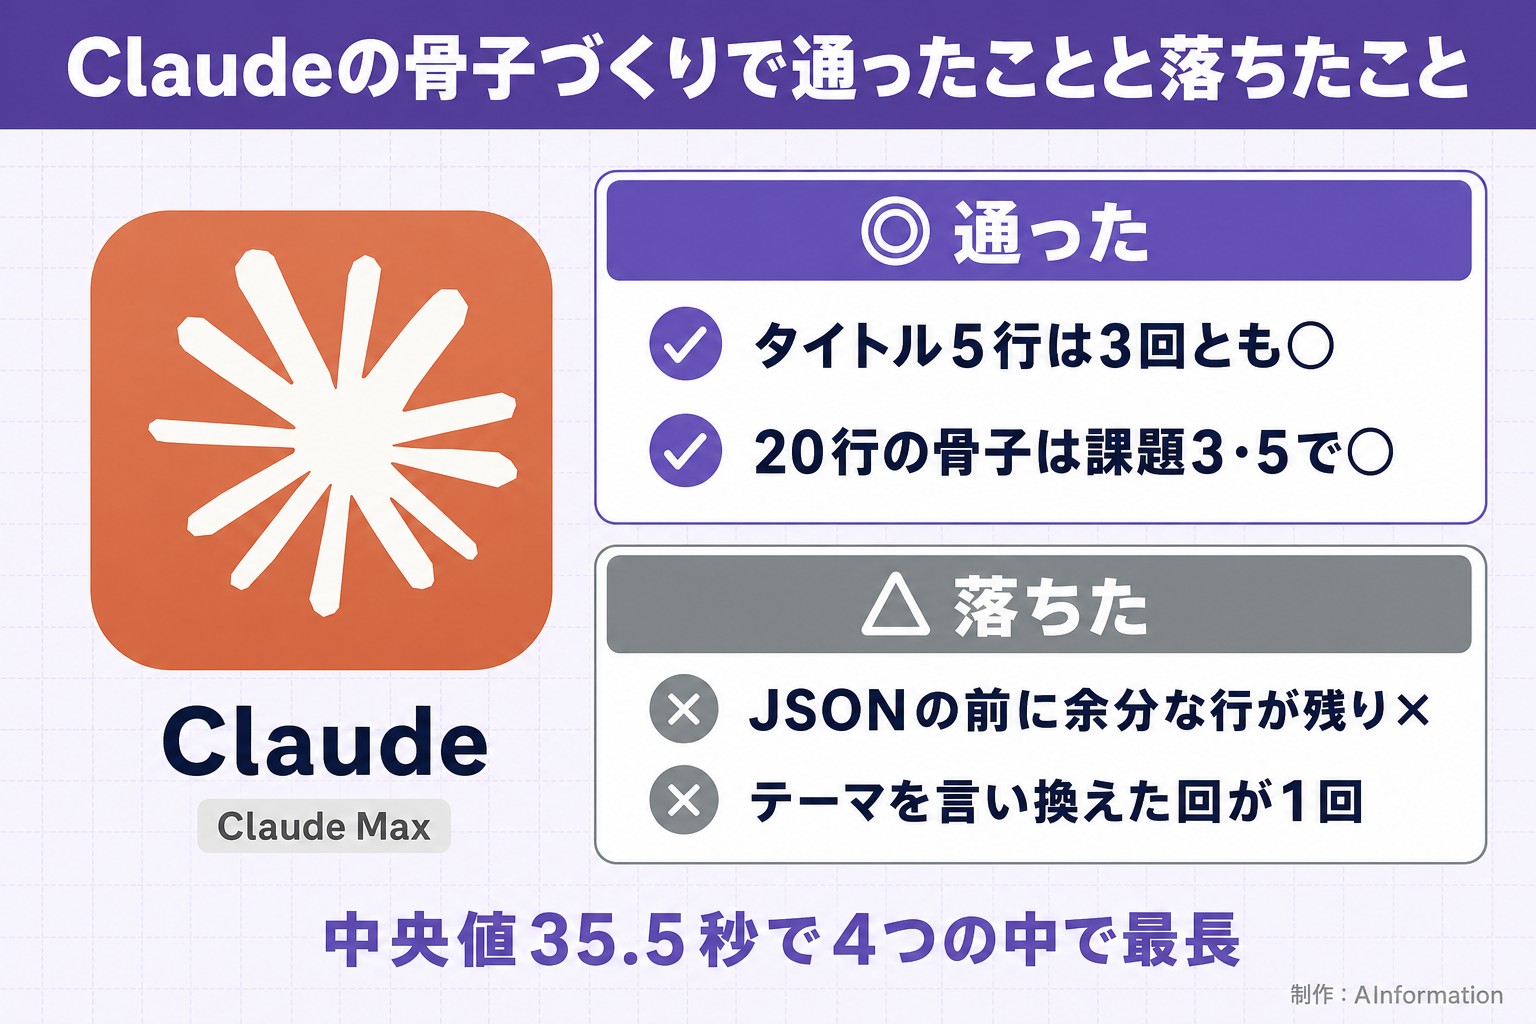
Claudeは、JSONで書き出す課題6を3回とも落としました。採点が読んだ答えの先頭に読み上げ用の行の残りや途中経過の1行が入り、JSONとして読めないと判定されたためです。所要時間の中央値もClaudeは35.5秒で、4つの中で最も長くかかりました。
一方で、マークダウンの表を頼んだ課題4は4つのAIとも3試行中0試行でした。画面には表が出ていましたが、採点は表と数えていません。この課題は4つの差を測れていないものとして読んでください。くわしくは課題4の章に書きました。
この記事の数字は採点表のままです。1回の測定なので、日や課題が変われば順位は変わります。1回ごとの答えと採点の理由は、この回の採点表と回答の全文で数え直せます。
資料の骨子づくり6課題を4つのAIへ3回ずつ投げた
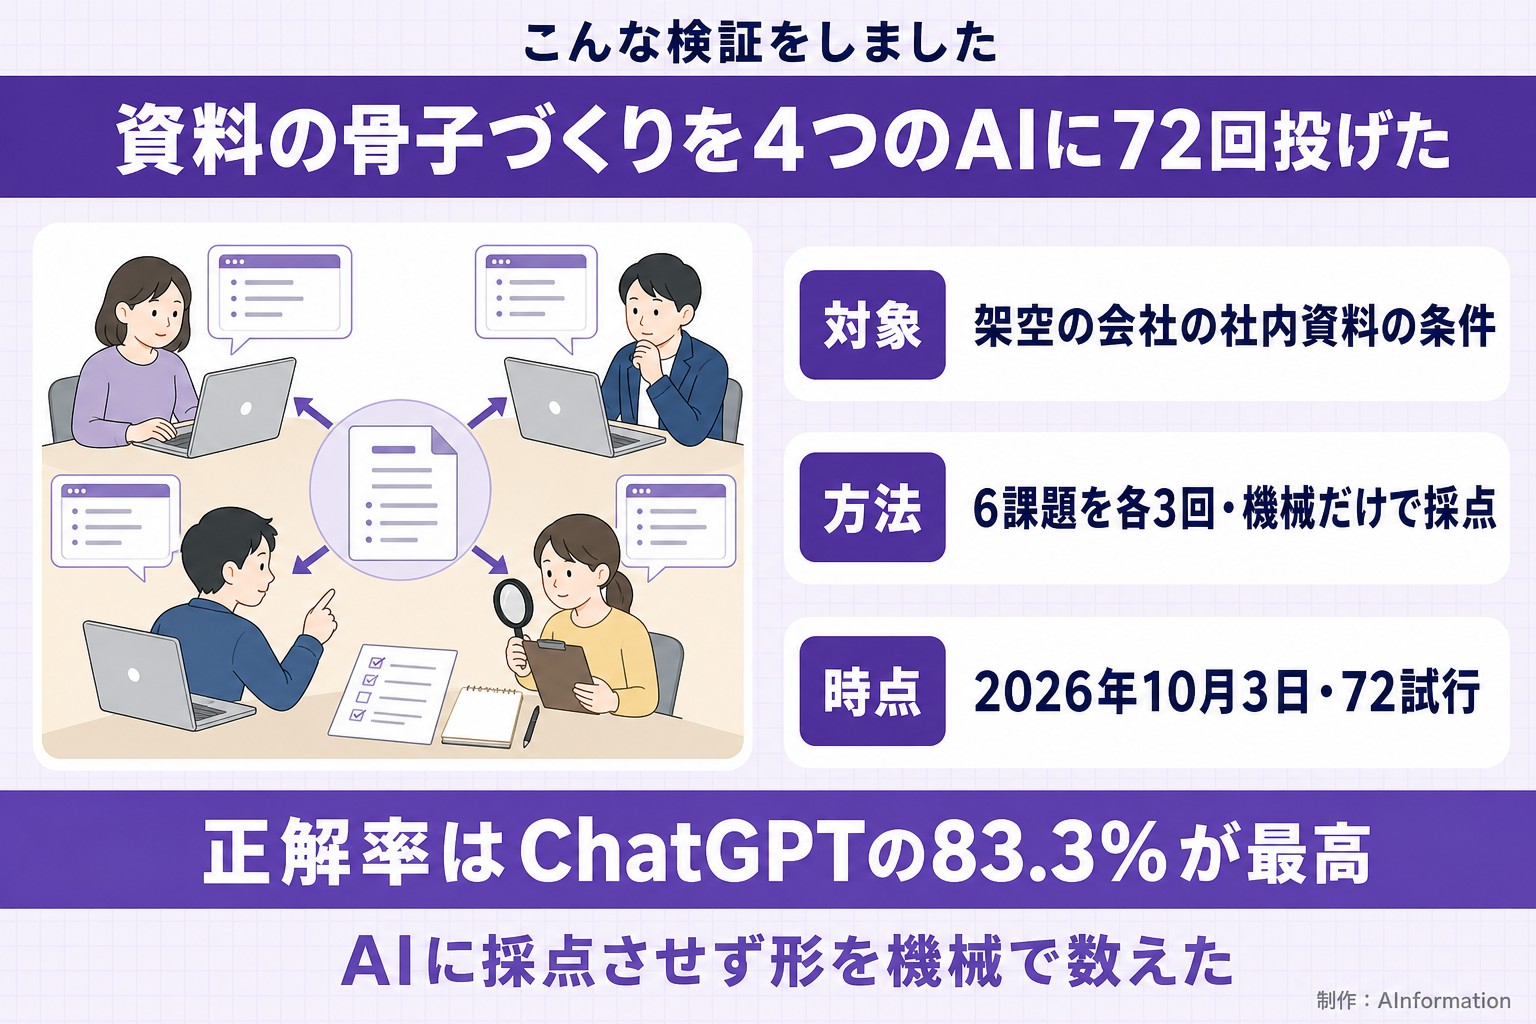
まずは、何をどう測ったのかです。材料は、架空の株式会社サンプル商事の社内資料の条件です。AIのテスト用に編集部が作った会社で、実在しません。6課題とも、次の同じ条件を使いました。
- テーマ:ECの年末施策の説明
- 相手:社内の部長6名
- 時間:10分
- ページ数:ちょうど5ページ
- 1ページの中身:タイトル1行と箇条書きちょうど3行
- 文字数:タイトルは18文字以内で箇条書きの各行は40文字以内
- 数字:入れられるところは数字を入れる
課題は易・中・難を2つずつ用意しました。どれも同じ資料について、答えの形だけを変えています。
- 課題1(易):各ページのタイトルだけを5行で書く
- 課題2(易):何について話す資料かを1行で答える
- 課題3(中):ページN: タイトルの行と・で始まる箇条書きで骨子を書く
- 課題4(中):ページとタイトルの2列のマークダウンの表にする
- 課題5(難):課題3の形に加えて、どの行も46文字を超えないようにする
- 課題6(難):決めた形のJSONだけを書き出す
毎回あたらしい会話を開いて順番も入れ替えた
1回ごとにあたらしい会話を開き、課題の文をそのまま送りました。投げる順番は、3回の繰り返しごとに入れ替えています。
- 1回目:ChatGPT→Gemini→Claude→Microsoft Copilot
- 2回目:Gemini→Claude→Microsoft Copilot→ChatGPT
- 3回目:Claude→Microsoft Copilot→ChatGPT→Gemini
測る前には4つとも、「はい」とだけ返してもらう空打ちを1回しています。この回は採点にも所要時間にも入れていません。答えを待つ上限は300秒(5分)でした。
採点は機械だけでAIには採点させていない
採点は機械だけで行い、AIには採点させていません。正解の形は、課題を作る時点で決まっています。課題2は、テーマの「ECの年末施策の説明」が答えに入っているかを見ました。残りの課題は、答えの形を次の物差しで数えています。
- 行の数(課題1は5行で、課題3と課題5は20行)
- 1行の文字数(課題1は18文字まで、課題5は46文字まで)
- 行の頭の形(ページN: か・で始まる)
- 表の列の数と行の数(課題4)
- JSONとして読めるかと、pagesがちょうど5件か(課題6)
見ているのは形だけです。箇条書きの中身がうまいかや、数字がもっともらしいかは採点していません。時間切れの試行は不正解として分母に入れ、この回に分母から外した試行はありませんでした。
画面から読み取った答えには、読み上げ用の1行や考えている途中の要約が混ざることがあります。そこで採点の前に、答えの先頭で繰り返された行を落としました。処理は4つのAIとも同じで、落とす前の答えもデータページに置いています。ただし落としきれずに残った行もあり、課題6のClaudeの採点に響きました。
4つのAIは有料版の既定のモデルのまま使った
使ったプランと、画面に出ていたモデルの表示は次のとおりです。
- ChatGPT:ChatGPT Pro(表示は「Medium」)
- Gemini:Google AI Pro(表示は「Flash-Lite」)
- Claude:Claude Max(表示は「Opus 4.8 高」)
- Microsoft Copilot:Microsoft 365 Personal(モデル名は画面から読み取れなかった)
どれも既定のモデルと既定のモードのままで、Deep Researchのような機能は使っていません。無料版の結果ではない点に気をつけてください。無料版と有料版で何が変わるかは、ChatGPTの無料版と有料版の違いの記事にまとめています。
なおMicrosoft Copilotの答えは、この記事では画面ではなく文字で紹介します。
6課題の○×はCopilotの改行とClaudeのJSONで分かれた
どの課題で差が出たのか。4つのAIの○×が分かれたのは、行の数を見る課題とJSONの課題でした。6課題の結果を表にまとめます。○は正解で、×は不正解です。時はGeminiの時間切れで、これも不正解に数えました。
6課題×各3回の結果(○正解・×不正解・時=時間切れ)
| 課題 | ChatGPT | Gemini | Claude | Microsoft Copilot |
|---|---|---|---|---|
| 課題1 タイトル5行(易) | ○○○ | ○○○ | ○○○ | ××× |
| 課題2 テーマの1行(易) | ○○○ | 時○○ | ○×○ | ×○○ |
| 課題3 骨子20行(中) | ○○○ | ○○○ | ○○○ | ××× |
| 課題4 マークダウンの表(中) | ××× | ××× | ××× | ××× |
| 課題5 骨子20行・46文字以内(難) | ○○○ | ○○○ | ○○○ | ××× |
| 課題6 JSON(難) | ○○○ | ○○○ | ××× | ○○○ |
| 正解の数 | 18試行中15 | 18試行中14 | 18試行中11 | 18試行中5 |
課題ごとに読むと次のとおりです。
- 課題1(タイトル5行):ChatGPT・Gemini・Claudeは3回とも○で、Microsoft Copilotは3回とも×
- 課題2(テーマの1行):ChatGPTだけが3回とも○で、ほかの3つは1回ずつ×
- 課題3(骨子20行):課題1と同じで、Microsoft Copilotだけが3回とも×
- 課題4(マークダウンの表):4つのAIとも3回とも×
- 課題5(骨子20行・46文字以内):課題3と同じで、Microsoft Copilotだけが3回とも×
- 課題6(JSON):Claudeだけが3回とも×で、ほかの3つは3回とも○
課題4を除くと、ChatGPTはすべての試行で○でした。Geminiが課題4のほかに×になったのは、課題2の1回目だけです。この1回は、答えの良し悪しとは別の理由で落ちています。表の1マスごとの答えと採点の理由は、この回の採点表と回答の全文で確かめられます。
課題2のGeminiの時間切れは依頼の文が送られていなかった
課題2は、条件の資料が何について話す資料かを1行で答える課題です。正解はテーマの「ECの年末施策の説明」でした。ChatGPTは3回とも、この10文字だけを返しています。
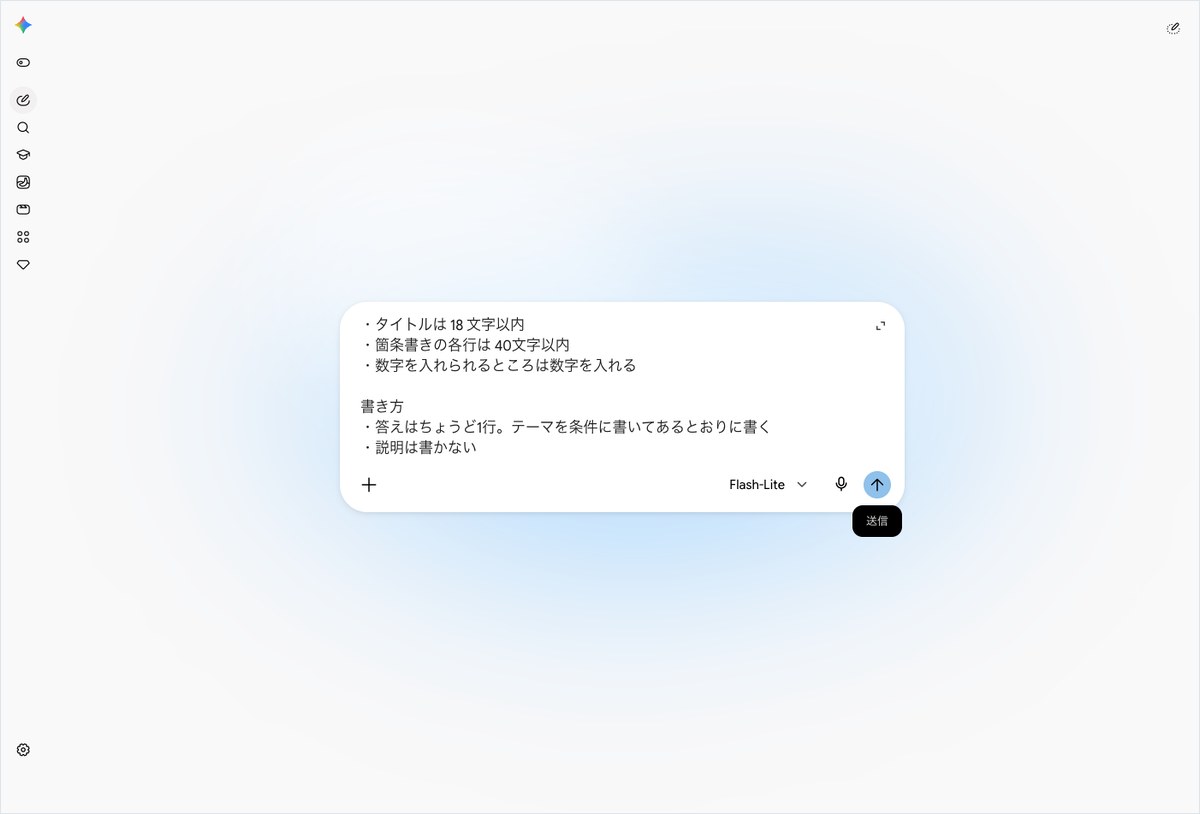
Geminiの1回目は、300.5秒で時間切れになりました。ただ画面を見ると、依頼の文は入力欄に残ったままです。会話は始まっておらず、Geminiの答えを測れた試行ではありません。採点表では決まりどおり、時間切れの不正解として分母に入れています。
Microsoft Copilotの1回目は、答えを見ると依頼の文が届いていませんでした。Copilotの答えは、HTMLの改行タグが送られたようだという内容です。続けて「ご質問や依頼内容をもう一度送ってください。」と返していました。採点表では不正解で、指示の遵守も×に数えています。
Claudeの2回目は、テーマを「EC(ネット通販)の年末施策の説明資料です。」と言い換えました。条件に書いてあるとおりの言葉が入っていないので×です。1回目は「株式会社サンプル商事のECの年末施策の説明」をかぎかっこに入れて答え、正解に数えました。
Copilotは課題1・3・5で改行が消えて3回とも×だった
骨子を行ごとに書いてほしいとき、AIは行を分けて返してくれるのか。この回のMicrosoft Copilotは、行を分ける課題1・課題3・課題5で毎回1行にまとめて返しました。ChatGPT・Gemini・Claudeは同じ課題を、3回とも決まりどおりの行数で返しています。
課題1はタイトル5行を18文字以内で書く
課題1は、資料の各ページのタイトルだけを書く課題です。投げた文は次のとおりで、そのままコピーして試せます。
次の条件を読んで、資料の各ページのタイトルだけを書いてください。
■ 資料の骨子をつくるための条件(架空・株式会社サンプル商事)
テーマ:ECの年末施策の説明
相手:社内の部長6名
時間:10分決まり
・ページ数はちょうど 5 ページ
・1ページにつき、タイトル1行と箇条書きちょうど 3 行
・タイトルは 18 文字以内
・箇条書きの各行は 40文字以内
・数字を入れられるところは数字を入れる書き方
・1ページにつき1行。タイトルの文字だけを書く
・行数は条件のページ数ちょうどにする
・1行の文字数は条件のタイトルの上限を超えない
・番号・記号・前置きは付けない
正解の形は、18文字以内のタイトルが5行並ぶ答えです。ChatGPTの1回目は「年末EC施策の全体像」から「期待効果と確認事項」までの5行でした。ChatGPTの所要時間は、3回とも17.2〜17.6秒に収まっています。
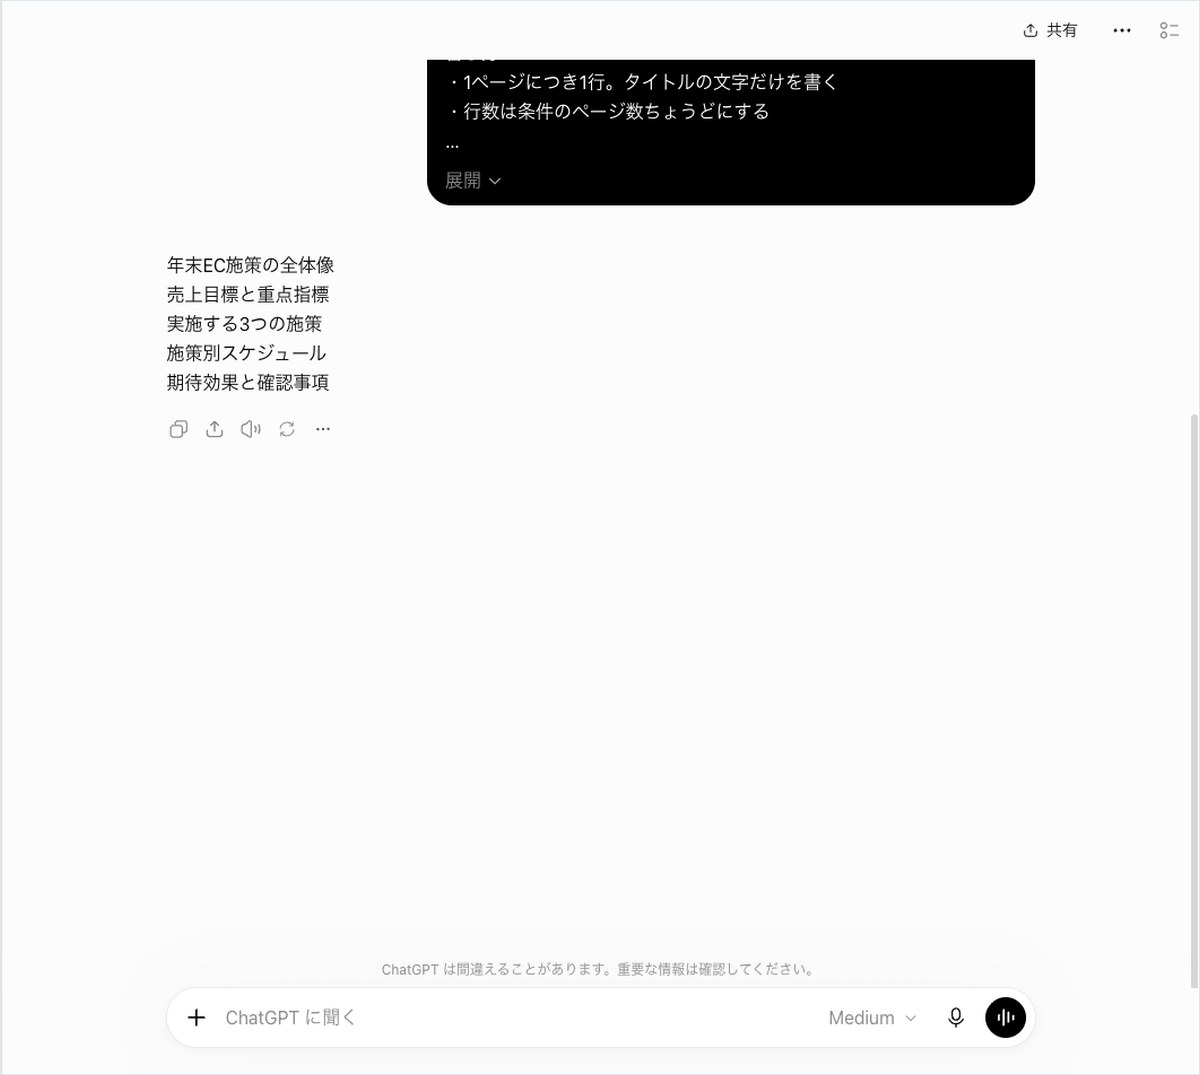
Microsoft Copilotの答えは、5つのタイトルが空白でつながった1行でした。1回目の答えは「年末EC施策の目的 市場動向と商機 施策全体像 販促強化プラン 目標と実行体制」です。採点表の理由は「行数 1」と「18文字を超える行 1本」でした。タイトルが1つずつ短くても、1行につながると18文字を超えてしまいます。
課題5は20行の骨子をどの行も46文字以内で書く
課題3と課題5は、ページN: タイトルの行と・で始まる箇条書きで骨子を作る課題です。正解の形は、全部でちょうど20行になる答えでした。難の課題5には、どの行も46文字を超えない決まりを足しています。
次の条件で、資料の骨子を作ってください。
■ 資料の骨子をつくるための条件(架空・株式会社サンプル商事)
テーマ:ECの年末施策の説明
相手:社内の部長6名
時間:10分決まり
・ページ数はちょうど 5 ページ
・1ページにつき、タイトル1行と箇条書きちょうど 3 行
・タイトルは 18 文字以内
・箇条書きの各行は 40文字以内
・数字を入れられるところは数字を入れる書き方
・1ページにつき ページN: タイトル の行を1行、その下に ・ で始まる箇条書きの行を条件の数だけ書く
・ページ数・箇条書きの数は条件のとおりちょうどにする
・どの行も46文字を超えない
・数字を入れられるところは数字を入れる。前置きと感想は書かない。空行も入れない
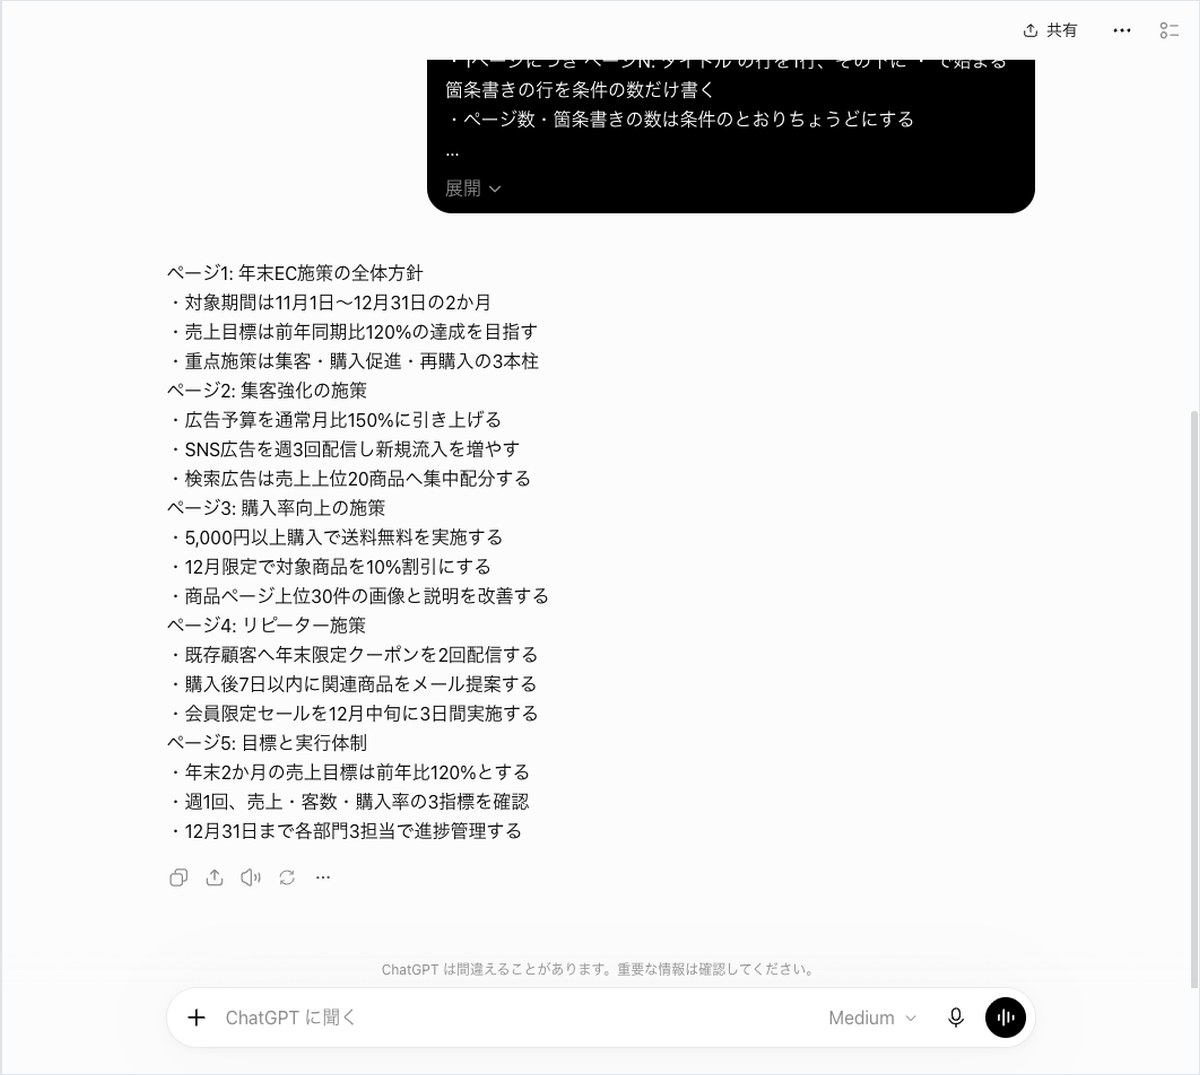
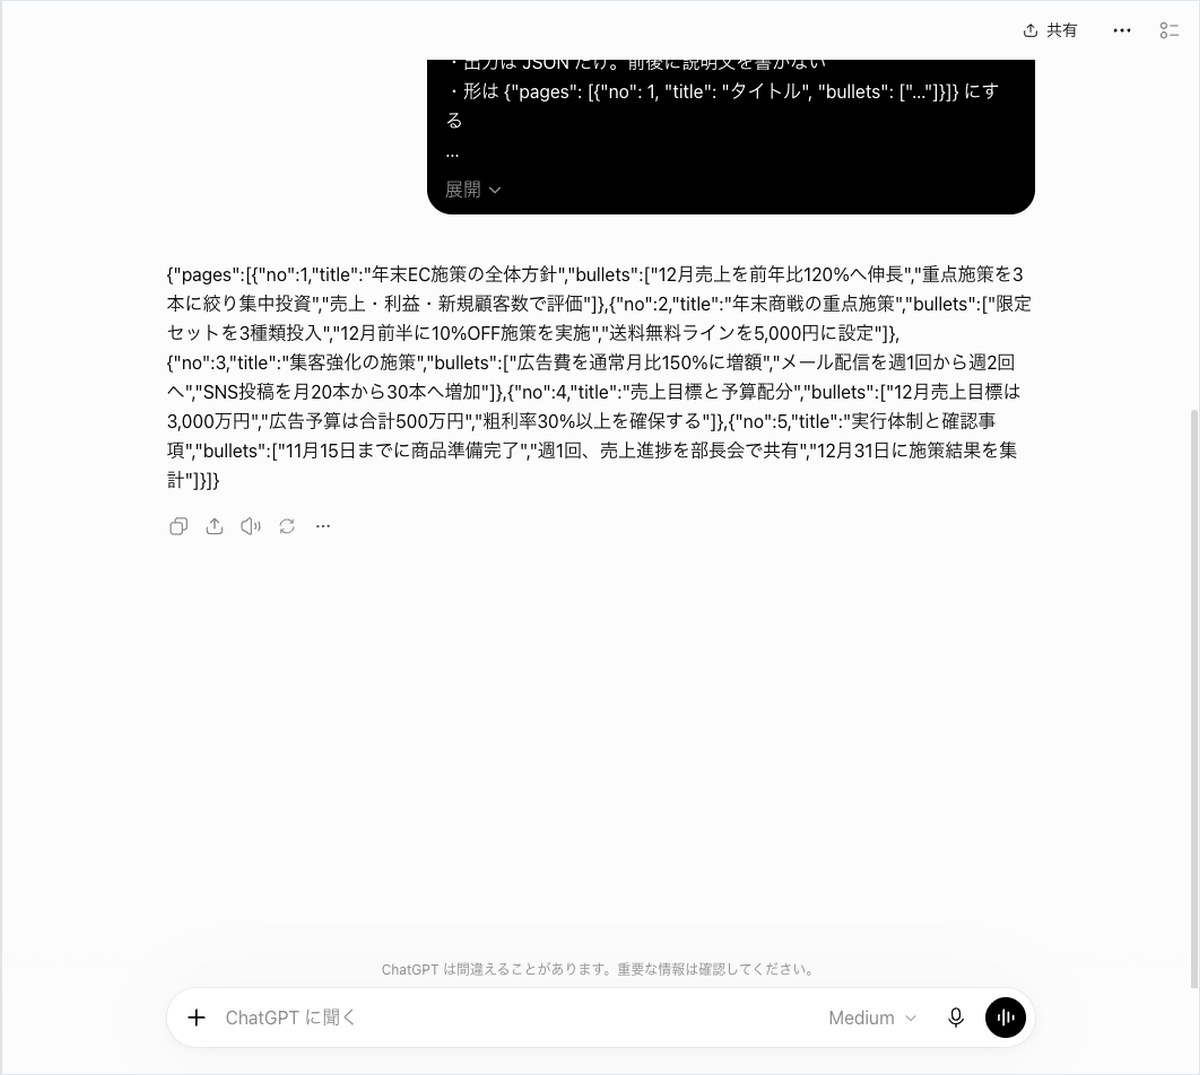
ChatGPT・Gemini・Claudeは、課題3も課題5も3回とも○でした。ChatGPTの課題5の1回目は「ページ1: 年末EC施策の全体方針」から始まる20行です。数字を入れる決まりにも沿って、「売上目標は前年同期比120%の達成を目指す」のような行が並びました。
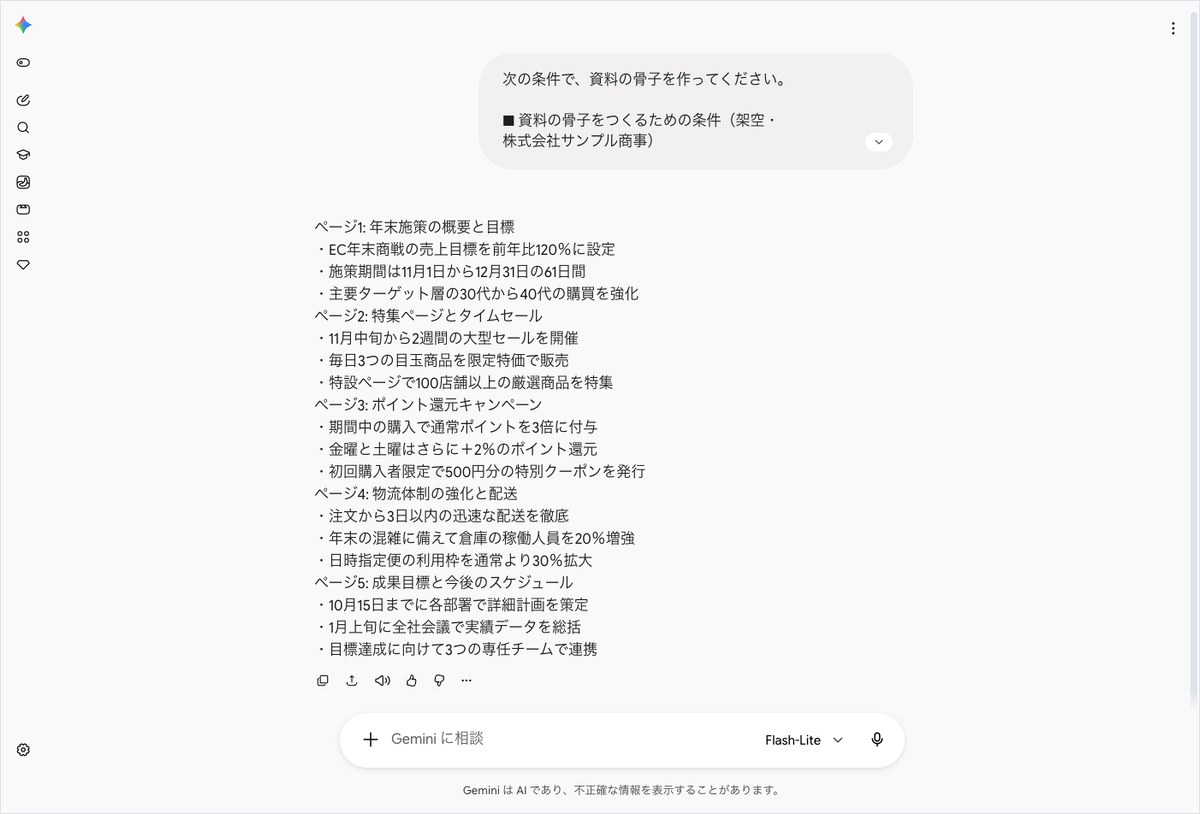
Geminiの課題3の答えも、ページ1からページ5まで・の箇条書きが3行ずつ並ぶ20行でした。課題5のGeminiは箇条書きが長めで、1回目の答えは全部で651字です。それでも46文字を超える行は無く、3回とも○でした。
Microsoft Copilotは、ここでも3回とも1行でした。課題5の1回目は「ページ1: 年末施策の目的 ・年末商戦でEC売上120%を目指す」のように、ページと箇条書きが空白でつながっています。課題3と課題5の1回目は、画面でも改行の無い1つの段落で表示されていました。行の頭の形は合っていましたが、行数は1と判定されています。
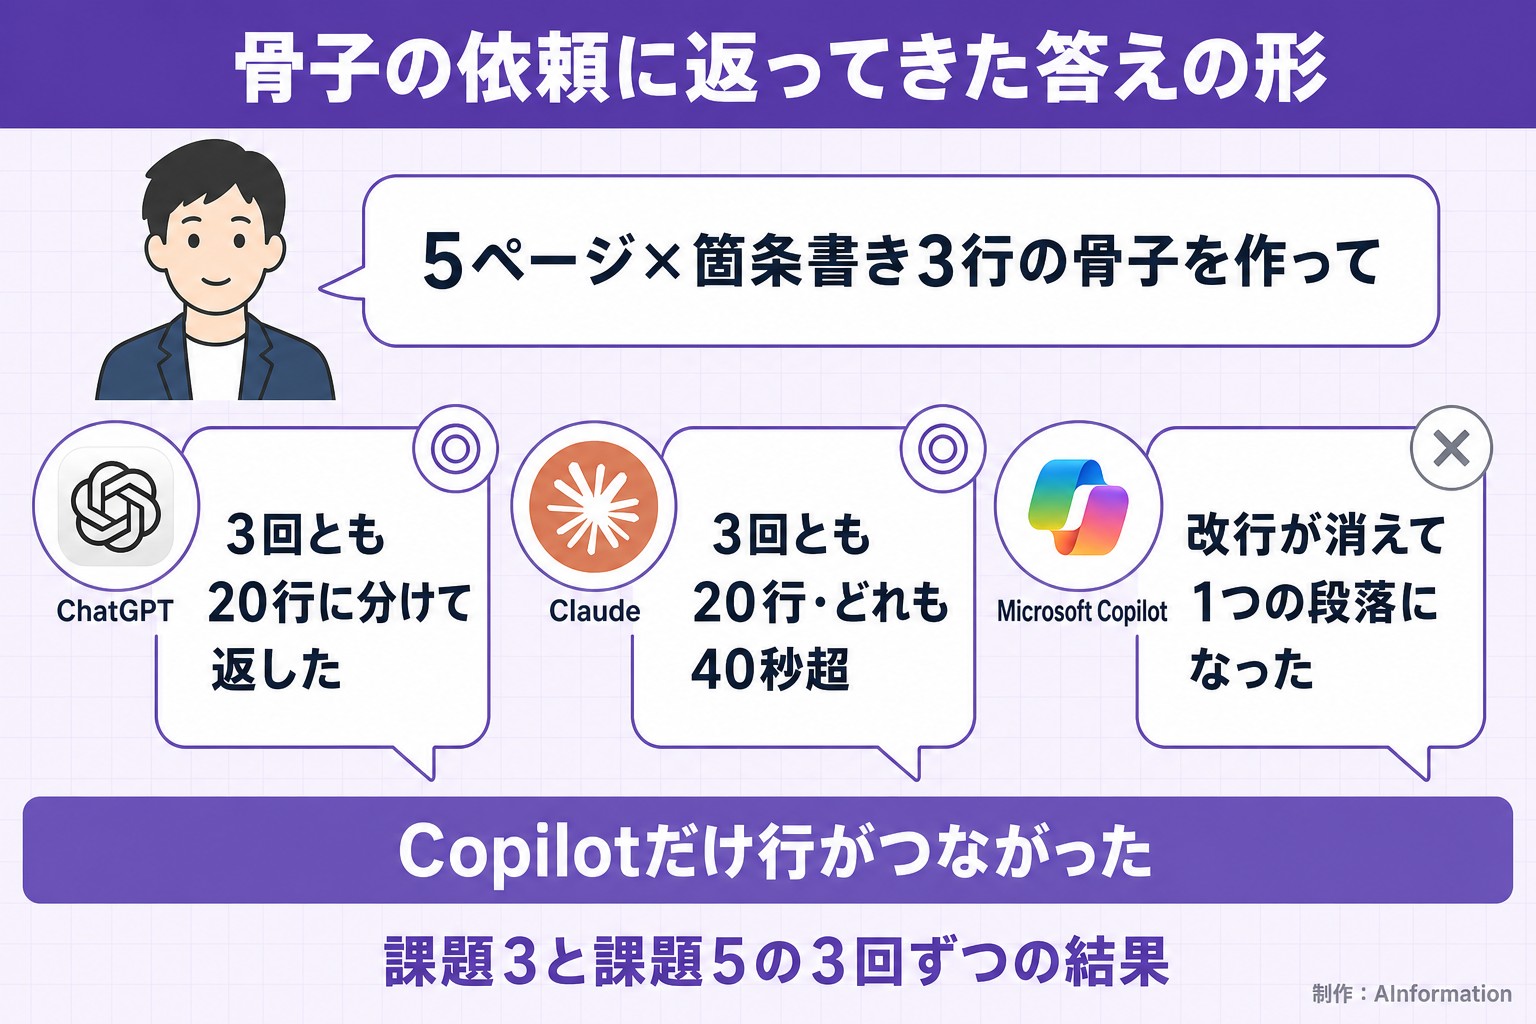
なぜ改行が消えたのかは、この測定では分かりません。JSONで書き出す課題6は、1行のままでも読める形です。Microsoft Copilotはその課題6を3回とも正解しました。
Claudeは20行の骨子で毎回40秒を超えた
Claudeは課題3と課題5を3回とも○で通しましたが、時間がかかりました。所要時間は課題3が41.8〜47.9秒で、課題5は47.8〜51秒です。同じ2つの課題を、ChatGPTは20.3〜23.6秒で返しています。Geminiは19.2〜19.4秒でした。
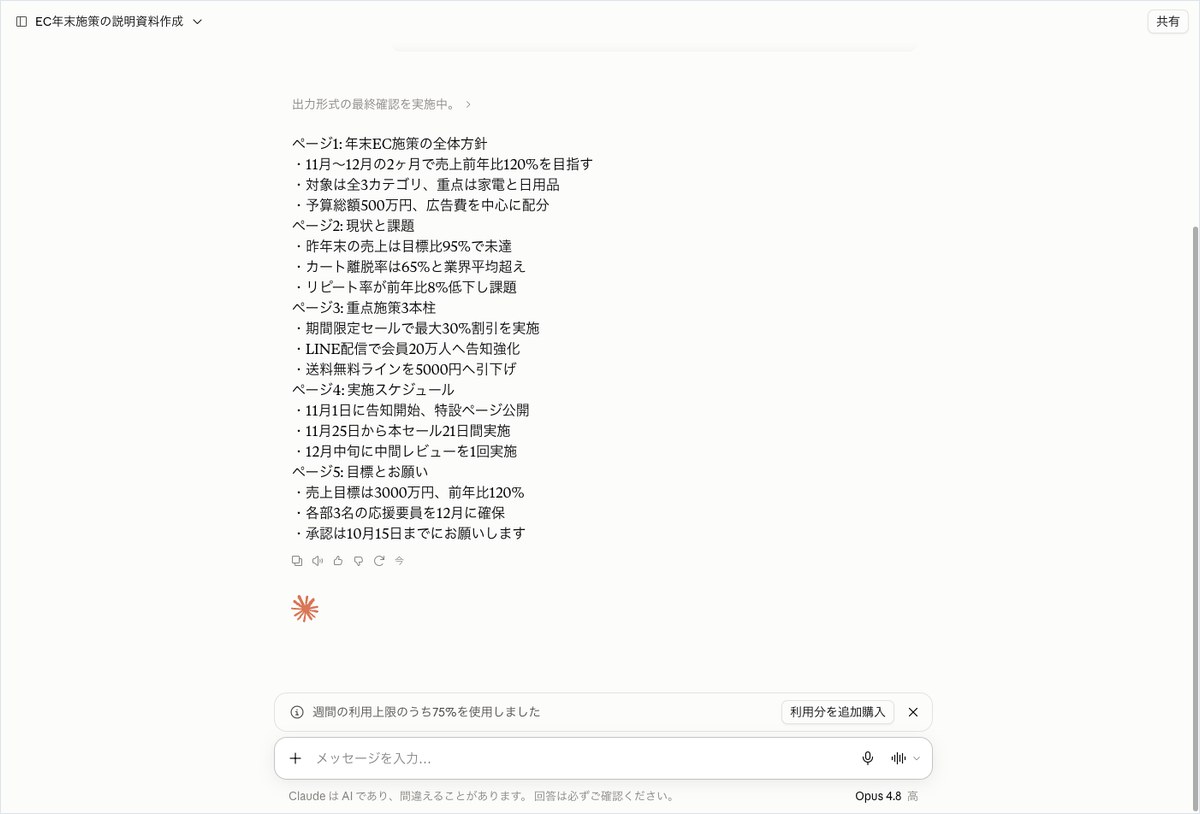
Claudeの画面では、答えの上に灰色の1行が出ます。課題5の1回目は「出力形式の最終確認を実施中」でした。答えの本文とは別に出る、考えている途中の要約です。この要約の行は、次の課題6の採点にも響きました。
課題6のJSONはClaudeだけ余分な行が残って3回とも×
骨子をJSONで受け取れば、表計算や別のツールへそのまま流せます。では、JSONだけを返してくれるのはどれか。課題6はChatGPT・Gemini・Microsoft Copilotが3回とも○で、Claudeは3回とも×でした。
次の条件で資料の骨子を作り、JSON だけを出力してください。
■ 資料の骨子をつくるための条件(架空・株式会社サンプル商事)
テーマ:ECの年末施策の説明
相手:社内の部長6名
時間:10分決まり
・ページ数はちょうど 5 ページ
・1ページにつき、タイトル1行と箇条書きちょうど 3 行
・タイトルは 18 文字以内
・箇条書きの各行は 40文字以内
・数字を入れられるところは数字を入れる書き方
・出力は JSON だけ。前後に説明文を書かない
・形は {"pages": [{"no": 1, "title": "タイトル", "bullets": ["…"]}]} にする
・pages の数は条件のページ数ちょうどにする
・bullets の数は条件の箇条書きの数ちょうどにする
正解の条件は次の3つです。
- JSONとして読める
- pagesのキーがある
- pagesの数がちょうど5件
ChatGPTは3回とも、前後に説明を付けずにJSONのかたまりだけを返しました。所要時間は20.5〜23.6秒です。Geminiは1つの項目ごとに改行を入れた形で返し、こちらも3回とも読めました。Microsoft Copilotも3回とも○で、所要時間は17〜20.2秒でした。
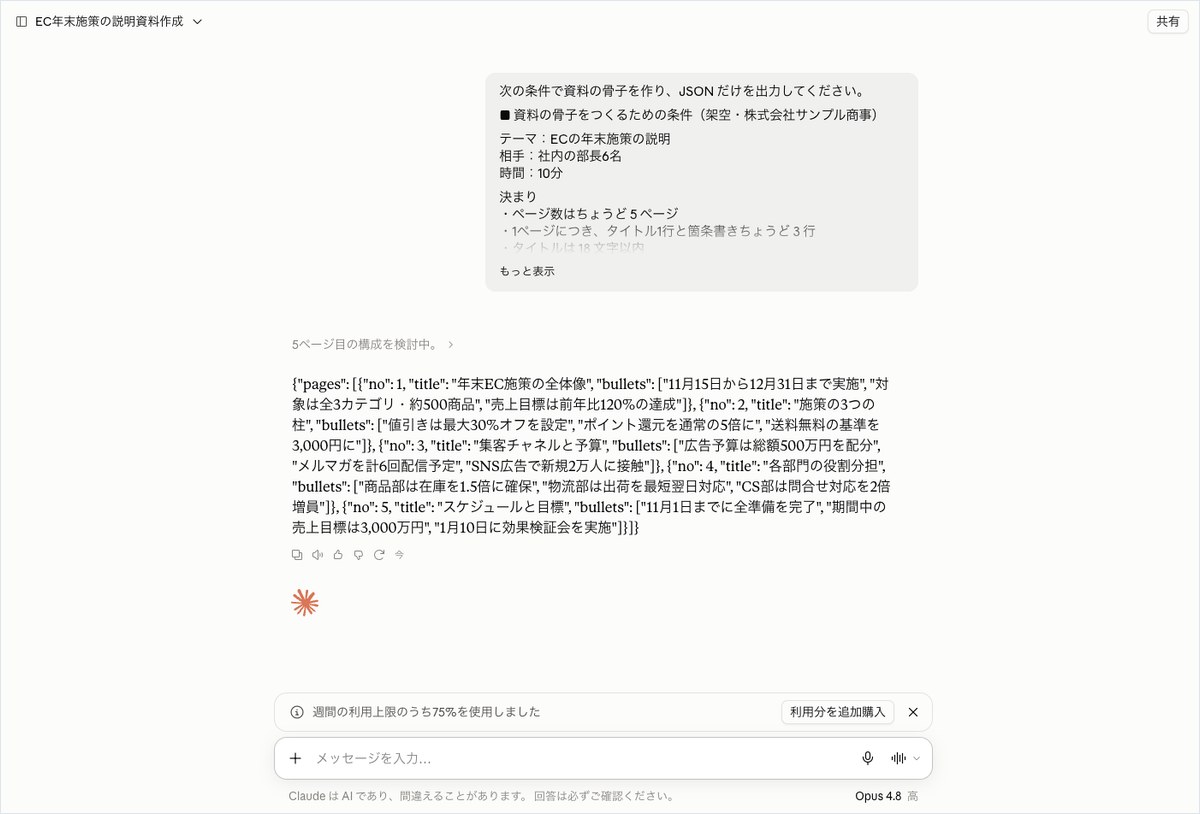
ClaudeはJSONの前に読み上げ用の行と要約が残った
Claudeの3回は、採点表の理由がどれも「JSONとして読めない」でした。採点が読んだ答えには、JSONの本体の前に次の2つが残っています。
- 読み上げ用の行の残り:JSONの書き出しを写した行で、途中が「…」で切れている
- 考えている途中の要約の1行:1回目は「5ページ目の構成を検討中。」で、3回目は「在庫と物流の文字数を確認中。」
採点の前に落とすのは、読み上げ用の行の頭にある「Claudeが返答しました:」の部分だけです。続く書きかけのJSONが残ったため、答え全体がJSONとして読めないと判定されました。読み上げ用の行は画面には出ず、読み取った文字にだけ入っています。
画面では、JSONの上に灰色の要約の1行が出ているだけでした。JSONの本体には、pagesに5ページ分が並んでいます。
コピーボタンで取った答えにこれらの行が入るかどうかは、この測定では確かめていません。Claudeの答えを別のツールへ流すなら、先頭の行を確かめてから貼ると安心です。
課題4の表は4つのAIとも0試行で差を測れなかった
骨子をマークダウンの表でもらえるのか。課題4はページとタイトルの2列の表を頼む課題で、4つのAIとも3試行中0試行でした。ただしこの0試行は、AIが表を作れなかったという意味ではありません。
1回目の画面を見ると、ChatGPT・Gemini・Claudeの答えにはページとタイトルの2列の表が出ていました。どれも5ページ分のタイトルが入っています。Microsoft Copilotの画面は、この記事には載せていません。
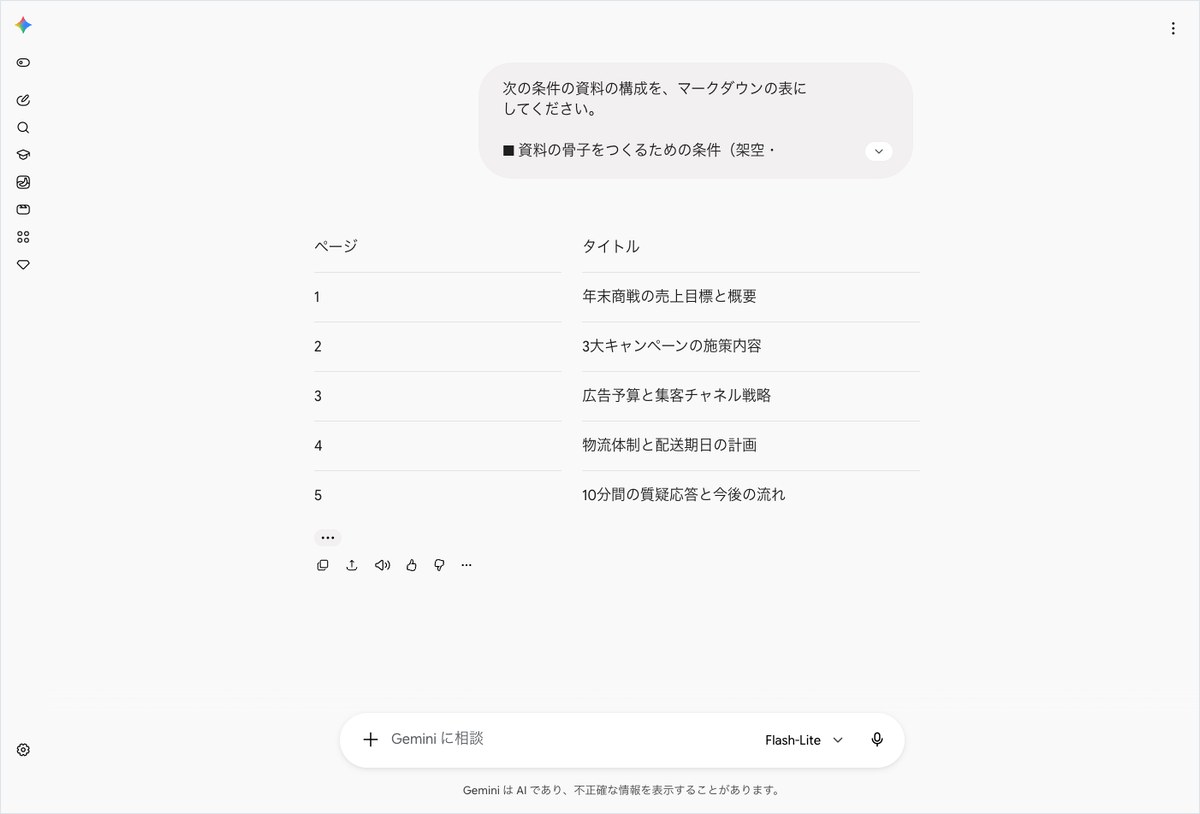
採点は、画面から読み取った文字に | で区切ったマークダウンの表の行があるかを見ています。画面に表として出た答えは、読み取ると | の無い文字になりました。そのため4つのAIとも、3回とも理由は「表が無い」です。
行の数も、決まりの7行に合ったのはClaudeだけでした。Claudeは表の上の途中経過の1行まで読み取られ、ちょうど7行になっています。ChatGPTは3回とも6行と数えられました。Microsoft Copilotは読み取った答えに箇条書きの行まで入り、3回とも21行です。Geminiも3回目は箇条書きが入り、26行と数えられました。
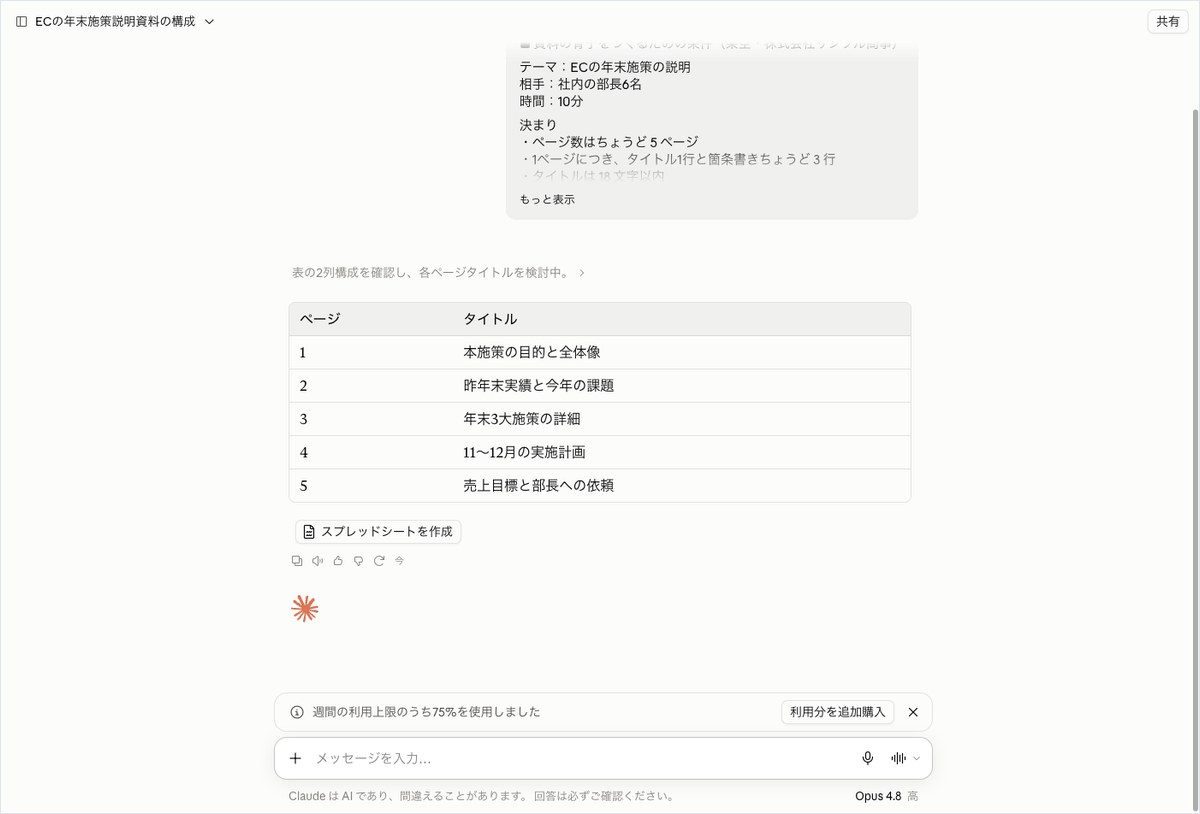
表で骨子をもらう使い方では、この回は4つの差を測れていません。表がほしいときは、貼り付け先で列が2つに分かれているかを確かめてください。Claudeの画面には、表の下に「スプレッドシートを作成」のボタンも出ていました。
5つの指標の比較は正解率と所要時間で差が開いた
正解率のほかに、AInformation編集部は4つの指標を測っています。5つを並べると、差が大きく開いたのは正解率と所要時間でした。再現率と指示の遵守率は、4つのAIとも88.9%以上です。出典の実在率は、この分野ではURLを見る課題が無いので測っていません。
正解率はChatGPTが83.3%でCopilotが27.8%
正解率は、6課題×3回の18試行のうち正解した割合です。ChatGPTが18試行中15試行(83.3%)で最も高く、Geminiは18試行中14試行(77.8%)でした。Claudeは18試行中11試行(61.1%)です。Microsoft Copilotは18試行中5試行(27.8%)で、4つの中でいちばん低くなりました。
所要時間の中央値はCopilotの17.1秒が最短
所要時間は、1試行ごとにかかった秒数の真ん中の値(中央値)で比べています。最も短かったのはMicrosoft Copilotの17.1秒です。Geminiは19.3秒で、ChatGPTは20.4秒でした。Claudeは35.5秒で、いちばん長い試行は課題5の3回目の51秒です。
Geminiは時間切れの1試行を除くと、19.1〜22.5秒に収まっています。ばらつきが小さいのはGeminiで、Claudeは13.9〜51秒と幅が広くなりました。そのClaudeも1行で答える課題2では、13.9〜14.1秒と4つの中で最も速く答えています。
再現率はChatGPTとGeminiが100%
再現率は、同じ課題を3回投げたときに結果がそろったかの割合です。ChatGPTとGeminiは100%で、ClaudeとMicrosoft Copilotは88.9%でした。下がった2つは、どちらも課題2で3回のうち1回だけ結果が違っています。Claudeは言い換えた2回目で、Microsoft Copilotは依頼の文が届かなかった1回目でした。
Microsoft Copilotの課題1・課題3・課題5は3回とも×でしたが、3回そろって同じ×です。そのため再現率は下げていません。再現率は毎回同じ答え方をするかを表す数字です。正しいかどうかは正解率で見てください。
指示の遵守率はCopilotの94.4%を除いて100%
指示の遵守率は、答えの外側の書き方の決まりを守ったかの割合です。この分野で見たのは次の3つでした。
- 課題1・課題3・課題4・課題5:答えをコードの枠(“`)で囲まない
- 課題2:答えはちょうど1行で80文字まで
- 課題6:答えは2500文字まで
ChatGPT・Gemini・Claudeは100%でした。Microsoft Copilotの94.4%は、依頼の文が届かなかった課題2の1回目だけが×になった結果です。行が1つにつながった答えも、コードの枠では囲んでいないので遵守は○でした。改行の崩れは、遵守率ではなく正解率のほうに表れています。
出典の実在率はこの分野では測っていない
出典の実在率は、AIが示したURLが実際に開けるかを見る指標です。資料の骨子づくりの6課題にはURLを見る課題が無いため、4つとも測っていません。表や横棒にも数字を入れていません。
骨子をそのまま使うならChatGPTとGeminiが崩れにくかった
では、資料の骨子づくりはどれに任せればよいのか。この回の実測から、使い方ごとに分けて書きます。1回の測定の結果なので、決める前に手元でも同じ文を試してください。
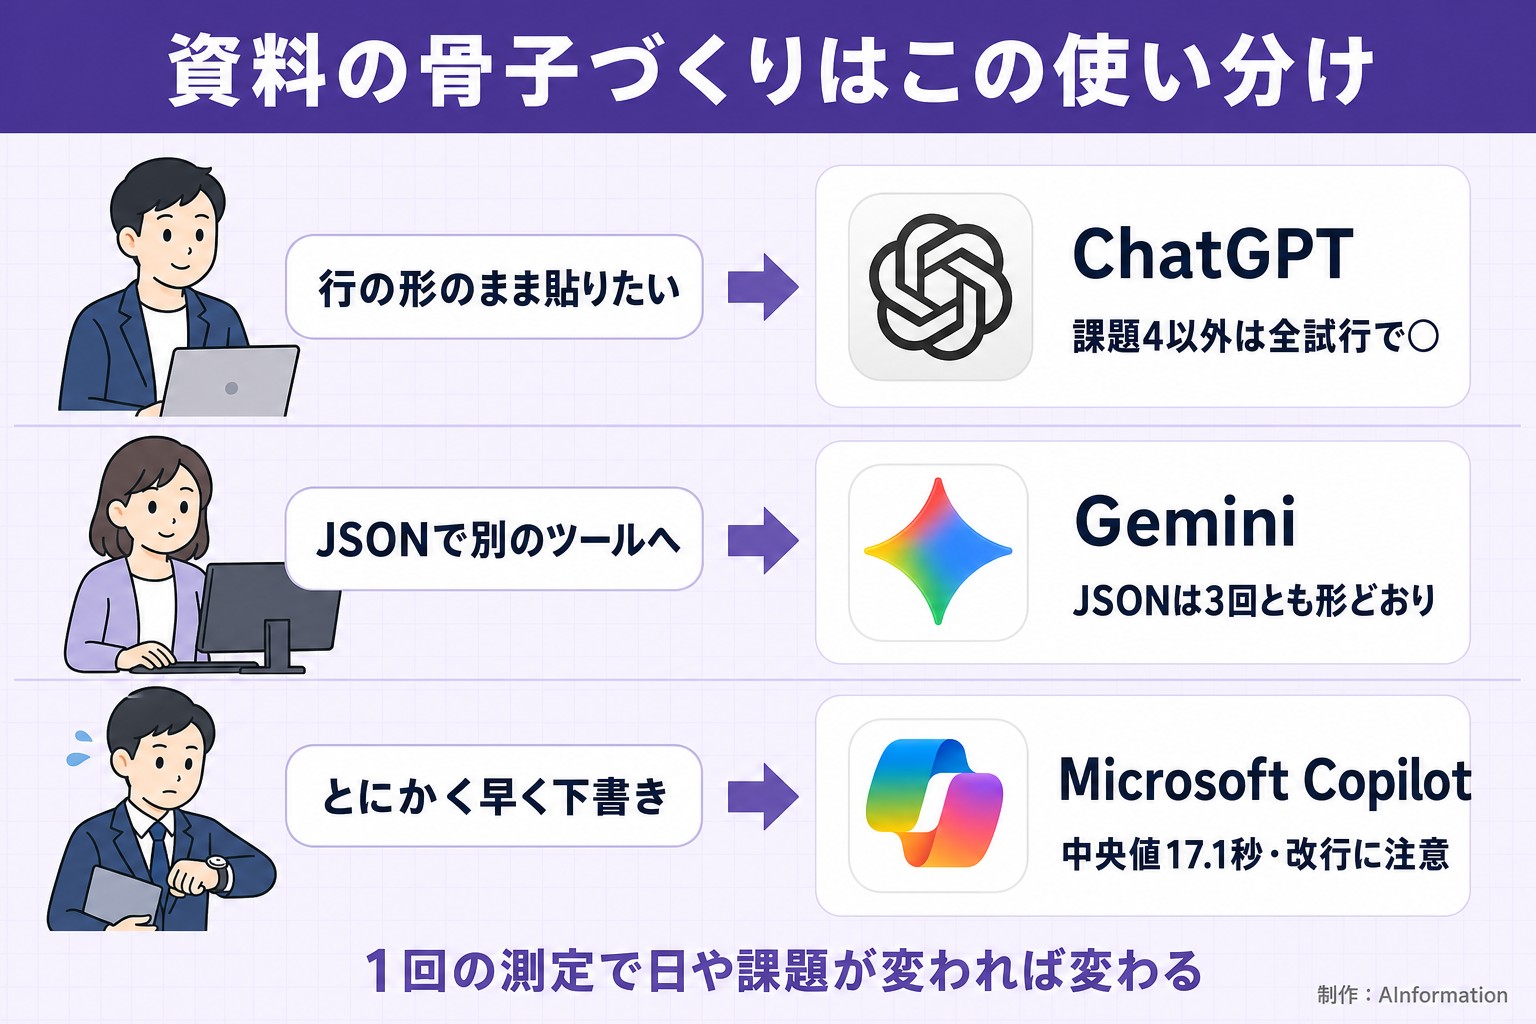
行の形を崩したくないならChatGPTかGemini
タイトルの行や箇条書きを、そのままスライドへ貼りたい人向けです。ChatGPTは課題4を除くすべての試行で○で、再現率も100%でした。Geminiも課題4と、送信が通らなかった1回を除けば全部○です。所要時間の中央値は、ChatGPTが20.4秒でGeminiが19.3秒でした。
JSONで受け取るならClaudeは先頭の行に気をつける
骨子をJSONで受け取って別のツールへ流すなら、ChatGPT・Gemini・Microsoft Copilotが3回とも形どおりでした。Claudeも画面にはJSONの本体を出していましたが、採点が読んだ答えにはJSONの前に余分な行が残っていました。Claudeを使うときは、貼る前に先頭の行を確かめる手順を入れておいてください。
速さを取るならCopilotだが改行を確かめる
所要時間の中央値が最も短かったのは、Microsoft Copilotの17.1秒です。ただ行を分ける課題では、答えが1行につながりました。Microsoft Copilotで骨子を作るなら、貼り付けたあとにページごとの改行を入れ直す前提で使うことになります。JSONで受け取る使い方なら、この回は3回とも形どおりでした。
Claudeは行の形を守るが時間がかかる
Claudeは課題1・課題3・課題5を、3回とも決まりどおりの行数で返しました。一方で所要時間の中央値は35.5秒で、ほかの3つより長くかかります。課題2では、テーマを言い換えた回が1回ありました。条件の言葉をそのまま使ってほしい場面では、答えの言葉を一度見直してください。
この測定の限界は1日1回と有料版と画面からの採点
この記事の数字は、2026年10月3日の1回の測定から出したものです。読むときに気をつけてほしい点を、測定の決まりから挙げます。
- 1日1回の測定です。日や課題が変われば順位は変わります
- プランは各AIの有料版で、無料版の結果ではありません
- 既定のモデルと既定のモードだけで測り、Deep Researchなどは使っていません
- 課題は架空の株式会社サンプル商事の自作データで、実在の企業のデータではありません
- 機械で採点できる形だけを見ています。箇条書きの中身のうまさや読みやすさは測っていません
- ブラウザで人が使うのと同じ画面から測っていて、APIの結果ではありません
- 画面にモデル名が出なかったMicrosoft Copilotは、モデルの欄を空にしています
この回だけの注意もあります。どれも採点表のまま載せていて、数え直してはいません。
- 課題4は画面に出た表を採点が表と数えられず、4つのAIとも×になった
- Geminiの課題2の1回目は依頼の文が送られないまま、時間切れに数えている
- Microsoft Copilotの課題2の1回目は依頼の文が届かず、不正解に数えている
課題の全文と答えと採点表はデータページから落とせる
課題の全文・材料・4つのAIの答えの全文・1行=1試行の採点表(CSV)・撮った画面は、データページから落とせます。同じ数え方で読者が確かめられるようにするためです。1回ごとの答えと採点の理由は、この回の採点表と回答の全文から見られます。
数字を引用するときは、出典としてAInformation調べとデータページのURL・測定日を書いてください。データはCC BY 4.0で公開しています。同じ連載では、議事録・翻訳・画像の読み取り・表の集計も同じ方法で測りました。
関連する記事とツール
- AI実務ベンチ:資料の骨子づくりの採点表と回答の全文
- ChatGPT(AIツールデータベース)
- Gemini(AIツールデータベース)
- Claude(AIツールデータベース)
- Microsoft Copilot(AIツールデータベース)
- データ分析AIを4つ比較!売上表の集計プロンプト3つと選び方
- AI翻訳の精度を4つ比較!そのまま使える翻訳プロンプト2つ
- AIの画像読み取り精度を比較!そのまま使えるプロンプト3つ
- Beautiful.aiでプレゼン資料を作った記事
- SlidesAIでスライドを作る流れ
資料の骨子をAIに任せるときは、中身より先に形が崩れていないかを見てください。この回の差は、行の区切りとJSONの前に残る余分な行という形の部分で出ました。骨子をそのままスライドに貼るなら、表の課題4を除く全試行で○だったChatGPTが扱いやすい結果です。速さで選ぶならMicrosoft Copilotです。ただ行が1つにつながる答えが続いたので、貼る前に改行を確かめる手順を入れておくと作業が止まりません。
- 資料の骨子づくりでいちばん正確だったAIはどれですか?
- この回はChatGPTです。6課題を各3回投げて、18試行のうち15試行(83.3%)が正解でした。Geminiは18試行中14試行(77.8%)で、Claudeは18試行中11試行(61.1%)です。Microsoft Copilotは18試行中5試行(27.8%)でした。ChatGPTが×になったのは表の課題4だけで、この課題は4つのAIとも0試行です。2026年10月3日の1回の測定なので、日や課題が変われば順位は変わります。
- Microsoft Copilotで資料の骨子を作ると改行が消えるのですか?
- この回は消えました。Copilotの答えは課題1・課題3・課題5で、3回とも1行につながっています。課題1はタイトル5行で、課題3と課題5は20行の骨子を作る課題です。課題3と課題5の1回目は画面でも改行の無い1つの段落で表示され、行の数を見る採点ではどれも×でした。JSONで書き出す課題6は3回とも正解です。なぜ改行が消えたのかは、この測定では分かりません。
- ClaudeはJSONを出せないのですか?
- JSONの本体は画面に出ていました。採点が読み取った答えでは、本体の前に2つの行が残っています。読み上げ用の行に入っていた書きかけのJSONと、「5ページ目の構成を検討中。」のような途中経過の1行です。そのため3回とも「JSONとして読めない」と判定されました。コピーボタンで取った答えにこれらの行が入るかは、この測定では確かめていません。
- マークダウンの表を頼んだ課題4が4つとも0試行なのはなぜですか?
- 画面に出た表を、採点が表と数えられなかったためです。ChatGPT・Gemini・Claudeの1回目の画面には、ページとタイトルの2列の表が出ていました。採点は読み取った文字に | で区切った表の行があるかを見ます。表として表示された答えは読み取ると | が残らず、4つとも「表が無い」と判定されました。この課題では4つのAIの差を測れていません。
- 無料版のAIでも同じ結果になりますか?
- この測定では確かめていません。使ったのはChatGPT Pro・Google AI Pro・Claude Max・Microsoft 365 Personalの有料版で、既定のモデルとモードのままです。ブラウザの画面から測ったので、APIで使ったときの結果でもありません。課題の全文はこの記事とデータページにあるので、手元のプランで同じ文を試せます。