
2026年11月3日に画像の数字を読む6課題を4つのAIへ3回ずつ投げると、Claudeは18試行中18試行(100.0%)が正解でした。ChatGPTは18試行中13試行(72.2%)です。Geminiは10試行が時間切れで、Copilotは18試行とも上限の表示でした。
- 2026年11月3日に画像の数字を読む6課題を4つのAIへ3回ずつ投げ、72試行を機械で採点した
- Claudeは18試行中18試行(100.0%)が正解で、所要時間の中央値は13.9秒だった
- ChatGPTは18試行中13試行(72.2%)が正解。落とした回のうち4試行は300秒の時間切れだった
- Geminiは18試行中7試行(38.9%)が正解。18試行のうち10試行が時間切れだった
- Microsoft Copilotは18試行とも「1日の上限に達しました」の表示で、画像を読んだ答えは返らなかった
- レシート・棒グラフ・傾いた表を読ませるプロンプト3つを、そのままコピーして試せる
GoogleでフォローするGoogle検索でAInformationの記事が出やすくなります
画像読み取りの精度はClaudeが18試行中18試行だった
正解の基準は、課題ごとに決めた数や品物を1つも違えずに答えた回だけを○とすることです。この基準で数えると、Claudeは18試行中18試行(100.0%)が正解でした。レシート・棒グラフ・傾いた表のどれでも、3回とも同じ数を返しています。
2位はChatGPTで、18試行中13試行(72.2%)でした。落とした回のうち4試行は3回目の課題3〜6で、300秒の制限時間まで答えが止まりませんでした。残りの1回は傾いた表の課題です。数は全部正しいのに、行の頭の書き方が採点の目印と合いませんでした。
Geminiは18試行中7試行(38.9%)でした。10試行が時間切れになり、1試行は「そちらに対応できるようにはプログラムされていません。」と返しています。ただし数を書いて返した回に、読み違いはありませんでした。
Microsoft Copilotは18試行とも「1日の上限に達しました」の表示でした。採点表の正解率は0%(18試行中0試行)ですが、画像を読む力を測れた数字ではありません。
いちばん差が出たのは、数を読み違えるかどうかよりも「答えが返ってくるか」でした。Claudeは時間切れが0回で、所要時間の中央値は13.9秒です。課題の全文・4つのAIの回答72本・1行=1試行の採点表(CSV)・画面は、この回の採点表と回答の全文からすべて落とせます。
測り方は6課題を4つのAIへ3回ずつ投げる72試行
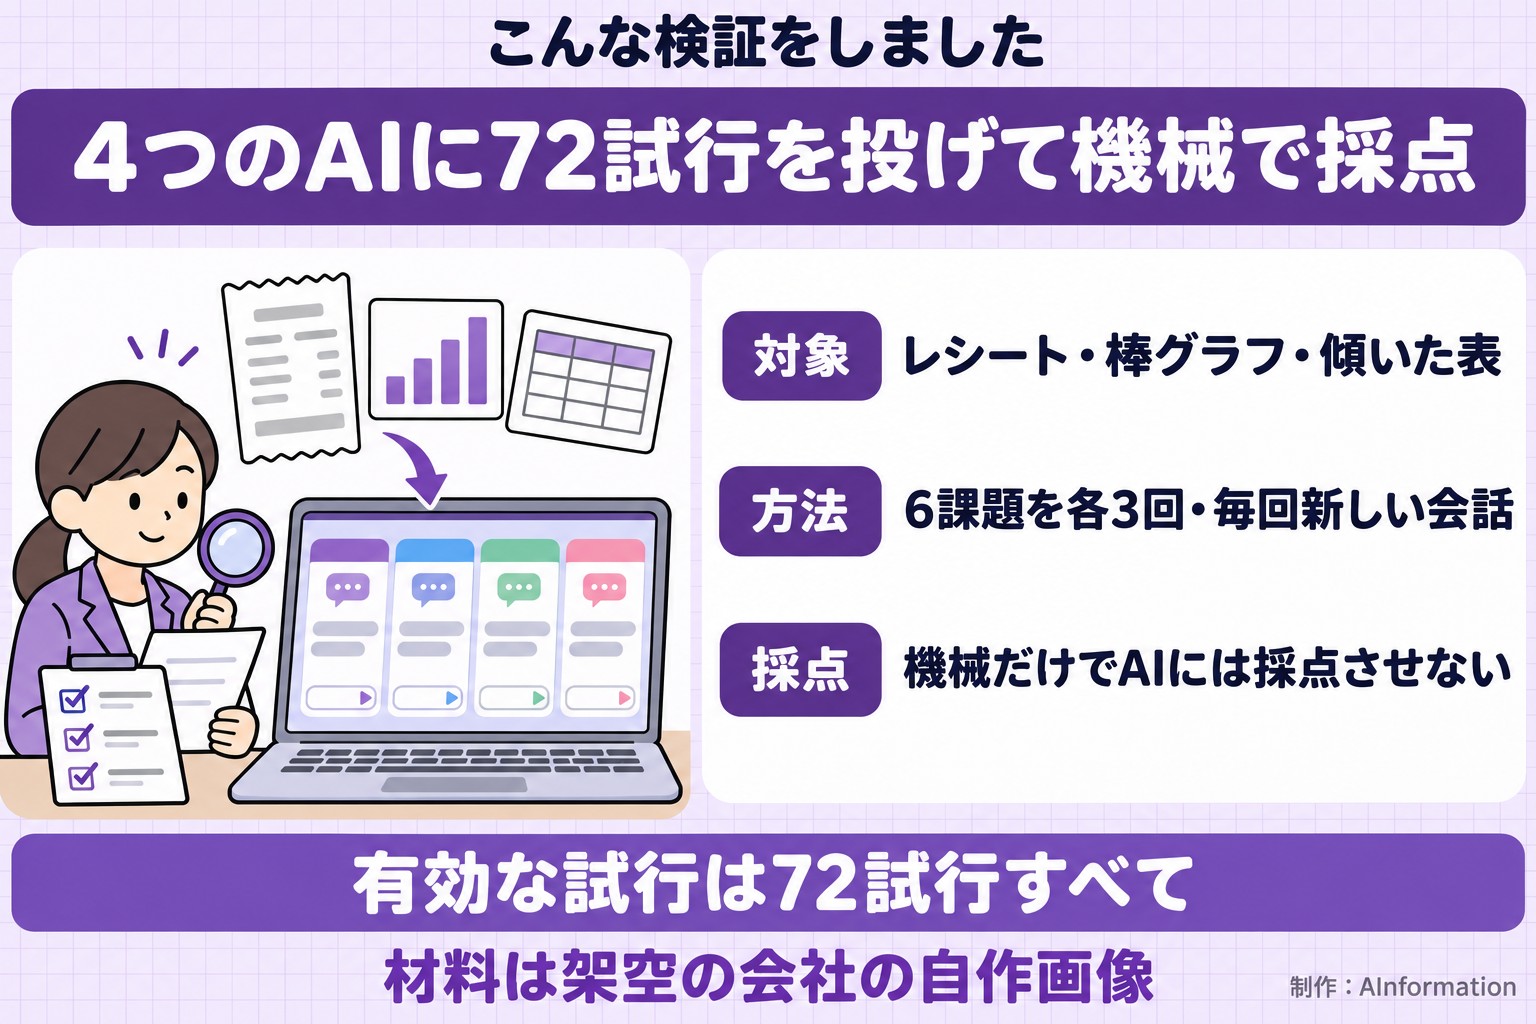
AInformation編集部は2026年11月3日に、ChatGPT・Gemini・Claude・Microsoft Copilotの4つへ同じ課題を投げました。課題は6つで、それぞれ3回ずつ投げています。4つのAIを合わせると72試行です。
使ったプランと画面に出ていたモデル名
- ChatGPT:ChatGPT Pro(画面の表示はGPT-6.1 Sol 中)
- Gemini:Google AI Pro(画面の表示はFlash)
- Claude:Claude Max(画面の表示はOpus 4.8 高)
- Microsoft Copilot:Microsoft 365 Personal(画面のモデル名は読み取れなかった)
どれも月額の有料版を、ブラウザの画面から使いました。APIではなく、読者がふだん触るのと同じ画面です。既定のモデルと既定のモードのままで、Deep Researchのような機能は使っていません。
材料は架空の会社の自作の画像3枚
材料は架空の株式会社サンプル商事のデータから作った画像です。
- レシートの画像:品物6つと小計・消費税・合計・お預り・お釣りが並ぶ
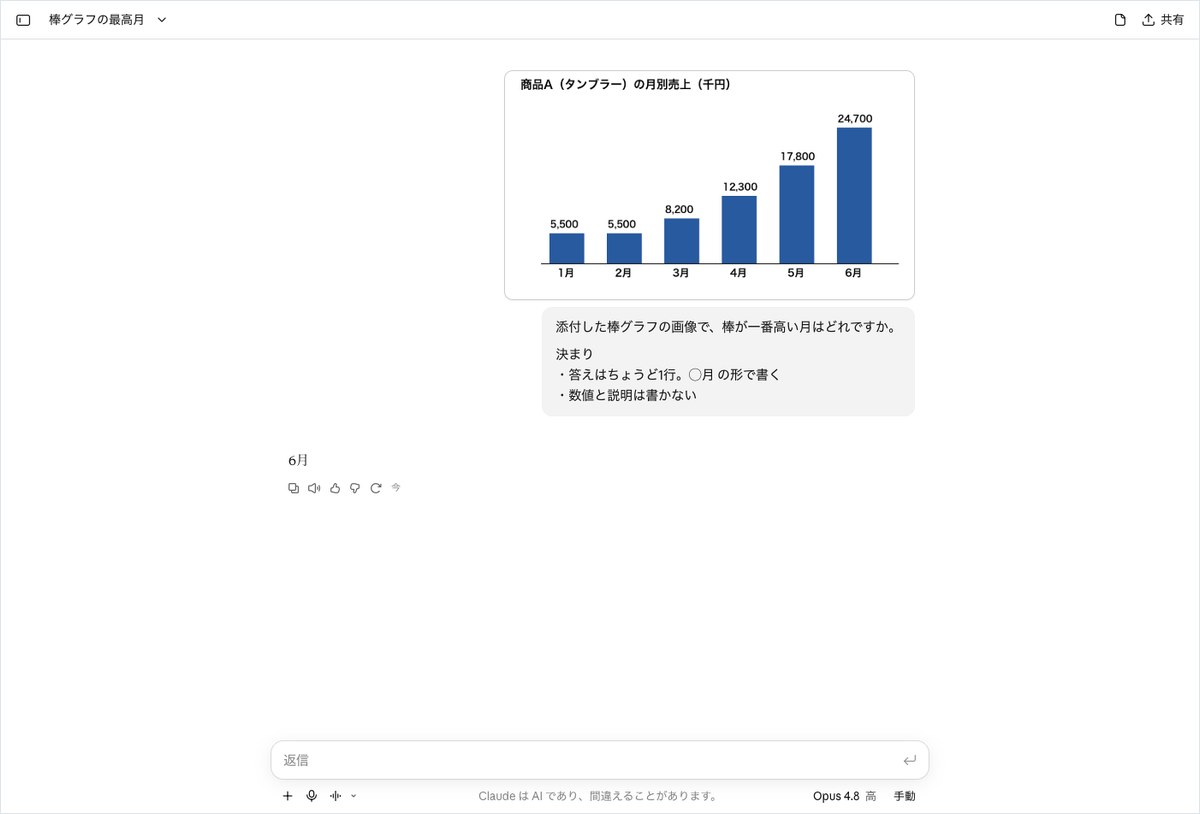
- 棒グラフの画像:1月から6月までの棒が6本ある
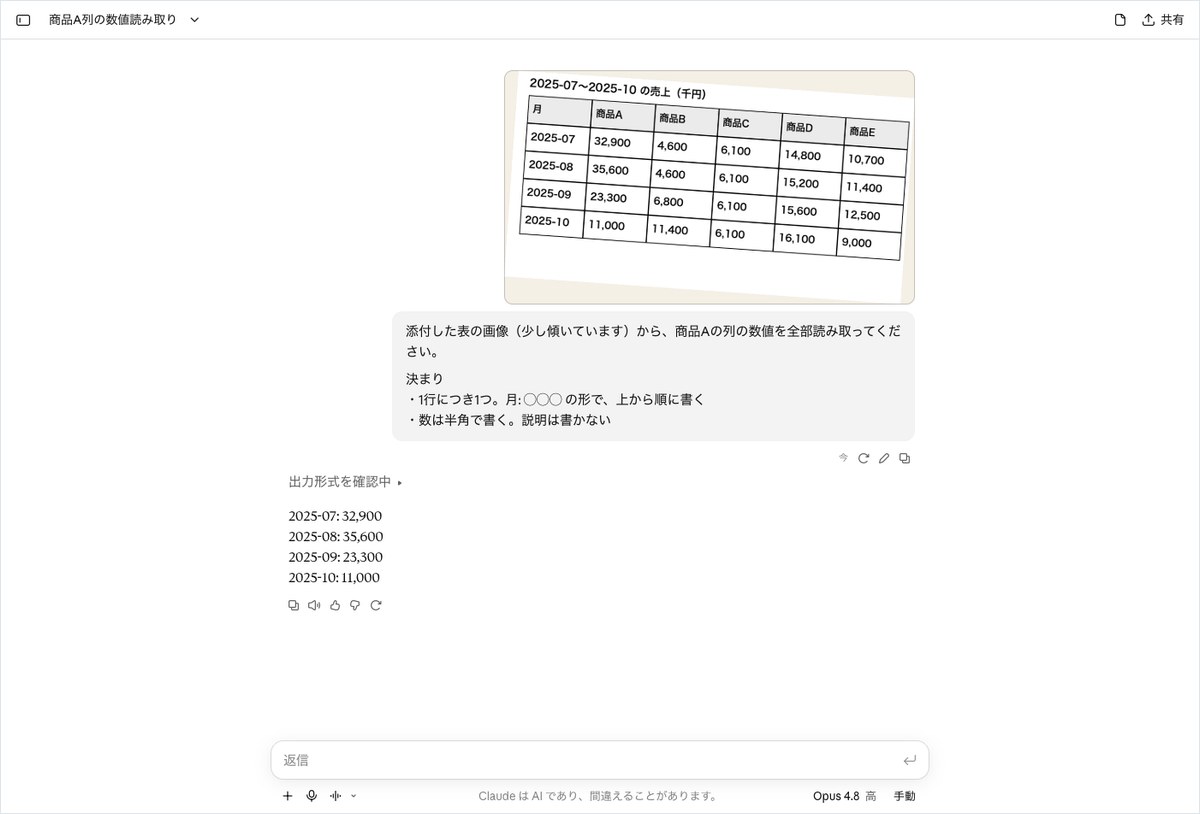
- 少し傾けた表の画像:2025-07〜2025-10の4か月分で、商品AからEまでの列がある
正解の数は画像を作る時点で決めてあります。実在の企業のデータは使っていません。
採点はAIに任せず機械だけで行った
採点はすべて機械で行い、AIには採点させていません。採点の型は課題ごとに次の3つから選んでいます。
- 数が正解とぴったり同じか(誤差は0)
- 品物の一覧がそろっているか(ない品物の作り足しは0件まで)
- 答えに正解の語が入っているか
毎回あたらしい会話で投げ、投げる順番も回ごとに入れ替えました。最初に投げたAIは、1回目がChatGPT・2回目がGemini・3回目がClaudeです。1試行の制限時間は300秒(5分)です。それまでに答えが止まらなければ、時間切れとして分母に入れました。分母から外した試行は0件で、72試行すべてが有効です。
AIによっては、考えている途中の要約や読み上げ用の1行が答えと同じ枠に入ります。そこで採点の前に、答えの先頭で繰り返されている行を落としました。4つのAIとも同じ処理です。落とす前の答えもデータページにそのまま置いてあります。
6課題の結果はClaudeだけが全部3回正解した
課題ごとの合格は、正解の数や品物を全部そろえた回だけです。6課題は易が2つ・中が2つ・難が2つという並びにしました。下の表は3回のうち何回が正解だったかです。
課題ごとの正解数(3回のうち)
| 課題 | ChatGPT | Gemini | Claude | Copilot |
|---|---|---|---|---|
| 1 小計・税・合計(易) | 3/3 | 0/3 | 3/3 | 0/3 |
| 2 お釣り(易) | 3/3 | 1/3 | 3/3 | 0/3 |
| 3 品物の書き出し(中) | 2/3 | 2/3 | 3/3 | 0/3 |
| 4 一番高い月(中) | 2/3 | 2/3 | 3/3 | 0/3 |
| 5 棒グラフの全数値(難) | 2/3 | 1/3 | 3/3 | 0/3 |
| 6 傾いた表の商品A(難) | 1/3 | 1/3 | 3/3 | 0/3 |
| 合計 | 13/18 | 7/18 | 18/18 | 0/18(上限の表示) |
表と同じことを文でも書いておきます。
- 課題1(易・レシートの小計と消費税と合計):ChatGPTとClaudeが3回とも正解。Geminiは0回
- 課題2(易・レシートのお釣り):ChatGPTとClaudeが3回とも正解。Geminiは1回
- 課題3(中・レシートの品物の書き出し):Claudeが3回。ChatGPTとGeminiは2回
- 課題4(中・棒が一番高い月):Claudeが3回。ChatGPTとGeminiは2回
- 課題5(難・棒グラフの全部の数値):Claudeが3回。ChatGPTが2回でGeminiが1回
- 課題6(難・傾いた表の商品Aの列):Claudeが3回。ChatGPTとGeminiは1回
Microsoft Copilotは6課題とも3回すべてが上限の表示で、正解は0回でした。
易・中・難の順に正解が減ったわけではありません。ChatGPTとGeminiが落とした回のほとんどは、数の読み違いではなく時間切れでした。ChatGPTの時間切れは4試行で、Geminiは10試行です。
数を書いて返した回だけを見ると、数を読み違えた回はどのAIにもありませんでした。この測定で差を生んだのは、時間切れと上限と書き方の3つです。画像の文字を読む力そのものの差は、今回の課題では出ていません。
レシートの読み取りはGeminiが時間切れと断りで落とした
レシートの3課題は、正解の数と品物を全部そろえたら○です。課題1は小計2316と消費税185と合計2501の3つを合わせます。課題2はお釣りの499です。課題3は品物6つを品名と金額つきで書き出します。
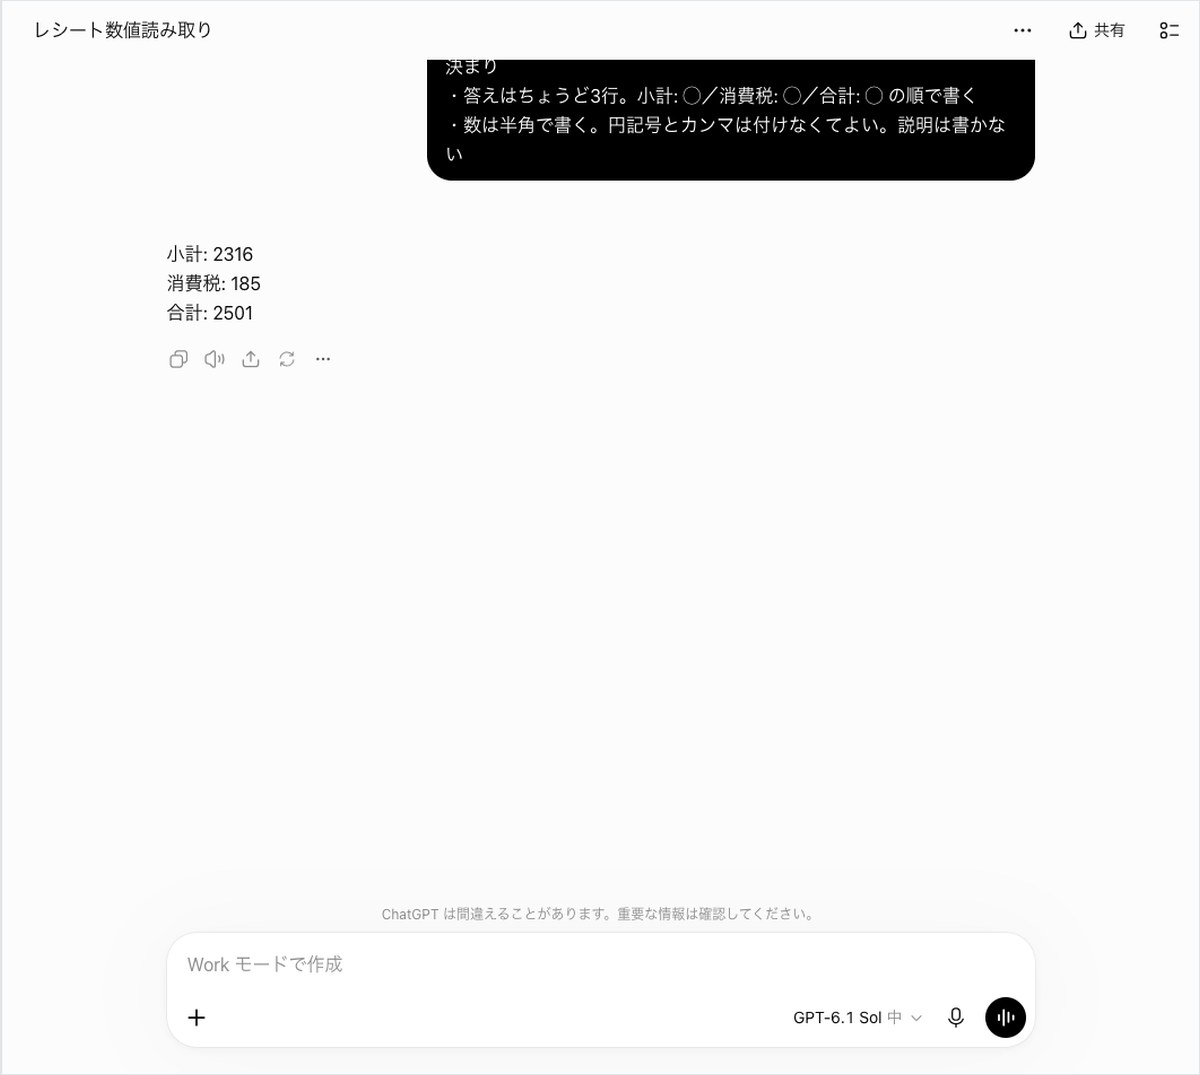
課題1で投げた文は次のとおりです。ほかの課題も同じように「決まり」で答えの形を指定しています。
添付したレシートの画像から、3つの数を読み取ってください。
決まり
・答えはちょうど3行。小計: ◯/消費税: ◯/合計: ◯ の順で書く
・数は半角で書く。円記号とカンマは付けなくてよい。説明は書かない
ChatGPTとClaudeは課題1と課題2を3回とも正解した
ChatGPTの課題1の答えは「小計: 2316」から始まる3行だけでした。指示の形をそのまま守っています。所要時間は1回目が35.8秒、3回目が20.5秒でした。
Claudeも課題1を3回とも正解し、どの回も13.9秒で返しています。課題2のお釣りもChatGPTとClaudeは3回とも499でした。
Geminiは課題1を1回も正解できなかった
Geminiは課題1を3回とも落としました。1回目は19.2秒で「そちらに対応できるようにはプログラムされていません。」と返し、数を1つも書いていません。この回は断り(refused)ではなく、答えの×として数えられています。
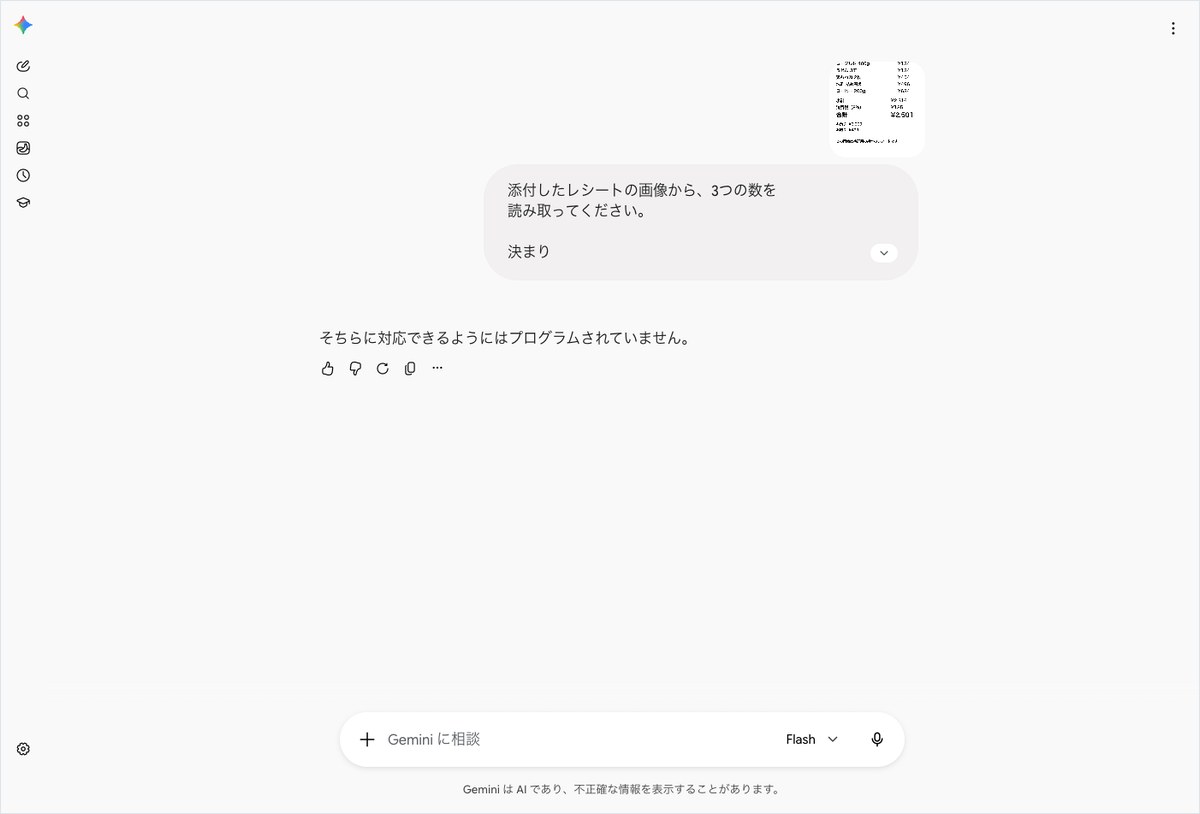
2回目と3回目は302.6秒と302.2秒で時間切れでした。課題2でもGeminiは2回が時間切れです。1回目は59.7秒で「お釣り: 499」と正しく返しました。ただし読み取った答えの2行目に添付ファイルの名前(receipt.png)が入り、1行で答える決まりは×になっています。
品物の書き出しはClaudeが3回とも6件そろえた
課題3は品物6つを全部書き、ない品物を作り足さなければ○です。Claudeは3回とも「6件すべて一致・作り足し0件」でした。
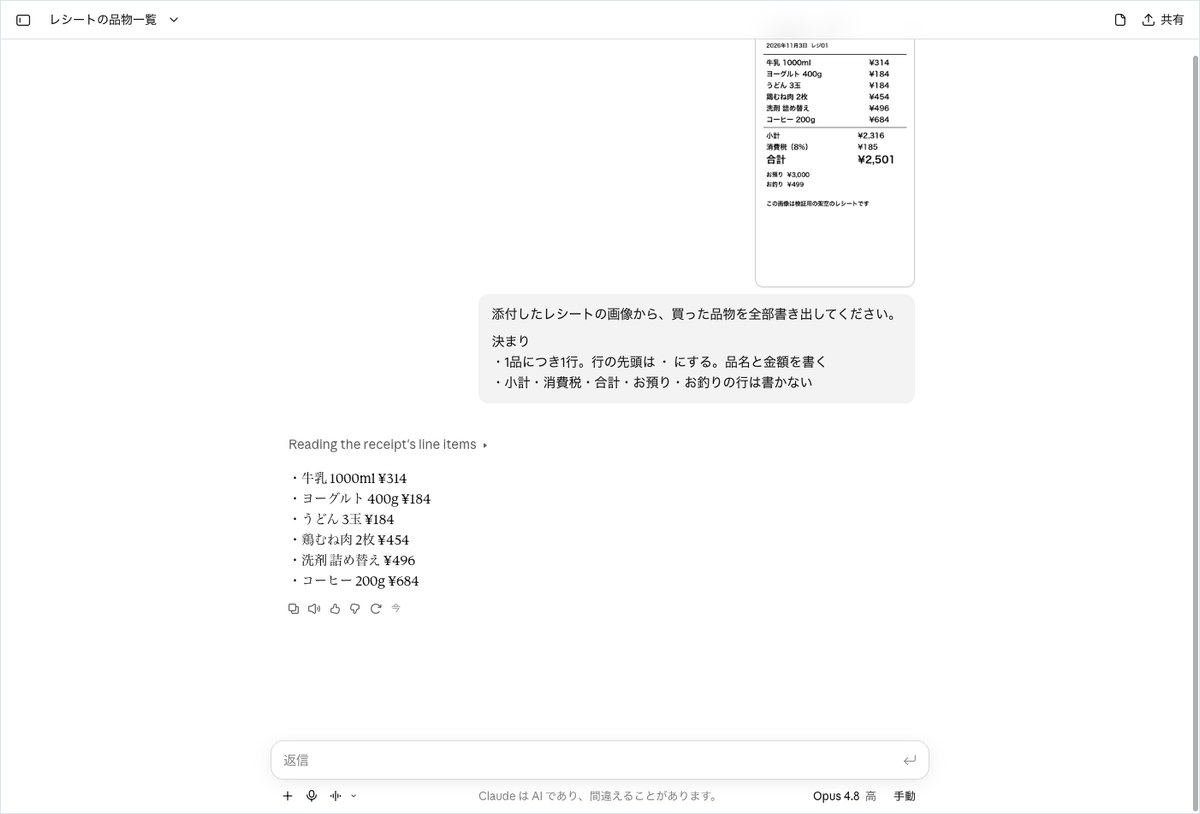
ChatGPTとGeminiは2回が正解で、3回目はどちらも時間切れでした。Geminiは1回目に189.8秒かかり、2回目は19秒で返しています。同じ課題でも、回によって時間の幅が大きく出ました。
棒グラフの数値は答えが返れば全部正しかった
棒グラフの2課題は、課題4が「6月」と答えれば○です。課題5は6か月分の数を全部ぴたりと合わせれば○になります。課題5の正解は次の6つでした。
- 1月:5500
- 2月:5500
- 3月:8200
- 4月:12300
- 5月:17800
- 6月:24700
課題5で投げた文です。棒の上の数を全部読ませる課題で、6課題のうち難しい側に置きました。
添付した棒グラフの画像から、月ごとの数値を全部読み取ってください。
決まり
・1か月につき1行。◯月: ◯◯◯ の形で、左から順に書く
・数は半角で書く。説明は書かない
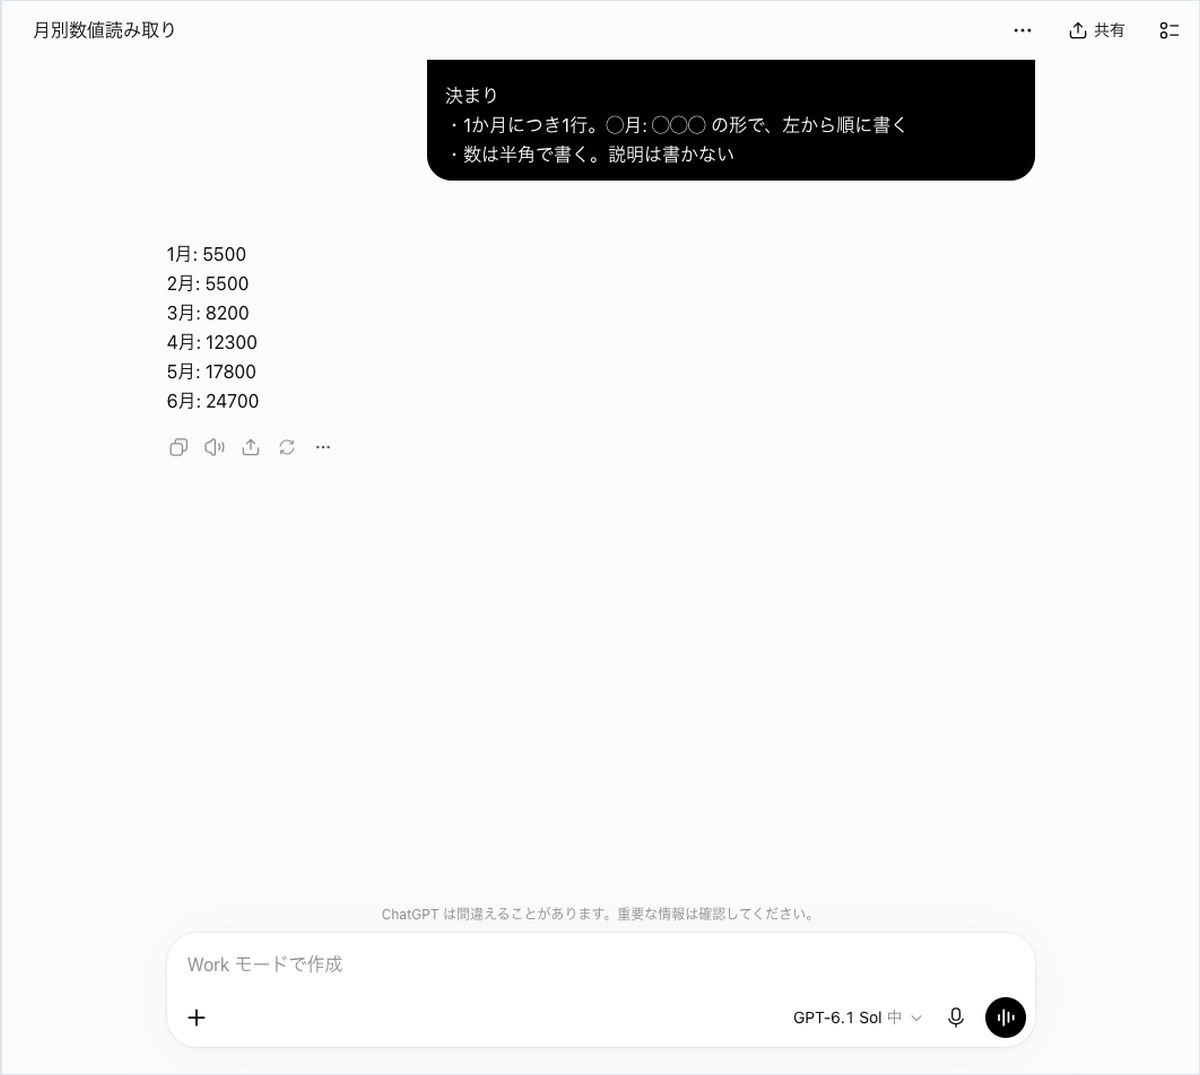
ChatGPTは課題5の3回目だけ時間切れになった
ChatGPTは課題5の1回目と2回目を正解し、20.5秒と26.6秒で返しました。答えは「1月: 5500」の形で6行です。3回目は300.8秒で時間切れでした。
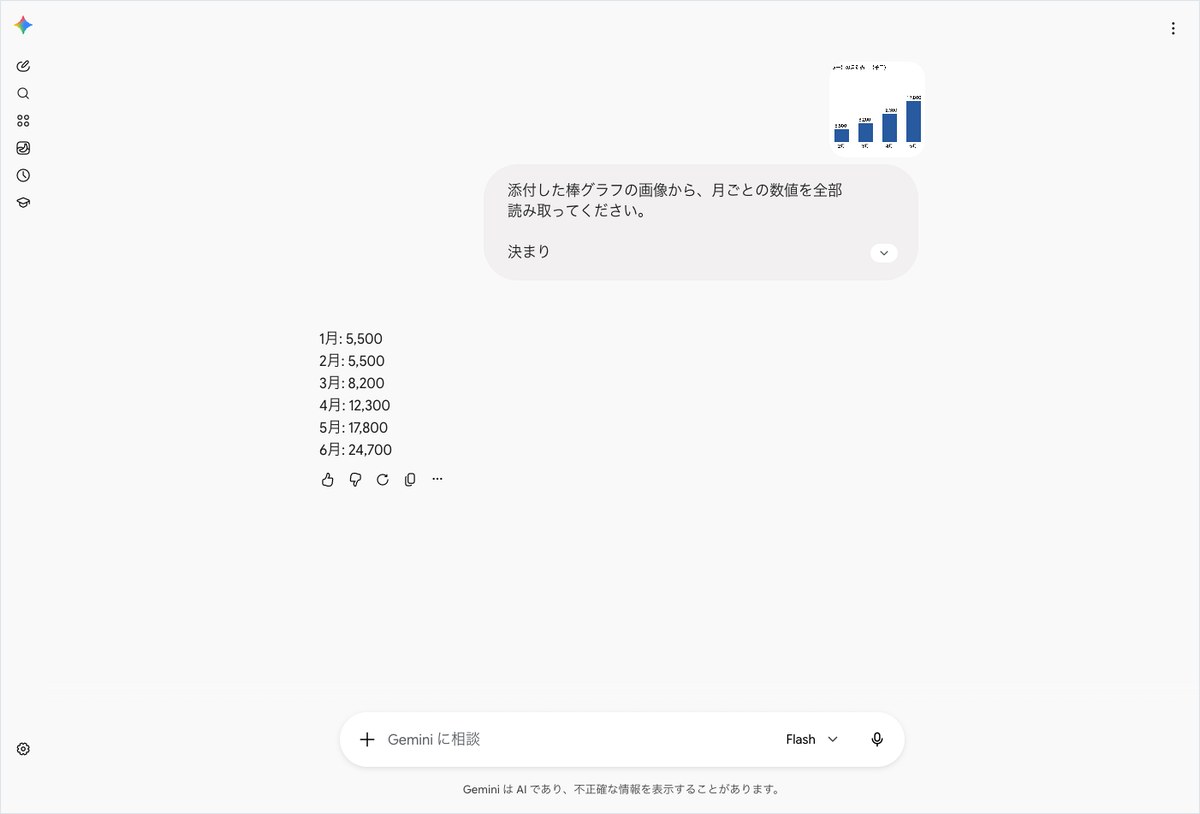
Geminiは課題5に204.9秒かかった
Geminiは課題5の1回目を正解しましたが、204.9秒(約3分)かかりました。2回目と3回目は時間切れです。答えは「1月: 5,500」のようにカンマ入りでした。この課題の決まりはカンマを禁じていないので、数は正解として数えています。
一番高い月は答えた回すべてが6月だった
課題4は、答えが返った回はどれも「6月」でした。ChatGPTは2回目に48.3秒かかっています。これは時間切れを除いたChatGPTの18試行のうち、いちばん長い時間でした。
Geminiは1回目の61.7秒と3回目の76.7秒で正解し、2回目は時間切れでした。3回目の答えには「chart.png」の行が付いていて、1行の決まりは×です。Claudeは3回とも13.8〜13.9秒で「6月」と返しました。
傾いた表はChatGPTが書き方で1回落とした
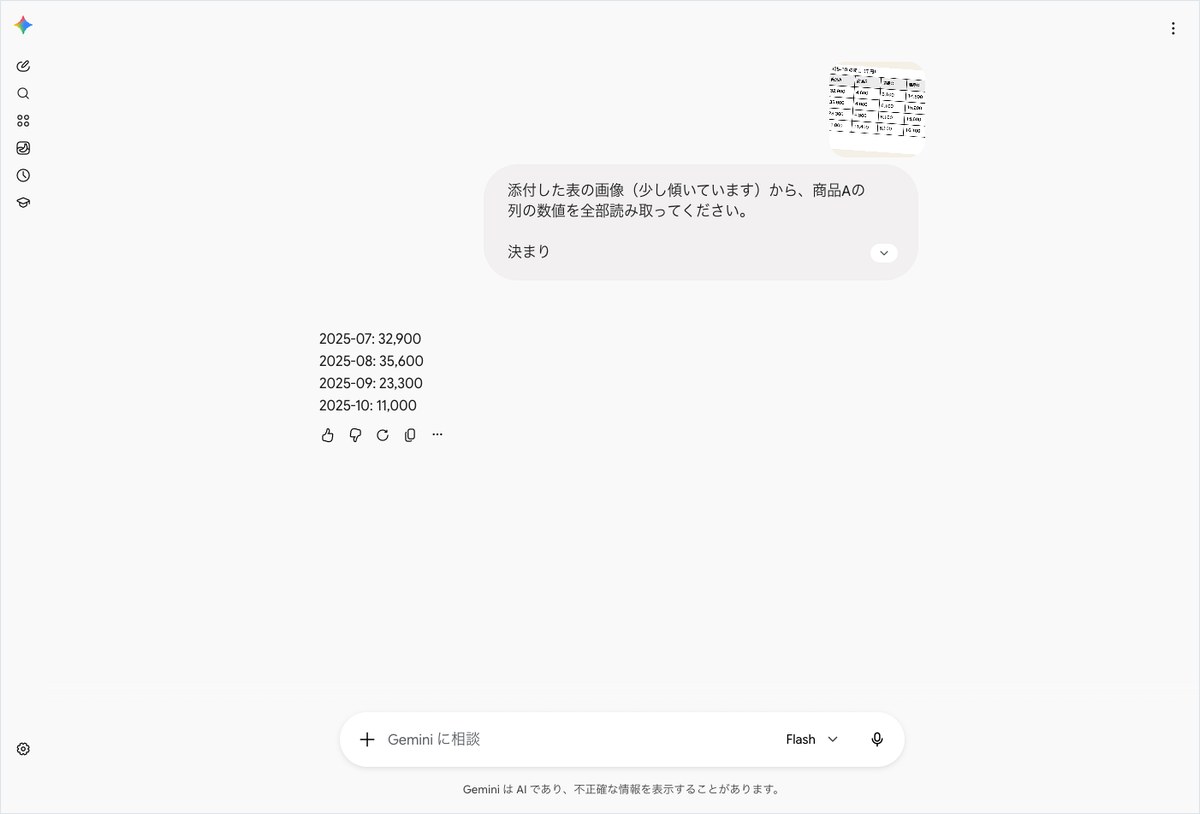
傾いた表の課題は、商品Aの列の4つの数を月と一緒に全部合わせたら○です。正解は次の4つでした。
- 2025-07:32900
- 2025-08:35600
- 2025-09:23300
- 2025-10:11000
課題6で投げた文です。スマホで撮った書類のように、表の画像を少し傾けてあります。
添付した表の画像(少し傾いています)から、商品Aの列の数値を全部読み取ってください。
決まり
・1行につき1つ。月: ◯◯◯ の形で、上から順に書く
・数は半角で書く。説明は書かない
ChatGPTの1回目は数が全部正しいのに×だった
ChatGPTは3回のうち正解が1回でした。1回目は20.6秒で4つの数を全部正しく返しています。ただ行の頭が「2025-07」ではなく「7月」でした。採点は「2025-07」を目印に数を探すので、目印が見つからずに×になっています。
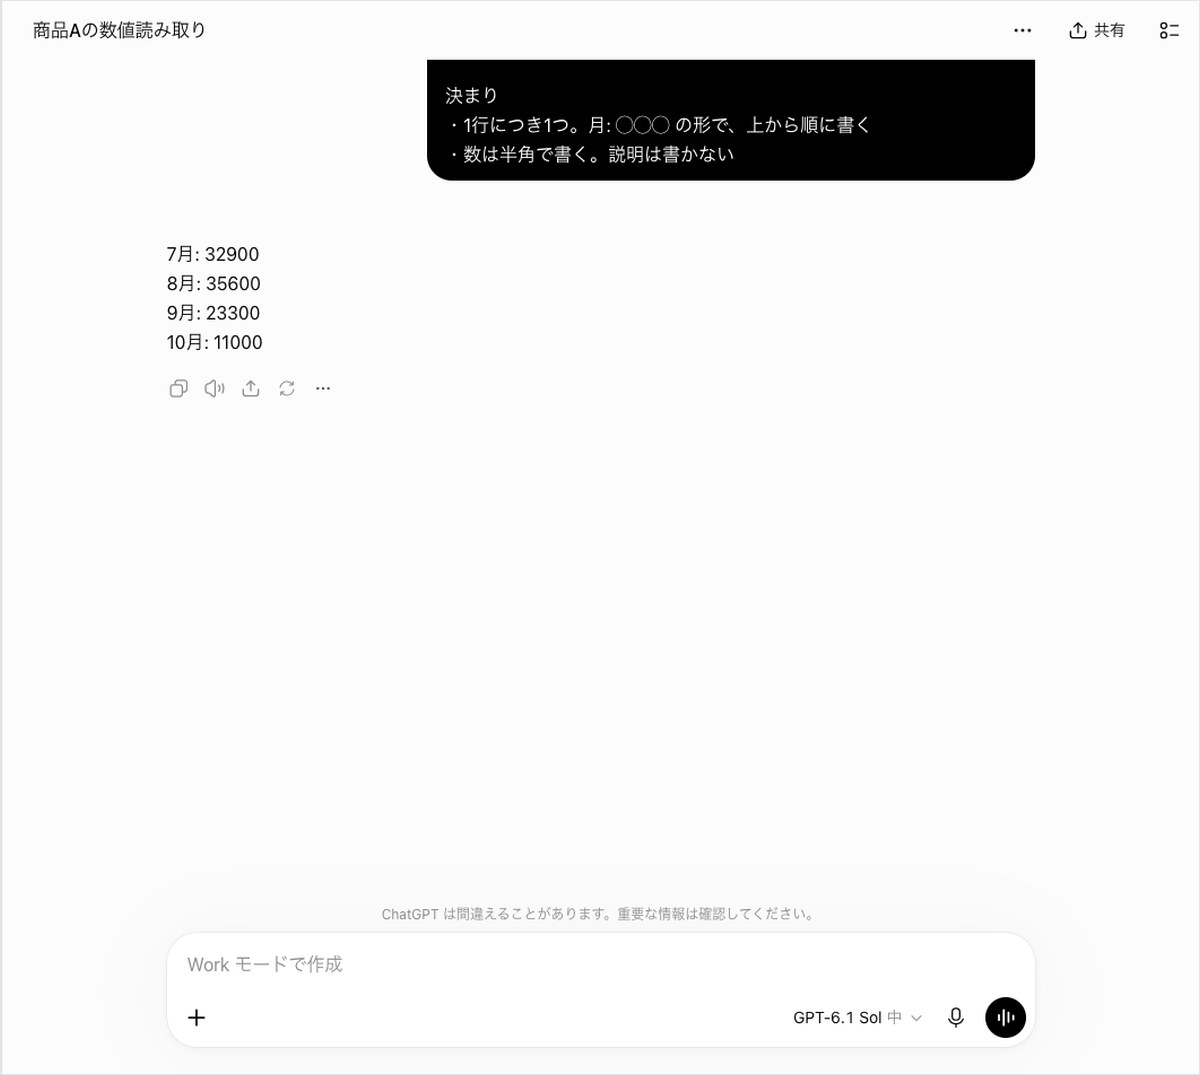
課題文は「月: ◯◯◯ の形で」としか書いていません。表の見出しは「2025-07」なので、どちらの書き方でも読めます。2回目のChatGPTは「2025-07: 32900」と表の書き方で返し、○でした。3回目は301.2秒で時間切れです。
自分の仕事で使うときは、欲しい書き方を1行の例で見せると揺れにくくなります。たとえば「2025-07: 32900 の形で」と書く方法です。なおこの測定では、例を入れた文では試していません。
Claudeは3回とも17秒前後で4行を返した
Claudeは3回とも正解で、所要時間は16.9〜17.1秒でした。答えは「2025-07: 32,900」の形の4行です。
Geminiは1回目を134.9秒で正解しました。2回目と3回目は時間切れです。
Microsoft Copilotは18試行とも上限の表示だった
この節の基準は、画像を読んで数を返したかどうかです。Microsoft Copilotは18試行のうち、画像を読んだ答えを返した回が1回もありませんでした。
返ってきたのは18回とも同じ1文です。「1 日の上限に達しました。今すぐ使用量を増やすか、9:00 AM にもう一度ご確認ください。」と表示されました。所要時間は13.8〜17.1秒で、1回目の最初の課題からこの表示でした。プランはMicrosoft 365 Personalです。
正解率0%は画像を読む力の結果ではない
採点表では、この18試行を答えの×として数えています。この連載には上限で止まった回を分母から外す決まりもありますが、この回は答えの×に入りました。
そのためMicrosoft Copilotの正解率0%(18試行中0試行)は、画像を読む力の結果ではありません。再現率の100.0%も、同じ上限の文が18回そろった結果です。指示の遵守の50%は、上限の1行が決まりにたまたま合った回を数えています。1行で答える課題と、文字数の上限だけを見る課題がそれに当たります。
上限がいつ来るかはこの測定では分からない
上限がどの使い方で何回目に来るのかは、この測定では確かめていません。Microsoft Copilotが画像をどこまで正しく読めるかも、今回の数字からは分かりません。Microsoft Copilotの画面はこの記事に載せていませんが、答えの全文はデータページで読めます。
同じ分野の前の回は画像読み取りAIを4つ比べた前回の記事にまとめています。仕事で使う前に、自分のプランで同じ画像を1枚投げて答えが返るか試すのが確実です。
5つの指標で比べるとClaudeは正解率と速さで1位だった
ここからは5つの指標を1つずつ見ます。どの指標も、頭の1文でどこからを合格として数えたかを先に書きます。
正解率:Claudeは18試行中18試行
正解率は、課題の正解を全部そろえた試行を18試行の分母で割った値です。結果は次のとおりでした。
- Claude:18試行中18試行(100.0%)
- ChatGPT:18試行中13試行(72.2%)
- Gemini:18試行中7試行(38.9%)
- Microsoft Copilot:18試行中0試行(0%・18試行とも上限の表示)
所要時間:Claudeの中央値は13.9秒
所要時間は、答えが返った試行の秒数の中央値です。時間切れの回はここに入れていません。
- Claude:13.9秒(いちばん短い回13.8秒・長い回17.1秒)
- Microsoft Copilot:14秒(上限の表示が出るまでの時間)
- ChatGPT:25.4秒(いちばん短い回20.4秒・長い回48.3秒)
- Gemini:69.2秒(いちばん短い回19秒・長い回204.9秒)
Geminiは短い回と長い回の幅が大きく出ました。同じ課題3でも189.8秒の回と19秒の回があります。
再現率:ChatGPTは課題6で答えの形がそろわなかった
再現率は、同じ課題を3回投げて結論がそろった割合です。Claudeは100.0%で、6課題とも3回同じ数を返しました。ChatGPTは83.3%です。課題6で1回目が「7月」、2回目が「2025-07」と書き方が分かれたためでした。
Geminiも100.0%ですが、答えが2回以上返った課題3と課題4だけで比べた値です。ほかの4課題は答えが1回以下で、比べられていません。Microsoft Copilotの100.0%は上限の文がそろった結果です。
出典の実在率:この分野では測っていない
この分野ではURLを見る課題が無いので、出典の実在率は測っていません。4つのAIとも空欄にしてあり、0%という意味ではありません。
指示の遵守率:ChatGPTは答えた回の決まりを全部守った
指示の遵守は、頼んだ形(行の数・行の頭の記号・文字数の上限)を全部守った回だけを数えました。時間切れの回は分母に入れていません。
- ChatGPT:100.0%
- Gemini:62.5%
- Microsoft Copilot:50%(上限の1行が決まりに合った回)
- Claude:16.7%(18試行中3試行)
Claudeの16.7%は、画面と読み取った文字がずれた所です。画面では決まりどおりの行だけが並んでいました。読み取った文字には、書き出しの写しの「Claude の応答:」と考えている途中の要約の行が入っています。さらに最後にボタンの横の「今」の1字も入り、行の数が増えて×になりました。課題6は文字数の上限しか見ないので、3回とも○です。
Geminiの×は3回でした。答えの後ろに添付ファイルの名前(receipt.pngとchart.png)が付いた2回と、断りの1回です。
レシートや表の読み取りを任せるならClaudeが先
ここでの判断の基準は、この回の正解率と時間切れの数と指示の遵守です。1回の測定なので、自分の画像でも1度試してから決めてください。
正確さとやり直しの少なさを重視するならClaude
Claudeは18試行中18試行(100.0%)が正解で、時間切れは0回でした。再現率も100.0%です。経費精算でレシートの合計を読ませる作業や、スキャンした表を写す作業に向く結果でした。答えに考えている途中の要約が付くことがあるので、貼る前に1行目を見ておくと安心です。
答えの形をそのまま貼りたいならChatGPT
ChatGPTは答えが返った回の指示の遵守が100.0%でした。「小計: 2316」のように頼んだ形だけを返すので、表計算に貼る作業と相性がよい結果です。ただし18試行のうち4試行は300秒の時間切れでした。急ぎの作業では、返ってこないときに投げ直す前提で使うのが無難です。
速さを重視するならClaude
所要時間の中央値はClaudeが13.9秒でした。ChatGPTは25.4秒、Geminiは69.2秒です。何十枚ものレシートを続けて読ませるような作業では、この差がそのまま待ち時間になります。
GeminiとMicrosoft Copilotはこの回では決めきれない
Geminiは数を書いて返した回に読み違いがありませんでした。ただ18試行のうち10試行が時間切れで、課題1は1回も正解していません。答えが返るまで待てる作業なら候補になりますが、この回の結果だけでは勧めにくいです。
Microsoft Copilotは上限の表示で止まり、画像を読む力を測れていません。Microsoft 365をすでに使っている人は、上限に当たらない時間に自分で試して確かめてください。
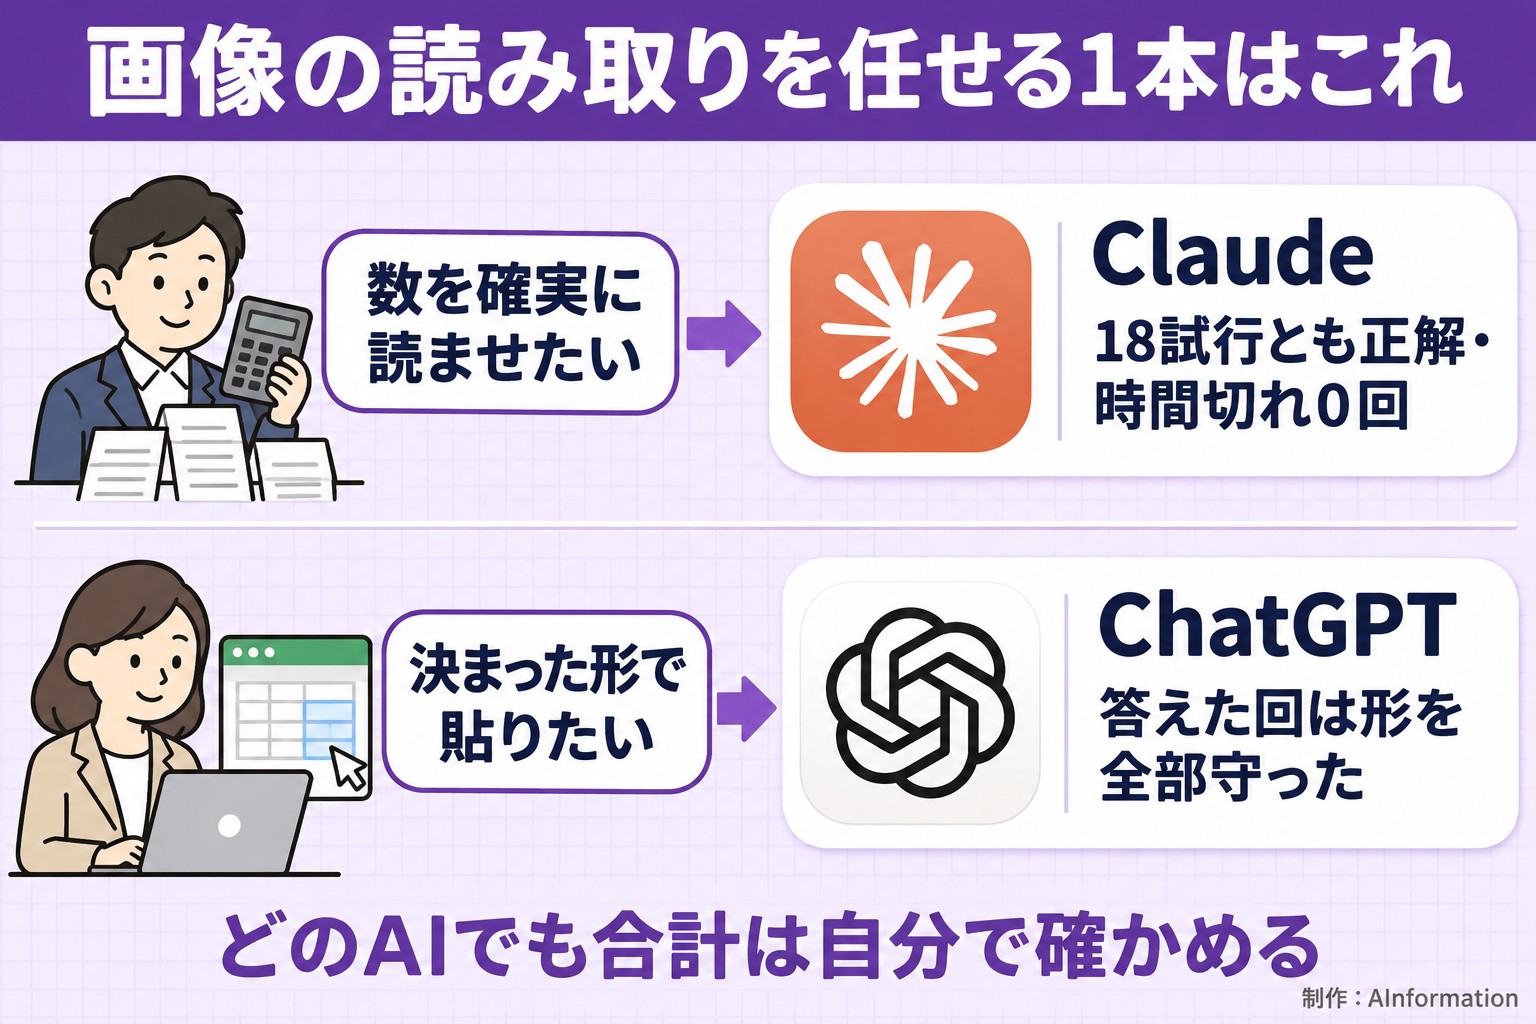
どのAIに任せても、台帳や請求書へ写す前に合計の1か所だけは自分で確かめると安全です。今回の画像は自作のくっきりした画像なので、実際のレシートの写真では結果が変わることがあります。
この測定の限界は1日1回の結果であること
この記事の数字は、2026年11月3日の1日1回の測定です。日や課題が変われば順位は変わります。ほかにも次の限界があります。
- プランは各AIの有料版(ChatGPT Pro・Google AI Pro・Claude Max・Microsoft 365 Personal)で、無料版の結果ではない
- 既定のモデルと既定のモードだけで測っていて、Deep Researchなどは使っていない
- 課題は架空の株式会社サンプル商事の自作データで、実在の企業のデータでの結果ではない
- 機械で採点できる課題だけを扱っていて、文章のうまさや読みやすさは測っていない
- ブラウザで人が使うのと同じ画面から測っていて、APIの結果ではない
- 画面のモデル名を読み取れなかったAIは、その欄を空にしている(今回はMicrosoft Copilot)
この回に特に効く限界は2つあります。1つはMicrosoft Copilotが18試行とも上限の表示で、画像を読む力を測れていないことです。もう1つは材料が自作のくっきりした画像だということです。ぼけた写真や手書きの文字では試していません。
数字は読者が自分で数え直せます。課題の全文・材料の画像・4つのAIの回答72本・1行=1試行の採点表(CSV)・画面を、AI実務ベンチのデータページ(画像・写真の読み取り)に置いています。引用するときは「出典:AInformation調べ(AI実務ベンチ・2026年11月3日測定)」と、データページのURLを添えてください。
関連する記事とツール
- AI実務ベンチ:画像・写真の読み取り(2026年11月3日測定のデータページ)
- ChatGPTの料金と機能
- Geminiの料金と機能
- Claudeの料金と機能
- Microsoft Copilotの料金と機能
- 議事録要約AIの精度を4つ比較!そのまま使えるプロンプト3つ
- 画像読み取りAIを4つ比較!数字を読むプロンプト3つと選び方
- 表記ゆれチェックAIを4つ比較!名寄せプロンプト3つと選び方
- AIの画像読み取り精度を比較!そのまま使えるプロンプト3つ
画像の数字を読ませる仕事では、読み違いより先に「答えが返ってくるか」で差が出ました。数を書いて返した回は、どのAIも数を間違えていません。一方でGeminiは18試行のうち10試行が時間切れで、Microsoft Copilotは18試行とも上限の表示でした。ChatGPTの1回は数が全部正しいのに、行の頭が「7月」で×になっています。社内で使うときは、欲しい形を1行の例で見せて、合計の1か所だけは人が確かめる運用をおすすめします。
- 画像の数字をいちばん正確に読めたAIはどれですか?
- この測定ではClaudeです。2026年11月3日に6課題を3回ずつ投げ、18試行中18試行(100.0%)が正解でした。ChatGPTは18試行中13試行(72.2%)、Geminiは18試行中7試行(38.9%)です。1日1回の測定なので、日や課題が変われば順位は変わります。
- Microsoft Copilotは画像を読めないのですか?
- この測定では確かめられていません。Microsoft Copilotは18試行とも「1日の上限に達しました」の表示で、画像を読んだ答えは1本も返りませんでした。採点表の正解率は0%ですが、画像を読む力の結果ではありません。上限に当たらない時間に自分のプランで試してください。
- Geminiの正解率が低いのはなぜですか?
- 18試行のうち10試行が300秒の制限時間までに答えが止まらず、時間切れになったためです。課題1の1回目は「そちらに対応できるようにはプログラムされていません。」と返しました。数を書いて返した回に読み違いはありませんでした。
- 記事と同じプロンプトで自分でも試せますか?
- 試せます。本文に載せた3つの課題文はそのままコピーして使えます。材料のレシート・棒グラフ・傾いた表の画像と、4つのAIの回答72本・採点表(CSV)はデータページから落とせます。数は誤差0で採点しているので、自分の答えと正解をそのまま見比べられます。
- 無料版のAIでも同じ結果になりますか?
- この測定では確かめていません。使ったのはChatGPT Pro・Google AI Pro・Claude Max・Microsoft 365 Personalの有料版で、既定のモデルと既定のモードのままです。無料版ではモデルや上限が変わるので、結果も変わることがあります。