レシートや棒グラフの画像から数字を読めるかを、2026年10月24日に4つのAIへ6課題×3回で試しました。正解率はChatGPTが18試行中14試行(77.8%)で最も高くなりました。差がついたのは読み取りの中身より、待ち時間と答えの形です。
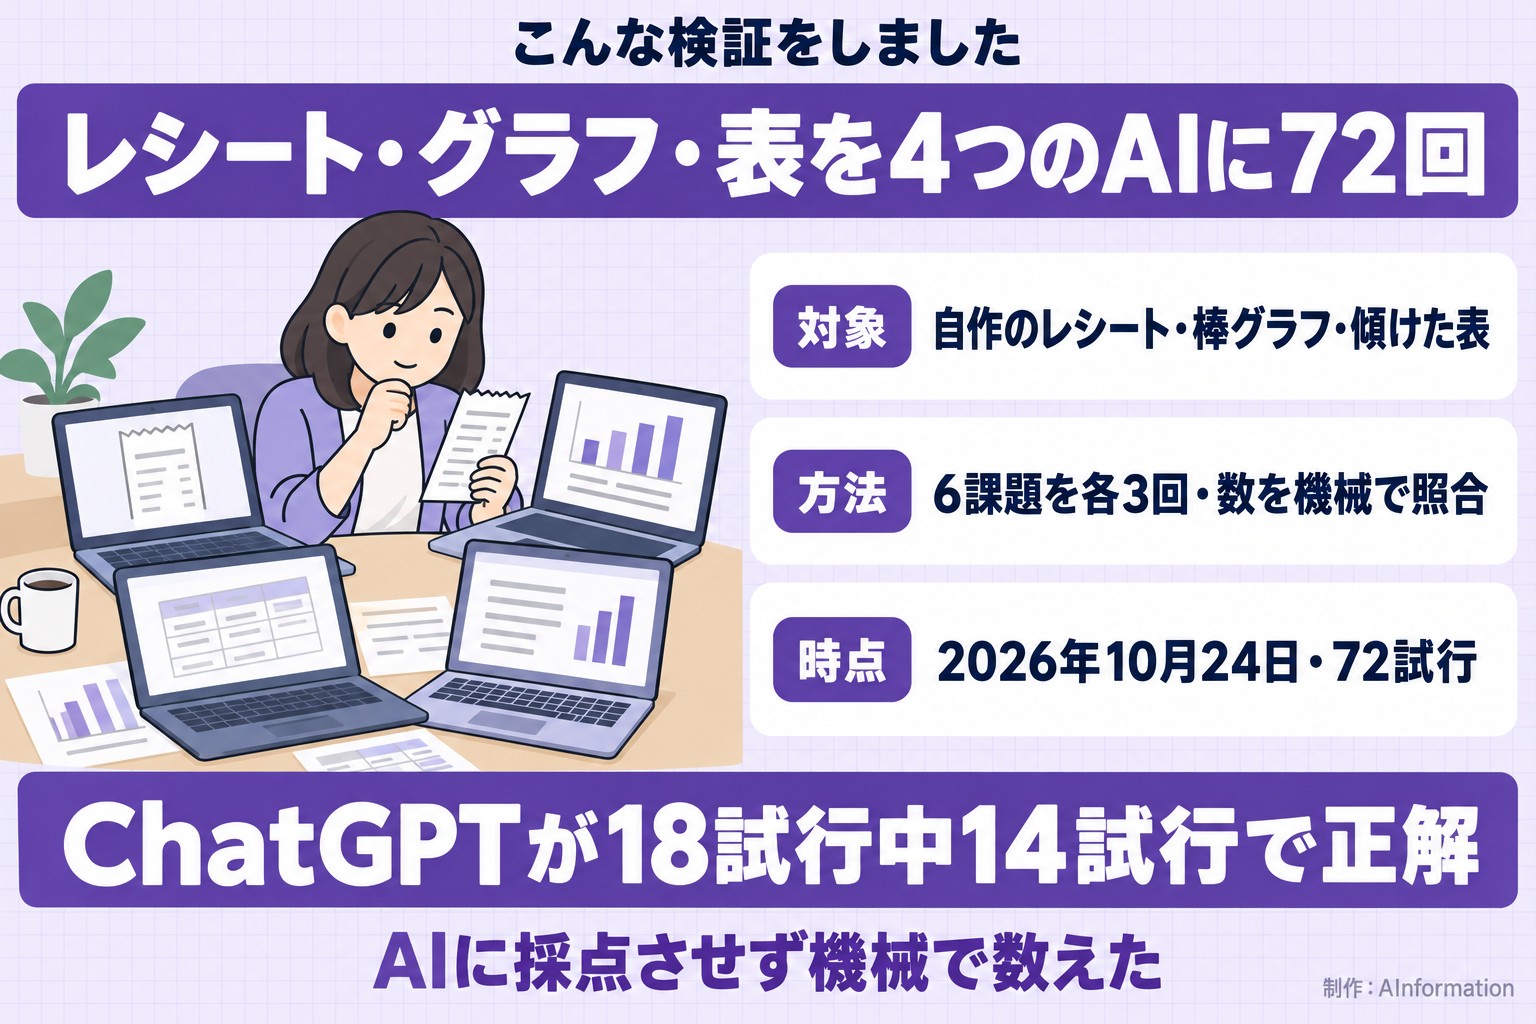
- 自作のレシート・棒グラフ・少し傾けた表の画像を2026年10月24日に4つのAIへ6課題×3回投げ、72試行を機械だけで採点した結果
- 正解率はChatGPTが18試行中14試行(77.8%)で最も高く、GeminiとMicrosoft Copilotは18試行中12試行(66.7%)で並んだ
- Claudeは18試行中10試行(55.6%)。ただし回答の全文では、答えが返った試行に数の読み違いは無かった
- 所要時間の中央値はClaudeの13.9秒が最も短く、Geminiは183.7秒(約3分)かかった
- 指示の遵守率はClaudeだけ18試行で16.7%となり、ほかの3つは100%だった
- 棒グラフ・表・レシートを読ませる課題文3つを、そのままコピーして試せる形で載せた
結論はChatGPTが18試行中14試行で最も正解した
レシートや表の画像を渡したとき、AIは数字を正しく読めるのか。AInformation編集部は2026年10月24日に、ChatGPT・Gemini・Claude・Microsoft Copilotの4つへ同じ6課題を3回ずつ投げました。
採点表の正解率はChatGPTが18試行中14試行(77.8%)で最も高くなりました。GeminiとMicrosoft Copilotは18試行中12試行(66.7%)で並んでいます。Claudeは18試行中10試行(55.6%)でした。
ただ画像から数字を読む力そのものでは、4つの差はほとんど出ていません。回答の全文を1本ずつ見ると、答えが返った試行で数を読み違えたものはありませんでした。×が分かれたのは次の3つです。
- 待ち時間:300秒の時間切れがGeminiで3試行、ChatGPTとMicrosoft Copilotで1試行ずつ出た
- 答えの形:Claudeは課題1で同じ数が2回読み取られ、課題3では月の書き方が指示とずれた
- 採点の型:レシートをJSONにする課題5は、4つとも数は合っていたのに採点表で×になった
5つの指標でいちばん開いたのは所要時間です。中央値はClaudeが13.9秒で、Microsoft Copilotは14.2秒でした。ChatGPTは36秒で、Geminiは183.7秒(約3分)かかっています。
画像の数字読みを1つ任せるなら、この回の結果では正解の数が多いChatGPTです。急いで数を1つ確かめたいだけなら、Microsoft Copilotが速くて形も守りました。
ただし1回の測定なので、日や課題が変われば順位は変わります。1回ごとの答えと採点の理由は、この回の採点表と回答の全文で数え直せます。
測り方はレシート・棒グラフ・傾いた表の3枚で6課題
この記事で扱うのは、画像の文字をそのまま写すOCRだけではありません。写っている数字を読み、決まった形で答えたり足し算したりする作業です。経費のレシートや会議資料のグラフを、AIに数字へ直してもらう場面を想定しました。
材料は架空の株式会社サンプル商事のために編集部が作った画像3枚です。実在の企業のデータは使っていません。
- レシート:サンプルマート本店の5品目。合計は1,440円で、小計は1,334円・消費税は106円
- 棒グラフ:商品A(タンブラー)の1月から6月の月別売上(千円)。一番高い棒は9,700
- 表:2025年7月から10月の5商品の売上(千円)を、少し傾けて撮った写真のような画像
正解は画像を作った時点で決めてあります。課題は易・中・難を2つずつ用意しました。
- 課題1(易):棒グラフで一番高い棒の数値を1行で答える
- 課題2(易):レシートの合計金額を「合計: ◯」の形で答える
- 課題3(中):傾いた表で月ごとに5商品を足した合計を出す
- 課題4(中):棒グラフの数値を全部足す
- 課題5(難):レシートを決まった形のJSONにする
- 課題6(難):傾いた表の数値を全部足す
毎回あたらしい会話を開いて順番も入れ替えた
1回ごとにあたらしい会話を開き、画像を1枚添えて課題の文を送りました。投げる順番は3回の繰り返しごとに入れ替えています。
- 1回目:ChatGPT→Gemini→Claude→Microsoft Copilot
- 2回目:Gemini→Claude→Microsoft Copilot→ChatGPT
- 3回目:Claude→Microsoft Copilot→ChatGPT→Gemini
測る前には4つとも1回だけ短いあいさつを送りました。開いた直後の1回目が返らないことがあるためです。この1回は採点にも所要時間にも入れていません。
答えを待つ上限は300秒です。300秒たっても答えが止まらなかった試行は、時間切れとして不正解に数えました。72試行のうち分母から外した試行はありません。
採点は数がぴったり合うかを機械で見た
採点は機械だけで行い、AIには採点させていません。6課題とも型は同じで、答えの中の数が正解とぴったり合えば○です。誤差は認めていません。
数を探すときは目印の語も見ています。課題2・課題4・課題6は「合計」で、課題3は「7月」のような月の名前です。課題5は「小計」「税」「合計」の語のそばの数を見ました。この目印の決め方が、あとで出てくる課題5の×につながります。
指示の遵守は、答えの行数と文字数とJSONの形を見ました。使ったプランは次の4つで、どれも有料版です。
- ChatGPT Pro(画面のモデル表示はGPT-6.1 Sol 軽)
- Google AI Pro(画面のモデル表示はFlash)
- Claude Max(画面のモデル表示はOpus 4.8 高)
- Microsoft 365 Personal(モデル名は画面から読み取れなかった)
易の2課題はClaudeだけ課題1が3回とも×だった
棒グラフの一番高い棒やレシートの合計のように、1つの数を読む課題で差は出たのか。数の読み取りでは4つとも正しく答えています。×になったのはClaudeの課題1の3回と、Microsoft Copilotの課題2の時間切れ1回でした。
6課題×各3回の結果(○正解・×不正解)
| 課題 | ChatGPT | Gemini | Claude | Microsoft Copilot |
|---|---|---|---|---|
| 課題1 棒グラフの最大値(易) | ○○○ | ○○○ | ××× | ○○○ |
| 課題2 レシートの合計(易) | ○○○ | ○○○ | ○○○ | ○○×(時間切れ) |
| 課題3 表の月別合計(中) | ○○○ | ○○×(時間切れ) | ×○× | ××○ |
| 課題4 グラフの合計(中) | ×○○(時間切れ) | ○×○(時間切れ) | ○○○ | ○○○ |
| 課題5 レシートのJSON(難) | ××× | ××× | ××× | ××× |
| 課題6 表の全合計(難) | ○○○ | ×○○(時間切れ) | ○○○ | ○○○ |
| 正解の数 | 18試行中14 | 18試行中12 | 18試行中10 | 18試行中12 |
課題ごとの○×は表のとおりです。同じことを課題ごとに並べます。
- 課題1(棒グラフの最大値):ChatGPT・Gemini・Microsoft Copilotは3回とも○。Claudeは3回とも×
- 課題2(レシートの合計):ChatGPT・Gemini・Claudeは3回とも○。Microsoft Copilotは3回目が時間切れ
- 課題3(表の月別合計):ChatGPTは3回とも○。Geminiは3回目が時間切れ。Claudeは2回目だけ○。Microsoft Copilotは3回目だけ○
- 課題4(グラフの合計):ClaudeとMicrosoft Copilotは3回とも○。ChatGPTは1回目が時間切れ。Geminiは2回目が時間切れ
- 課題5(レシートのJSON):4つとも3回とも×
- 課題6(表の全合計):ChatGPT・Claude・Microsoft Copilotは3回とも○。Geminiは1回目が時間切れ
課題1は同じ答えが2回読み取られて×になった
課題1で投げた文はこれです。棒グラフの画像を1枚添えています。
添付した棒グラフの画像で、一番高い棒の数値はいくつですか。
決まり
・答えはちょうど1行。数だけを半角で書く
・月名と説明は書かない
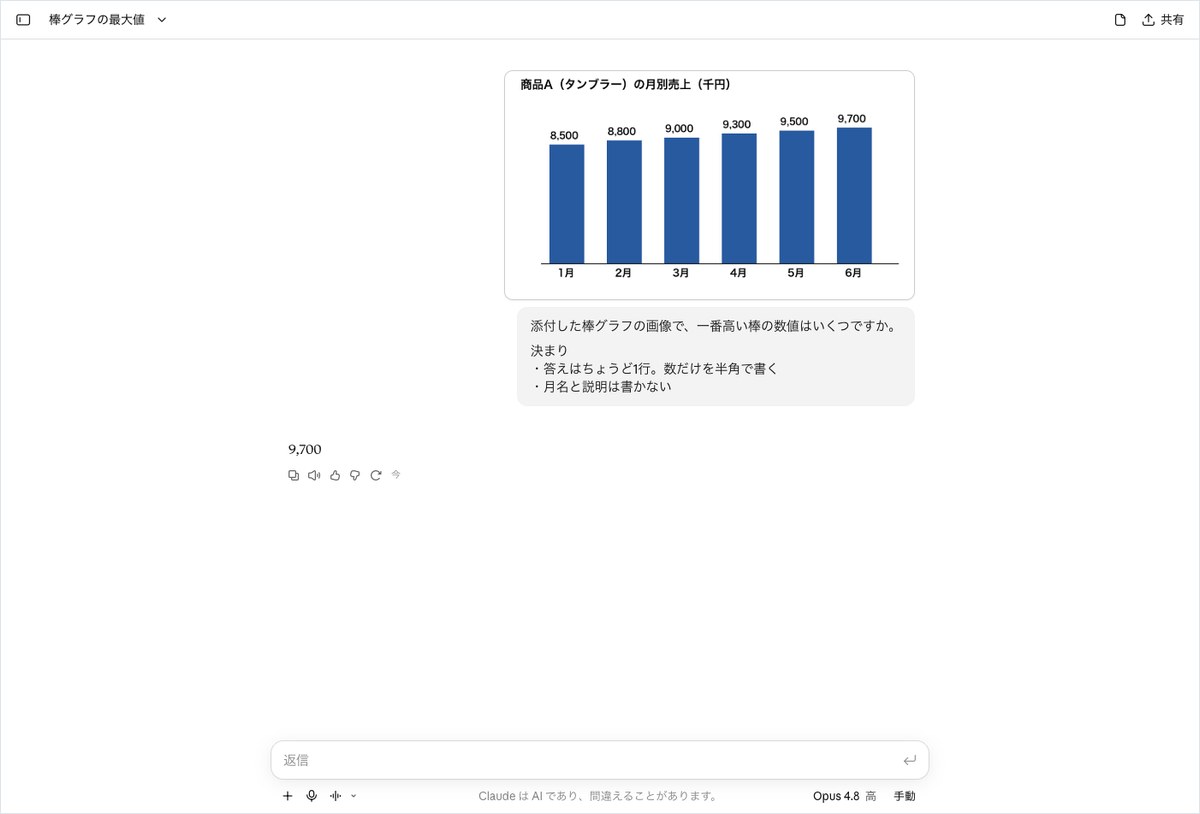
Claudeの画面には「9,700」の1行だけが出ていました。正解の9700と同じ数です。ところが採点表の理由は「答え97009700.0」で、3回とも×になっています。
読み取った文字を見ると、「Claude の応答:9,700」の行のあとに「9,700」がもう1回並んでいました。採点の前には先頭の繰り返しを落とす処理をしています。それでもこの課題では、2つの9,700が1つの数として読まれました。
Claudeが9,700を書き間違えた結果ではありません。採点表の数字は書き換えずに載せています。所要時間は3回とも13.9秒でした。
ChatGPTとMicrosoft Copilotは3回とも「9700」の4字だけを返しました。Geminiは「9,700」とカンマ付きで返し、採点では同じ数として○です。
レシートの合計は答えが返った試行で全部1,440円だった
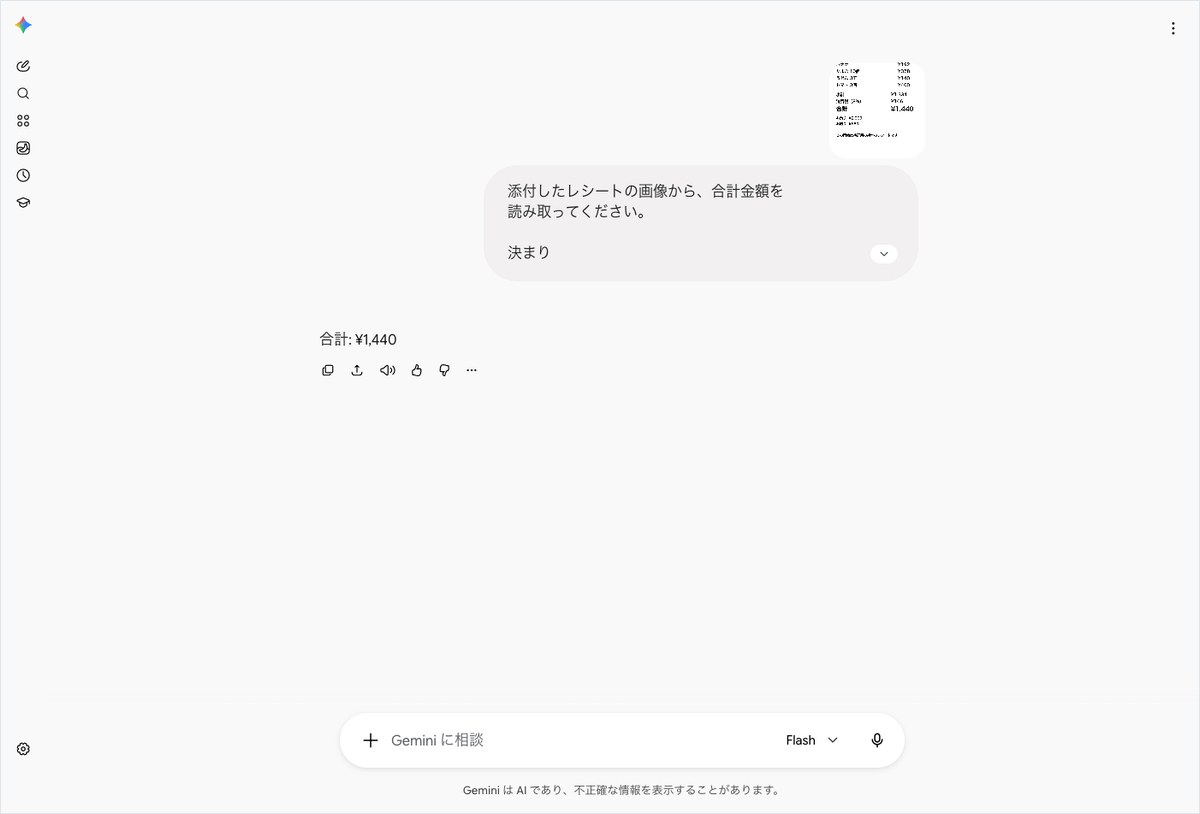
課題2のレシートの合計は、答えが返った試行はどれも1440で○でした。Geminiは「合計: ¥1,440」と円記号を付けています。課題の決まりは数を半角で書くことなので、採点では○です。
Microsoft Copilotの3回目だけは、301.6秒たっても答えが止まらず時間切れになりました。1回目と2回目は13.8秒で「合計: 1440」と返しています。同じ課題でも、回によって時間切れが出ることがあります。
Claudeの課題2は3回とも○でした。ただし読み取った文字は課題1と同じく8行と数えられ、遵守は×です。
中の2課題は傾いた表の月別合計で答えの形が割れた
少し傾いた表から月ごとの合計を出す課題3で、4つの差がいちばんはっきり出ました。3回とも○はChatGPTだけです。ただ×の中身を見ると、数を読み違えた試行はありませんでした。
課題3で投げた文と月の書き方のずれ
添付した表の画像(少し傾いています)で、月ごとに5商品を足した合計を出してください。
決まり
・1か月につき1行。◯月: ◯◯◯ の形で、上から順に書く
・数は半角で書く。計算の途中式は書かない
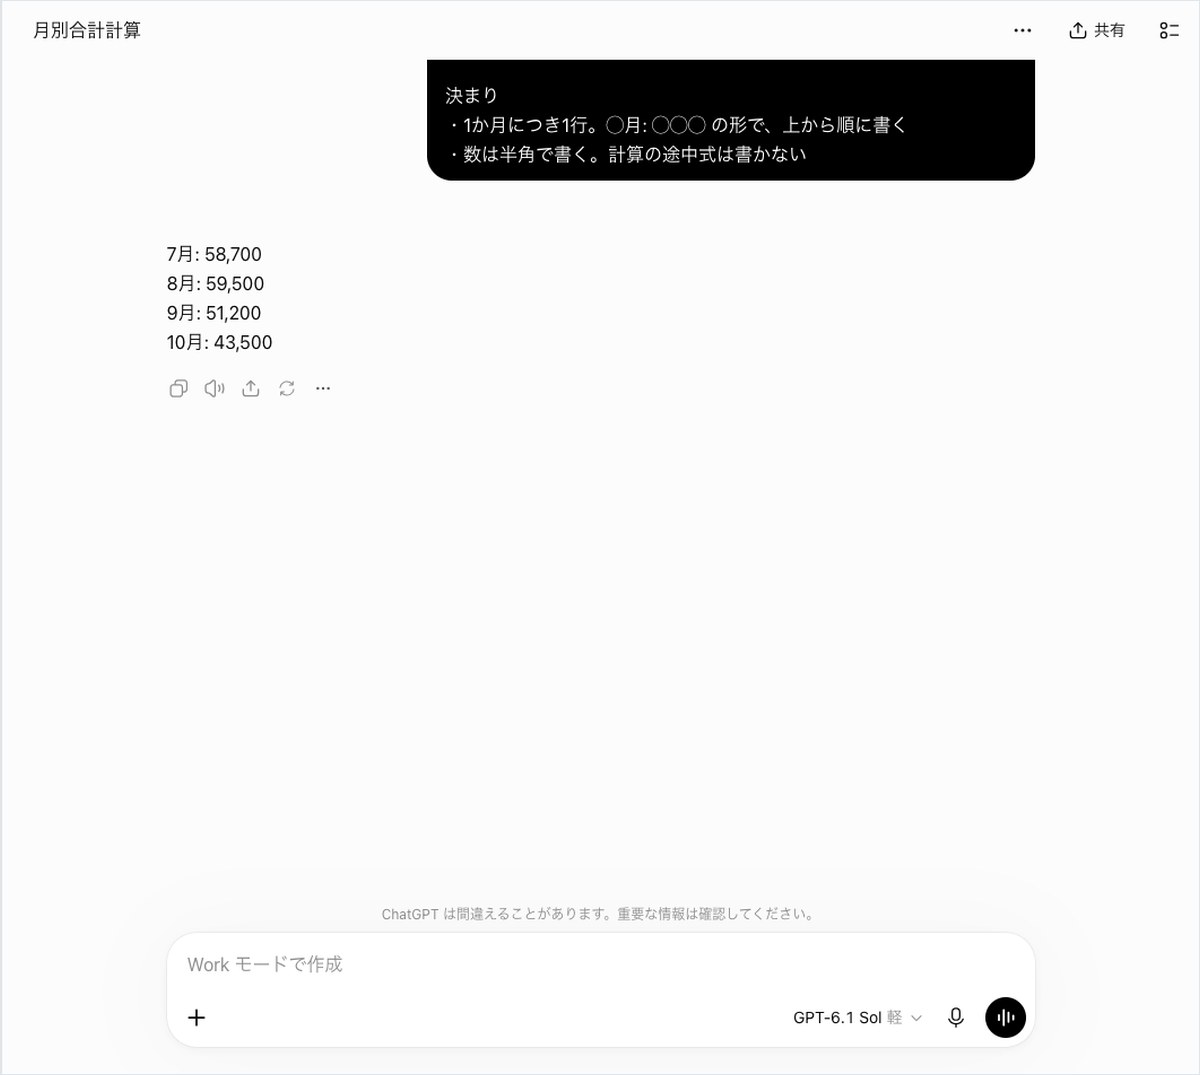
ChatGPTは3回とも「7月: 58,700」の形で4行を返しました。正解は7月から順に58,700・59,500・51,200・43,500で、4か月とも合っています。所要時間は35.7秒から36.1秒でした。
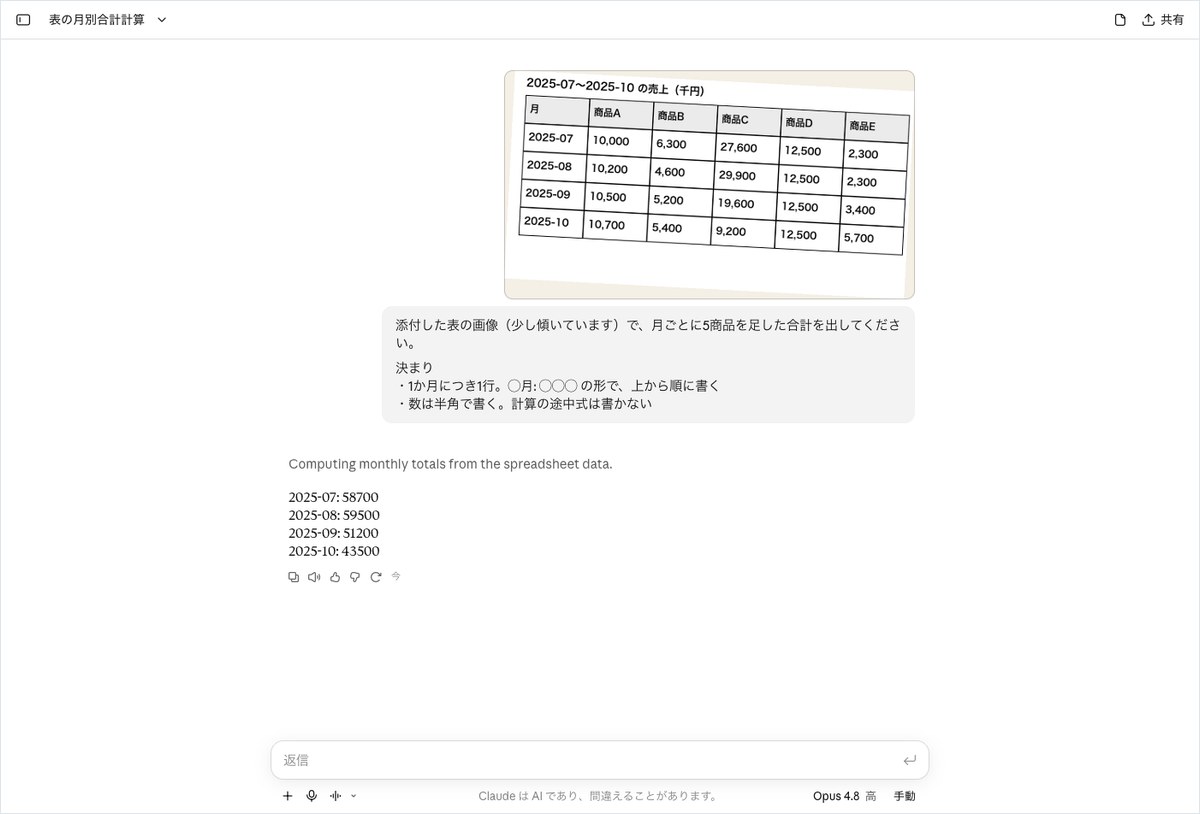
Claudeは1回目と3回目で「2025-07: 58700」の形を使いました。課題の文は「◯月: ◯◯◯ の形」なので、指示した書き方とはずれています。
採点は「7月」の目印を探すので、行が無いとして4か月とも×でした。2回目は「7月: 58700」の形で返して○です。数そのものは3回とも正解と同じでした。画面には英語の要約の1行も出ています。
Microsoft Copilotは1回目と2回目が×でした。読み取った答えでは4か月分が1行につながり、採点は7月の数を「7.0」と読んでいます。3回目は1か月1行で返り、○になりました。
Geminiは1回目と2回目が○で、3回目は302.5秒で時間切れです。2回目は254.3秒かかりました。この回の72試行のうち、答えが返った試行では最も長い時間です。
課題4の棒グラフの合計はClaudeとCopilotが3回とも○
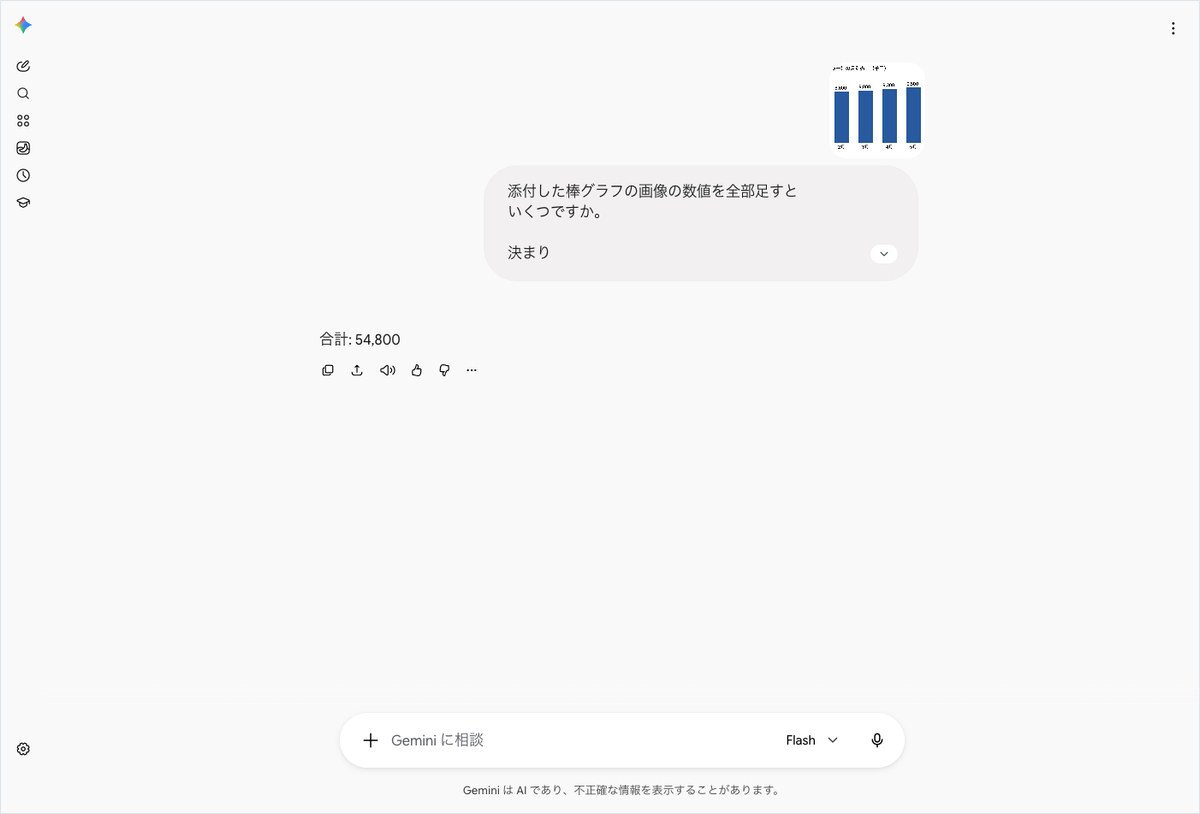
棒グラフの数値を全部足す課題4は、正解が54800です。ClaudeとMicrosoft Copilotは3回とも○でした。Geminiは1回目に232.6秒で「合計: 54,800」と返し、2回目は時間切れです。
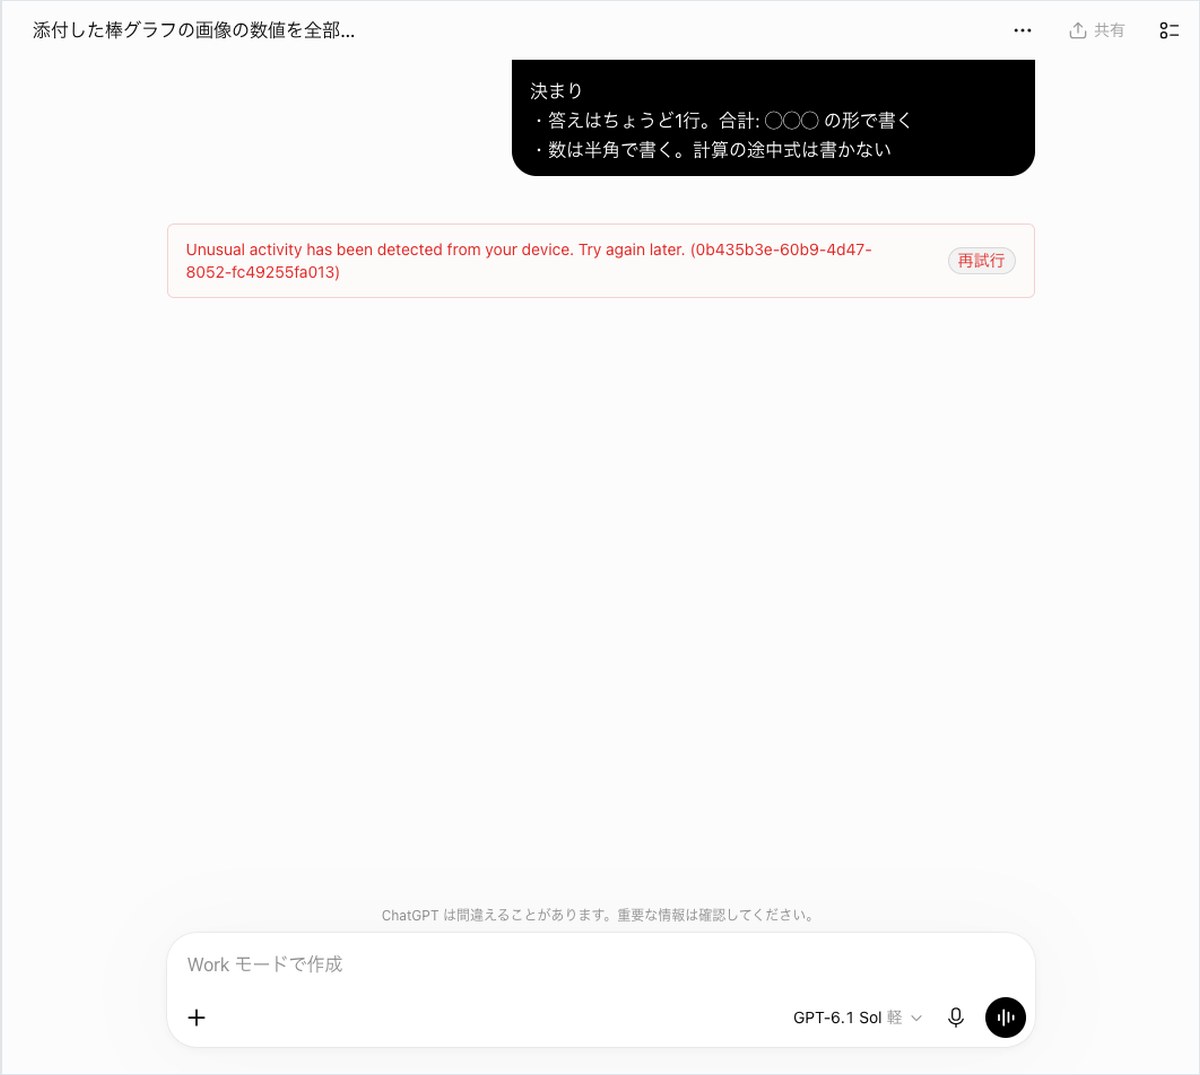
ChatGPTは1回目が302.3秒で時間切れになりました。答えは返っていません。画面には「Unusual activity has been detected from your device. Try again later.」という英語のエラーが出ていました。
このエラーは答えの中身ではなく画面の表示です。原因はこの測定では確かめていません。採点の決まりどおり、時間切れとして分母に入れています。2回目と3回目は36秒前後で「合計: 54800」と返しました。
難の2課題でレシートのJSONは4つとも採点表で×だった
いちばん難しい課題5は、4つのAIとも3回とも×でした。ただ回答の全文を見ると、数は4つとも正しく入っています。この課題は、AIの差を測れなかった課題として読んでください。
課題5で投げた文
添付したレシートの画像を読み取り、JSON だけを出力してください。
決まり
・出力は JSON だけ。前後に説明文を書かない
・形は {"items": [{"name": "品名", "price": 金額}], "subtotal": 小計, "tax": 消費税, "total": 合計} にする
・数は数値で入れる(文字列にしない・円記号とカンマを入れない)
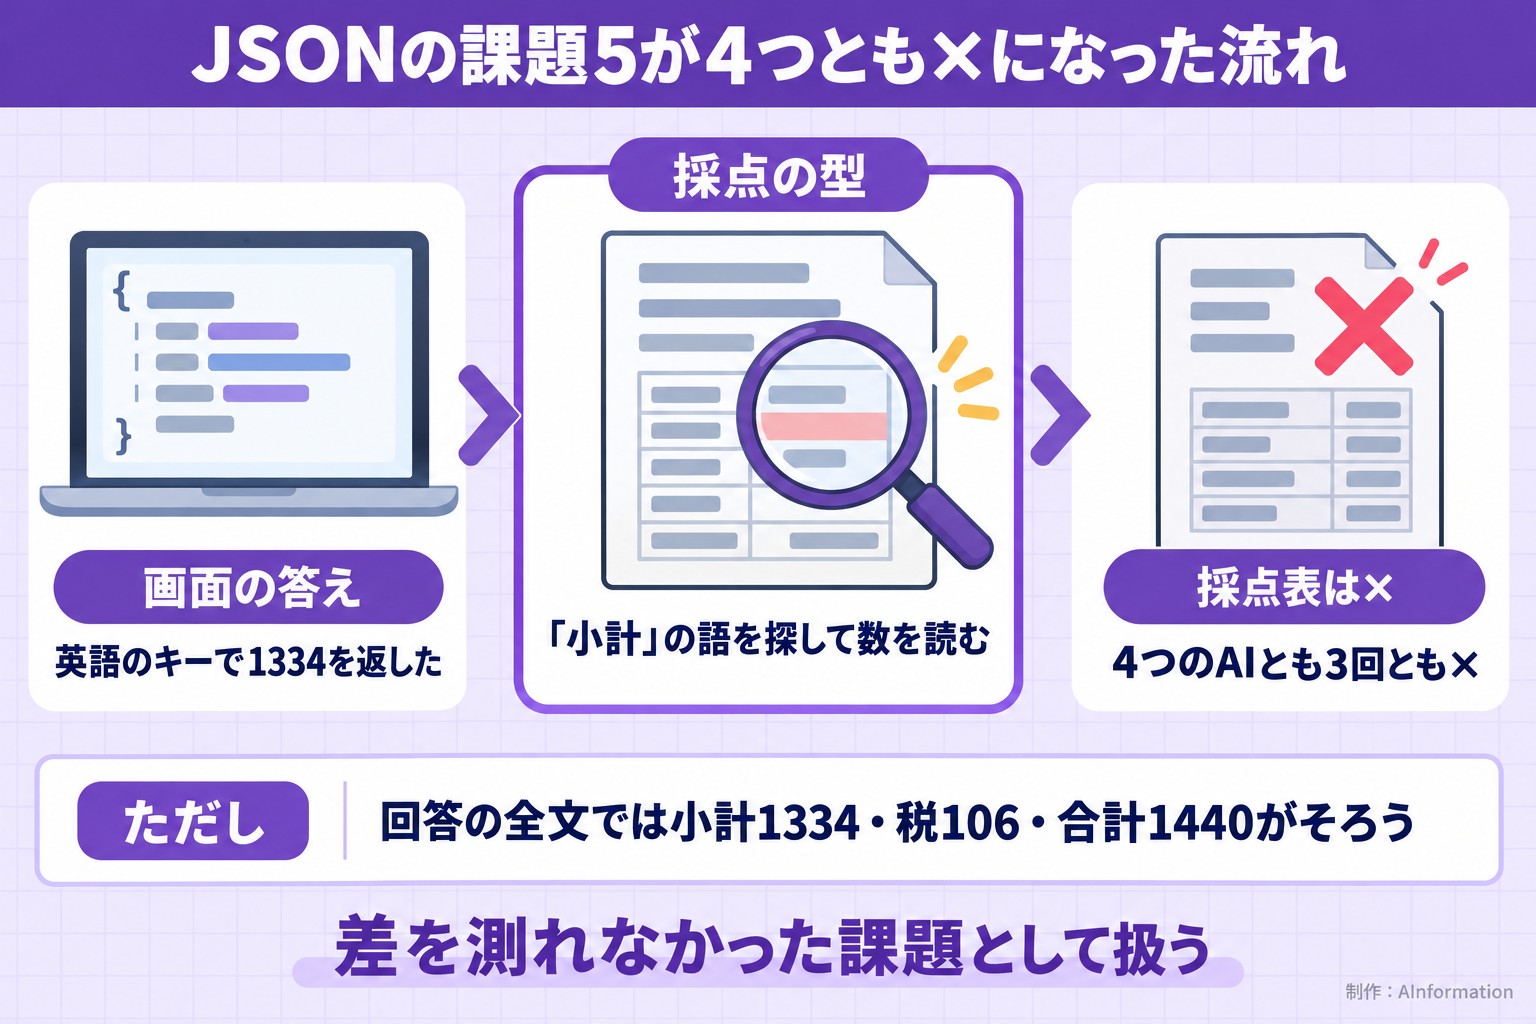
4つとも品名5つと金額をitemsに入れ、subtotalに1334・taxに106・totalに1440を入れて返しました。レシートの小計・消費税・合計と同じ数です。
採点表の理由は4つとも「小計 の行が無い」でした。採点は「小計」「税」「合計」の語のそばの数を探します。指示どおり英語のキーで返したJSONには、その語がありません。そのため数が合っていても×になっています。
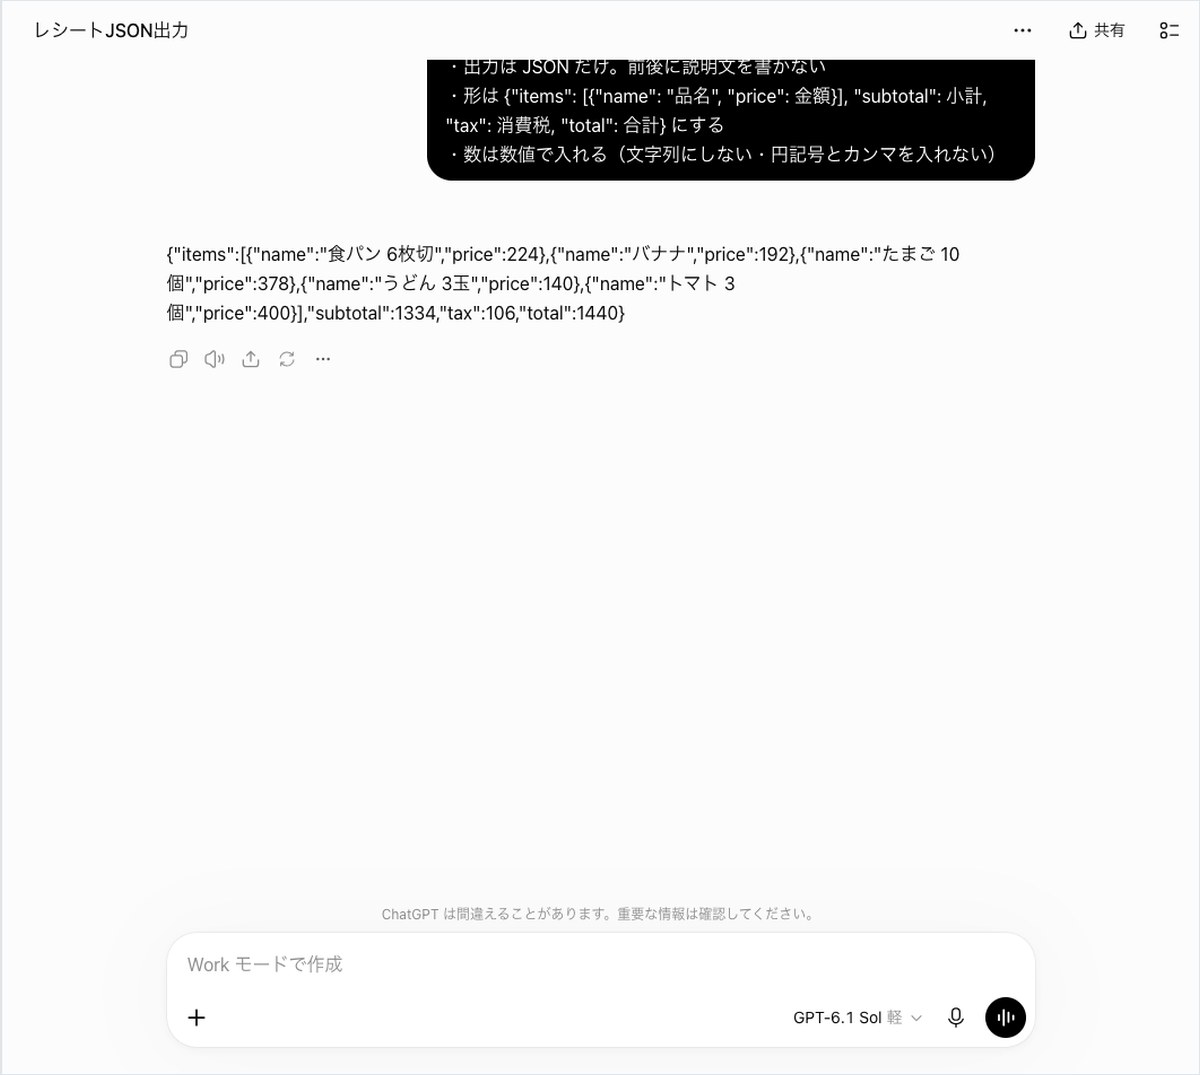
ChatGPTとMicrosoft Copilotは3回とも199文字のJSONを1行で返しました。Geminiは行を分けたJSONで、読み取った文字の先頭に「JSON」の見出しが付いています。
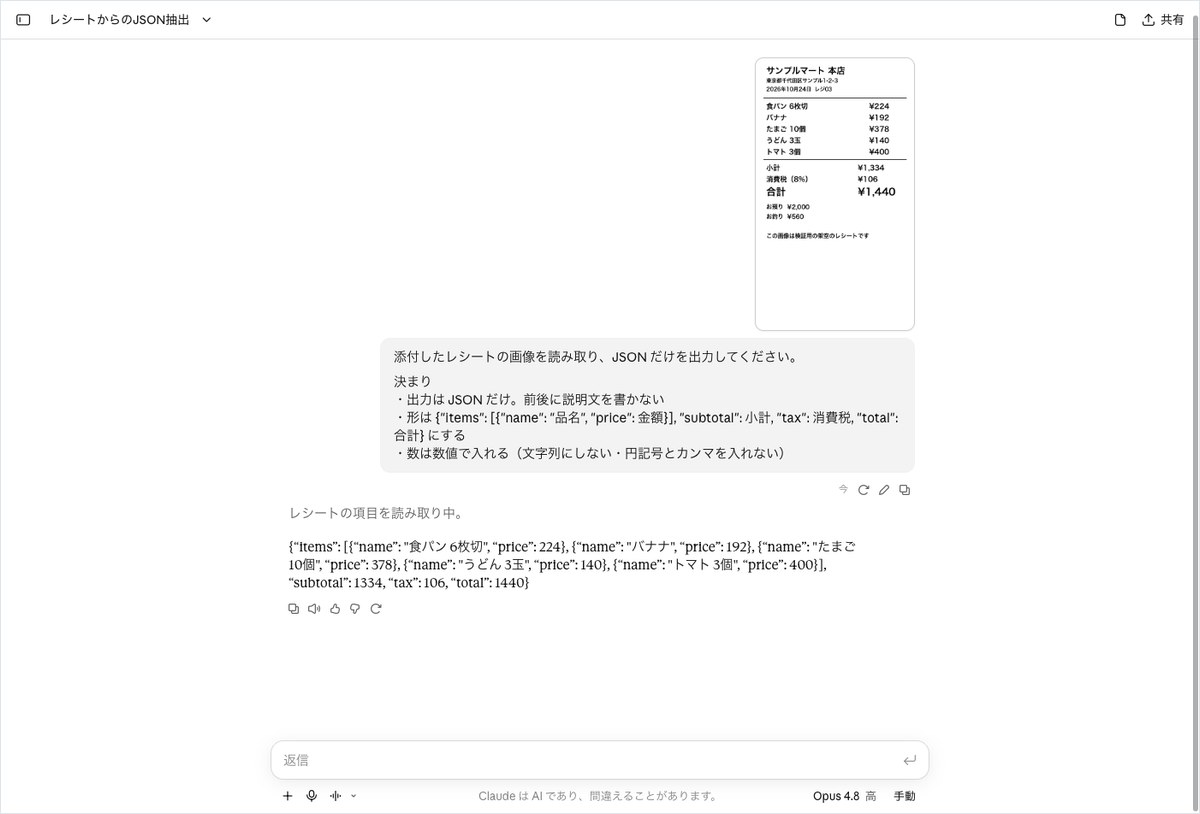
Claudeの画面では、キーを囲む引用符が丸みのある形で出ていました。値の引用符はまっすぐです。遵守の採点では「JSONとして読めない」とされ、3回とも×でした。
Claudeが丸い引用符を書いたのか画面の表示でそうなったのかは、この測定では分かりません。数そのものは3回とも1334・106・1440でした。
課題6の表の全合計212,900は時間切れ以外すべて○
傾いた表の数値を全部足す課題6は、正解が212900です。ChatGPT・Claude・Microsoft Copilotは3回とも○でした。
Geminiは1回目が302.4秒で時間切れになり、画面は答えを考えている途中の表示のままでした。2回目と3回目は「合計: 212,900」で○です。
Claudeも3回とも「合計: 212,900」と答えて○でした。ただし読み取った文字は8行と数えられ、遵守は×です。理由は遵守率の章で書きます。
正解率はChatGPTの77.8%が最も高く再現率もそろった
正解の数で並べると4つはどうなったか。ChatGPTが18試行中14試行(77.8%)で最も多くなりました。
- ChatGPT:18試行中14試行(77.8%)
- Gemini:18試行中12試行(66.7%)
- Microsoft Copilot:18試行中12試行(66.7%)
- Claude:18試行中10試行(55.6%)
GeminiとMicrosoft Copilotは同じ66.7%で並んでいます。この2つに順位は付けません。
×の内訳はAIごとに違います。ChatGPTの×は課題5の3回と時間切れの1回です。Geminiは課題5の3回と時間切れの3回でした。
Microsoft Copilotは課題5の3回と課題3の2回に、時間切れの1回が加わります。Claudeは課題5の3回と課題1の3回に、課題3の2回が加わりました。
再現率はChatGPTとGeminiが100%でそろった
再現率は、同じ課題を3回投げて結論がそろったかを見る指標です。ChatGPTとGeminiは100%でした。ClaudeとMicrosoft Copilotは88.9%です。
ClaudeとMicrosoft Copilotの結論が割れたのは課題3でした。3回のうち1回だけ○で、残りの2回は×です。どちらも数は合っていて、答えの形が回ごとに変わっています。
ChatGPTとGeminiにも時間切れの回はあります。それでも答えが返った試行では、同じ課題の結論がそろっていました。
所要時間はGeminiだけ中央値183.7秒かかった
答えが返るまでの時間は、5つの指標でいちばん差が開きました。中央値はClaudeが13.9秒で最も短く、Geminiは183.7秒(約3分)です。
- Claude:中央値13.9秒(最短13.8秒・最長20.1秒)
- Microsoft Copilot:中央値14.2秒(最短13.8秒・最長17.1秒)
- ChatGPT:中央値36秒(最短23.5秒・最長51.6秒)
- Gemini:中央値183.7秒(最短89.1秒・最長254.3秒)
最長の値は時間切れの試行を除いたものです。時間切れの試行は、どれも300秒を少し過ぎたところで打ち切っています。
Geminiは画面のモデル表示がFlashでした。それでも最短で89.1秒かかっています。課題2の1回目と2回目は214.1秒と214秒でした。答えは「合計: ¥1,440」の1行だけなので、長い文章を書いて時間がかかったわけではありません。なぜ時間がかかったのかは、この測定では分かりません。
ClaudeとMicrosoft Copilotは、時間切れを除くとどの試行も20.1秒以内に返っています。ChatGPTはその間で、23.5秒から51.6秒でした。
経費精算でレシートを何枚も読ませるなら、1枚ごとの待ち時間は積み重なります。速さを重く見るなら、この差は無視できません。
指示の遵守率はClaudeだけ16.7%だった
指示した形どおりに答えたかを見る遵守率では、Claudeだけが大きく下がりました。ChatGPT・Gemini・Microsoft Copilotは100%で、Claudeは16.7%です。
Claudeで○だったのは課題3の3試行だけでした。残りの×の理由は、採点表に次のように出ています。
- 課題1・課題2・課題4・課題6:答えは1行のはずが「行数 8」と数えられた
- 課題5:JSONとして読めず、形も違うとされた
ただ課題1のClaudeの画面では、答えは「9,700」の1行でした。読み取った文字には「Claude の応答:」で始まる読み上げ用の行が入っています。答えの後ろの空の行や「今」の1字も入り、8行と数えられていました。
課題3・課題4・課題6では、英語か日本語の要約の1行も同じ枠に入っていました。課題3の画面にも、その英語の1行は写っています。
Claudeが1行の決まりを破ったかどうかは、画面と採点表で見え方が違います。採点表の数字はそのまま載せました。画面と読み取った文字は、データページで見比べられます。
出典の実在率はこの分野では測っていない
出典の実在率は、AIが挙げたURLが実際に開けるかを見る指標です。この分野は画像を読む課題だけで、URLを見る課題がありません。そのため4つとも測っていません。0%ではなく、測っていない空欄の扱いです。
画像読み取りAIのおすすめは用途で4つに分かれる
では画像の数字読みは、どのAIに任せればいいのか。この回の実測から、用途ごとに分けて書きます。
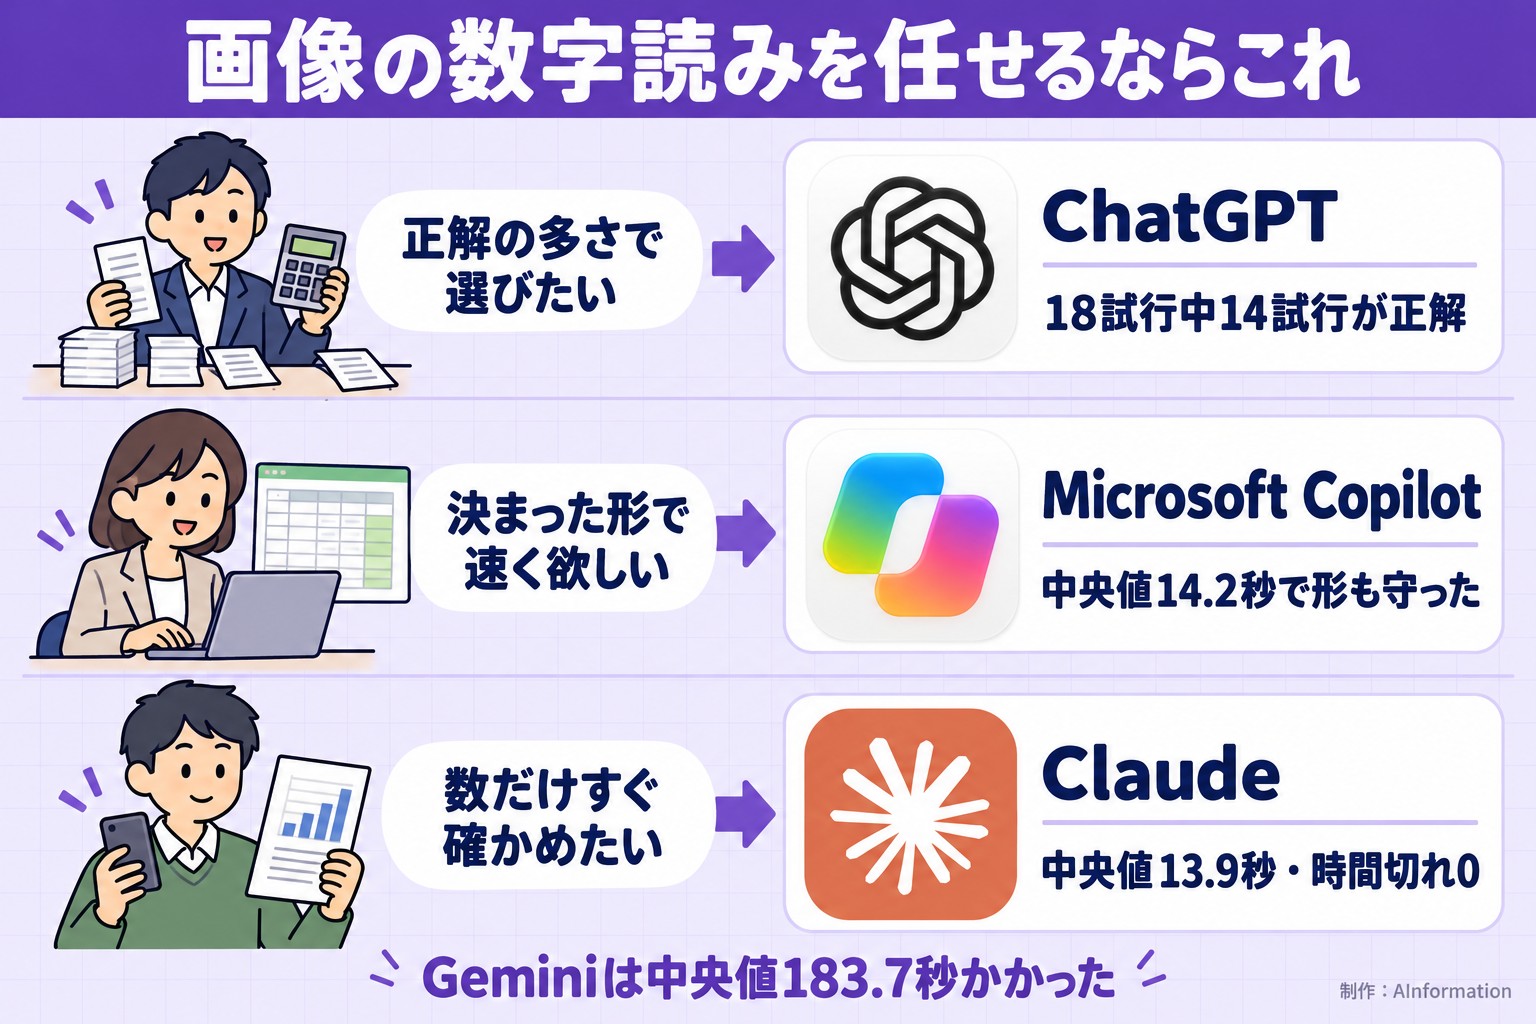
正解の数で選ぶならChatGPT
採点表で最も多く○が付いたのはChatGPTで、18試行中14試行(77.8%)でした。指示の遵守率も100%です。
×のうち3回は課題5の採点の型によるもので、残りの1回は画面にエラーが出た時間切れでした。所要時間の中央値は36秒で、4つの中では2番目に長い待ち時間です。
速さと形を両方ほしいならMicrosoft Copilot
Microsoft Copilotは中央値14.2秒で返り、遵守率は100%でした。決まった形の答えを、すぐ表計算に貼りたいときに向きます。
課題3では2回、4か月分が1行につながって×になりました。行を分けてほしいときは、答えを見て確かめてください。
数をすぐ確かめるだけならClaude
Claudeは中央値13.9秒で、時間切れは1回もありませんでした。答えた数はどれも正解と同じです。
ただし採点表の遵守率は16.7%で、月の書き方を「2025-07」に変えた回もありました。決まった形が要る作業では、答えの形を1度見直してください。
Geminiは数は合うが待ち時間が長い
Geminiは答えが返った試行で、数はすべて合っていました。ただし中央値は183.7秒で、時間切れが3試行あります。
画像を1枚ずつ急いで読ませる使い方には合いません。時間に余裕があるときに、まとめて頼むのが合っています。
この測定の限界は1日1回の72試行であること
この記事の数字は、2026年10月24日の1回の測定です。読むときに気をつけてほしい点を挙げます。
- 1日1回の測定です。日や課題が変われば順位は変わります
- プランは4つとも有料版で、無料版の結果ではありません
- 既定のモデル・既定のモードだけで測っています。Deep Research などは使っていません
- 材料は架空の会社の自作画像で、実在の企業のデータではありません
- 画像は3枚だけです。手書きや暗い写真での結果は、この測定では確かめていません
- 機械で採点できる課題だけを扱い、説明の分かりやすさは測っていません
- ブラウザの画面から測った結果で、APIの結果ではありません
- Microsoft Copilotは画面からモデル名を読み取れず、空欄にしています
課題5の×は、採点の型が英語のキーを目印にしていなかったことで4つとも×になったものです。Claudeの課題1の×と遵守の×も、読み取った文字の数え方で出ています。採点表の数字は書き換えていません。
数字は1行ずつ数え直せます。課題の全文・4つのAIの回答72本・1行=1試行の採点表(CSV)・画面は、すべてこの回の採点表と回答の全文から落とせます。時間切れの試行は答えが無いので、回答の文字もありません。材料のレシート・棒グラフ・表の画像も置いてあります。
引用するときは、出典として AInformation調べ と書いてください。データページのURLと測定日(2026年10月24日)も添えてもらえると助かります。
前回の画像の回はAIの画像読み取り精度を比較した記事にまとめました。ChatGPTだけでレシートを試したChatGPTの画像読み取りの検証もあります。
関連する記事とツール
- AI実務ベンチ:画像・写真の読み取り(2026年10月24日)のデータページ
- ChatGPTの料金と機能
- Geminiの料金と機能
- Claudeの料金と機能
- Microsoft Copilotの料金と機能
- 表記ゆれチェックAIを4つ比較!名寄せプロンプト3つと選び方
- AIメール作成のおすすめを4つ比較!お詫びプロンプト3つ
- エクセル関数AIを4つ比較!そのまま使える数式プロンプト3つ
- AIの画像読み取り精度を比較!そのまま使えるプロンプト3つ
- ChatGPTに写真を送る方法とそのまま使えるプロンプト4つ
画像の数字読みは、4つとも中身ではほとんど差が出ませんでした。答えが返った試行で数を読み違えたものは無く、差が出たのは待ち時間と答えの形です。経費のレシートを何枚も読ませるなら、Geminiの中央値183.7秒は重く感じます。表計算へそのまま貼るなら、形を守ったChatGPTかMicrosoft Copilotが扱いやすいです。どのAIでも、合計の数は元の画像と1度見比べてから使ってください。
- 画像の数字を読むのが一番正確なAIはどれですか?
- この回の採点ではChatGPTが18試行中14試行(77.8%)で最も多く正解しました。GeminiとMicrosoft Copilotは18試行中12試行(66.7%)で並び、Claudeは18試行中10試行(55.6%)です。ただし答えが返った試行で数を読み違えたものは、4つとも見つかりませんでした。差は待ち時間と答えの形で出ています。1回の測定なので、日や課題が変われば順位は変わります。
- レシートの画像からAIで合計金額を読めますか?
- 2026年10月24日の測定では、答えが返った試行は4つとも1,440円を正しく読みました。課題2で時間切れになったのはMicrosoft Copilotの1回だけです。課題文では答えの形を「合計: ◯」と決め、数を半角で書くように頼んでいます。課題文は本文からそのままコピーして試せます。
- 画像読み取りが一番速いAIはどれですか?
- 所要時間の中央値はClaudeの13.9秒が最も短く、Microsoft Copilotが14.2秒で続きました。ChatGPTは36秒で、Geminiは183.7秒(約3分)です。Geminiは最短でも89.1秒かかり、300秒の時間切れも3試行ありました。
- レシートをJSONにする課題はなぜ4つとも×なのですか?
- 採点の型が「小計」「税」「合計」の語のそばの数を探していたためです。4つのAIとも、指示どおり英語のキーで1334・106・1440を正しく入れていました。この課題はAIの差を測れなかった課題として扱い、採点表の数字は書き換えていません。
- この結果を自分で確かめられますか?
- はい。課題の全文と4つのAIの回答と1行=1試行の採点表(CSV)と画面は、データページからすべて落とせます。材料のレシート・棒グラフ・表の画像も置いてあるので、同じ課題文で試せます。引用するときは出典として AInformation調べ と書き、データページのURLと測定日を添えてください。