RTX 5090は定価の3倍に高騰した
NVIDIA GeForce RTX 5090の公式価格は39万3800円だが、2026年9月時点のAmazon.co.jpでは90万円を超え100万円以上の出品も並ぶ。価格.comでも同じ状況で、AI需要によるVRAM 32GB搭載グラボの価格高騰が止まらない。
ローカルでLLMを動かすにはモデル全体をVRAMに載せる必要がある。VRAM容量が足りなければ量子化で精度を犠牲にするしかなく、回答品質が下がる。100万円を出せるユーザーは限られるため、同じVRAM 32GBを安く積める代替GPUが求められていた。
- 6月GIGAZINEがIntel Arc Pro B70 Creator 32GBを税込22万4800円で購入
- 9/17Amazon.co.jpでRTX 5090が90万〜100万円超に高騰していることを確認
- 9/19GIGAZINEがQwen3.8 27BとMiniMax H3の実測結果を公開
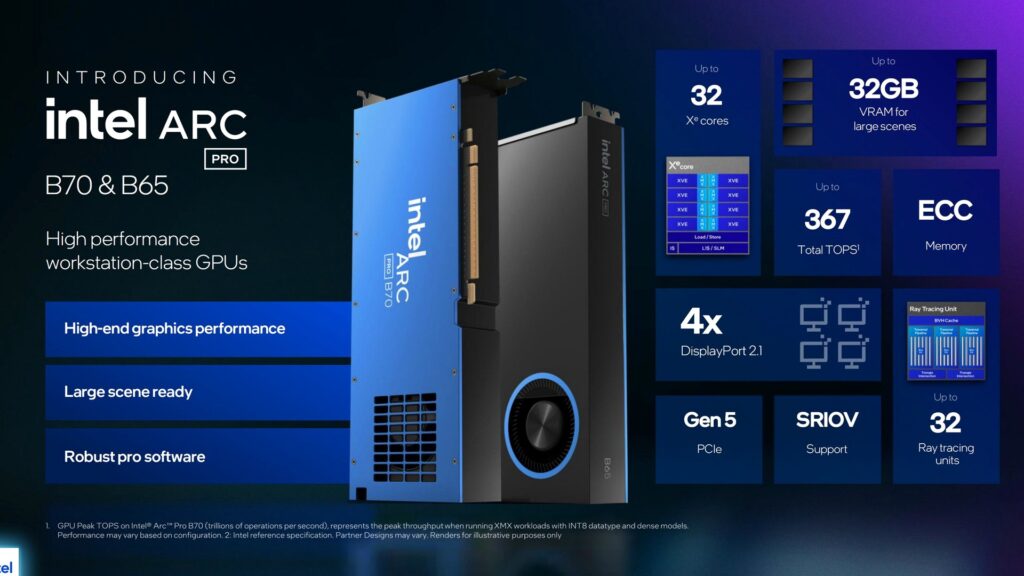
Intel Arc Pro B70は同じ32GBで約30万円
ASRock製「Intel Arc Pro B70 Creator 32GB」はAmazon.co.jpで税込29万8054円。GIGAZINEの購入時(2026年6月)は税込22万4800円だった。RTX 5090の3分の1以下の価格でVRAM 32GBを確保できる。
全長271mmとコンパクトで、PCIe 5.0 x16スロットに装着しIntel公式サイトからドライバーを入れれば動く。ドライバーは安定版の「Arc Pro グラフィックス」と最新対応の「Arc グラフィックス」の2種類がある。
Qwen3.8 27Bが23.4tok/sで動いた
GIGAZINEがUnsloth Desktopで実測した結果をまとめる。内部で動くllama.cppのバージョンはb11007だ。
Qwen3.8 27Bの4bit量子化版(Q4_K_XL)のデコード速度は23.4tok/sでVRAM使用量は30.0GB。共有GPUメモリも1.0GB使った。8bit量子化版(Q8_K_XL)は15.9tok/sでVRAM 30.2GB+共有1.5GB。一般に8bit量子化は非量子化モデルとほぼ同じ精度とされている。つまり30万円未満のGPUで27Bモデルをフル精度に近い状態で回せる。
参考としてRTX 5070 Ti(VRAM 16GB)では同じQwen3.8 27Bを2bit量子化(IQ2_S)まで落としてようやく20〜30tok/sだった。VRAM容量の差がそのまま量子化レベル=回答品質の差になる。
社外秘データを外に出さずAIを使える
ローカルLLMの最大の利点はデータが外部に出ない点だ。未発表の企画書やソースコードをクラウドに送らずAI処理できるため情報漏洩リスクをなくせる。従量課金のAPIと違い初期投資だけで済む。
Intel Arc Pro B70はゲーム用途には向かないが、LLM推論に加えてComfyUIによる画像・動画生成もVRAM 32GB内で実行できた。GIGAZINEはMiniMax H3の動画生成もこのGPUで検証している。GPU選びではVRAM容量を最優先にし、速度はモデルの量子化レベルで調整するのがローカルAI運用の基本になる。
- tok/s
- 1秒あたりに生成されるトークン(単語の断片)の数。数値が大きいほどAIの応答が速い
- 量子化
- AIモデルの計算精度を下げてファイルサイズとVRAM使用量を減らす手法。4bitや8bitなどの段階がある
社内データを外に出せない日本企業にとってローカルLLMは現実的な選択肢になりつつある。RTX 5090が品薄で100万円を超える今、30万円未満でVRAM 32GBを確保できるIntel Arc Pro B70は予算が限られる現場で注目に値する。速度よりもVRAM容量を優先する考え方がローカルAI導入の成否を分ける。API課金が不要になる利点も長期運用では大きい。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年9月20日