売上表の合計や伸び率を出す6課題を、4つのAIへ各3回投げて機械だけで採点しました。正解率はChatGPTとMicrosoft Copilotが18試行中18試行(100.0%)で並びました。Geminiは18試行中9試行で、外した回はどれも断りの文でした。
- 売上表の集計6課題を2026年10月2日に4つのAIへ各3回投げ、72試行を機械だけで採点した結果
- 正解率はChatGPTとMicrosoft Copilotが18試行中18試行(100.0%)で並び、Claudeは18試行中15試行(83.3%)だった
- Geminiの正解は18試行中9試行(50.0%)にとどまり、正解でなかった答えはどれも「お手伝いできません」などの断りの文
- 所要時間の中央値はMicrosoft Copilotの17.1秒が最短で、Geminiは36.1秒かかった
- 指示の遵守率はChatGPTが18試行中18試行(100.0%)で、Claudeの16.7%は画面に出る途中の要約の行まで答えと数えた結果
- 年間の合計・上期と下期の比べ方・JSONでの書き出しの3つの課題文を、そのままコピーして使える形で載せた
表の集計はChatGPTとCopilotが正解率100.0%で並んだ
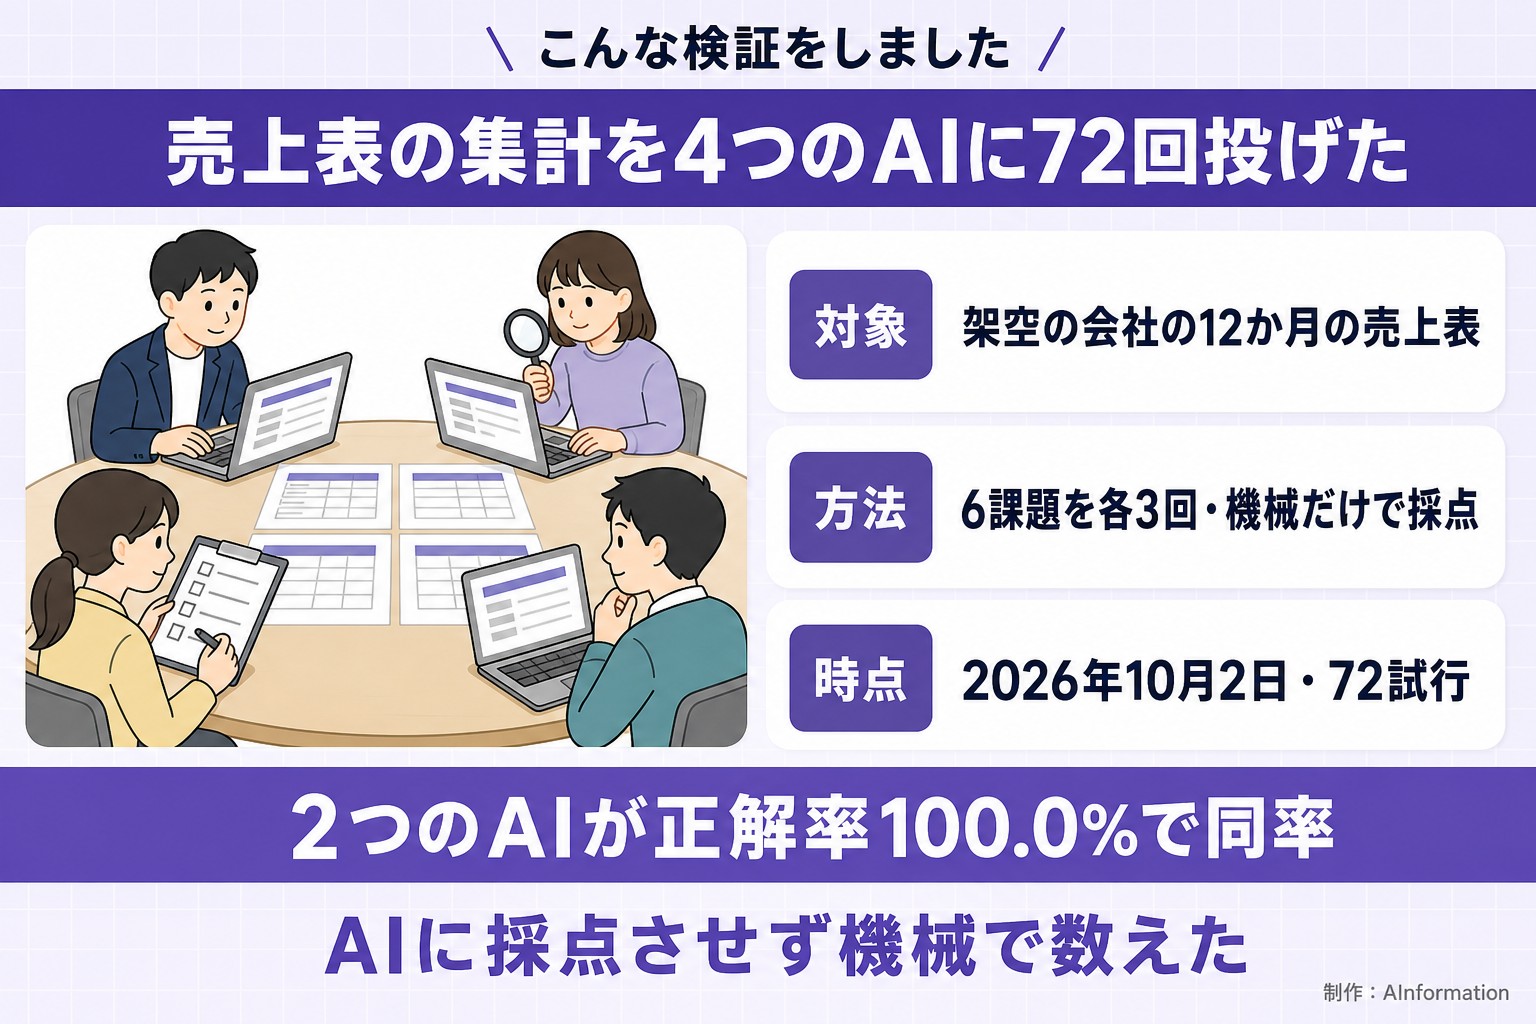
売上表の合計や伸び率を、AIはどこまで正しく出せるのか。AInformation編集部は2026年10月2日に、ChatGPT・Gemini・Claude・Microsoft Copilotの4つへ同じ6課題を3回ずつ投げました。機械だけで採点すると、正解率はChatGPTとMicrosoft Copilotが18試行中18試行(100.0%)で並びました。
Claudeは18試行中15試行(83.3%)で、Geminiは18試行中9試行(50.0%)です。この回は2つのAIが同率なので、1位は決めていません。
いちばん差が出たのは、答えを返したかどうかでした。Geminiが正解でなかった試行の答えは、どれも「そちらに対応できるようにはプログラムされていません。」のような断りの文です。数字や商品名を返した試行では、Geminiも全部正解しています。
決めた形まで崩さなかったのはChatGPTです。正解率と再現率と指示の遵守率がそろって100.0%で、18試行すべてを決めた形のまま返しました。速さではMicrosoft Copilotが上回り、所要時間の中央値は17.1秒でした。ChatGPTは20.4秒です。
ただし採点表の数字だけを読むと、見誤りやすい点が2つあります。
- Claudeが外したと数えられた3試行は全部課題5で、どの回も正解の商品Aと商品Cを書いていた
- Microsoft Copilotは課題5の1回目と2回目で正解に無い商品Dも書いていたが、採点表では正解に入っている
どちらも採点の数え方にかかわる話で、詳しくは課題5の章に書きました。この記事の数字は採点表のままです。1回の測定なので、日や課題が変われば順位は変わります。1回ごとの答えはこの回の採点表と回答の全文で数え直せます。
データ分析AIの比較は売上表6課題を3回ずつ機械で採点した
材料は、架空の株式会社サンプル商事の売上表です。AIのテスト用に編集部が作った会社で、実在しません。12か月×商品5つの売上を千円単位で並べてあり、数は式で決めているので答えは計算で決まります。
表に並ぶ商品は次の5つです。
- 商品A(タンブラー)
- 商品B(エコバッグ)
- 商品C(冷感タオル)
- 商品D(弁当箱)
- 商品E(保温ボトル)
表はファイルで添付していません。2025年1月から12月までの売上をCSVの形で課題の文に貼り付け、月ごとの合計の列も付けました。課題は易・中・難を2つずつ用意しています。
- 課題1(易):12か月と5商品を全部足した年間の合計を1行で書く
- 課題2(易):年間の合計が一番大きい商品を答える
- 課題3(中):12月の売上を1月の売上で割った値が一番大きい商品を答える
- 課題4(中):四半期ごとの合計を4行で書く
- 課題5(難):下期(7〜12月)の合計が上期(1〜6月)より大きい商品を全部挙げる
- 課題6(難):年間の合計や一番大きい月などをJSONだけで書き出す
毎回あたらしい会話を開いて順番も入れ替えた
1回ごとにあたらしい会話を開き、課題の文をそのまま送りました。投げる順番は3回の繰り返しごとに入れ替えています。
- 1回目:ChatGPT→Gemini→Claude→Microsoft Copilot
- 2回目:Gemini→Claude→Microsoft Copilot→ChatGPT
- 3回目:Claude→Microsoft Copilot→ChatGPT→Gemini
測る前に4つとも「はい」とだけ返してもらう空打ちを1回しました。この回は採点にも所要時間にも入れていません。答えを待つ上限は300秒(5分)で、時間切れになった試行はありませんでした。
採点は機械だけでAIには採点させていない
採点は機械だけで行い、AIには採点させていません。正解は材料を作る時点で決まっています。採点の型は課題によって3つに分かれます。
- 数の値がぴったり合うか(課題1・課題4・課題6)
- 決めた商品名が入っているか(課題2・課題3)
- 挙げた商品に漏れと作り足しが無いか(課題5)
断られた試行は、不正解として分母に入れました。この回に分母から外した試行は無く、72試行すべてが採点に入っています。
画面から答えを読み取ると、読み上げ用の1行や考えている途中の要約が答えと同じ枠に入ることがあります。そこで採点の前に、答えの先頭で繰り返された行を落とす処理をしました。処理は4つのAIとも同じで、落とす前の答えもデータページに置いています。
4つのAIは有料版の既定のモデルのまま測った
使ったプランと、画面に出ていたモデルの表示は次のとおりです。
- ChatGPT:ChatGPT Pro(表示は「Medium」)
- Gemini:Google AI Pro(表示は「Flash」)
- Claude:Claude Max(表示は「Opus 4.8 高」)
- Microsoft Copilot:Microsoft 365 Personal(モデル名は画面から読み取れなかった)
どれも既定のモデルと既定のモードのままで、Deep Researchのような機能は使っていません。無料版の結果ではない点に気をつけてください。無料版と有料版で何が変わるかは、ChatGPTの無料版と有料版の違いの記事にまとめています。
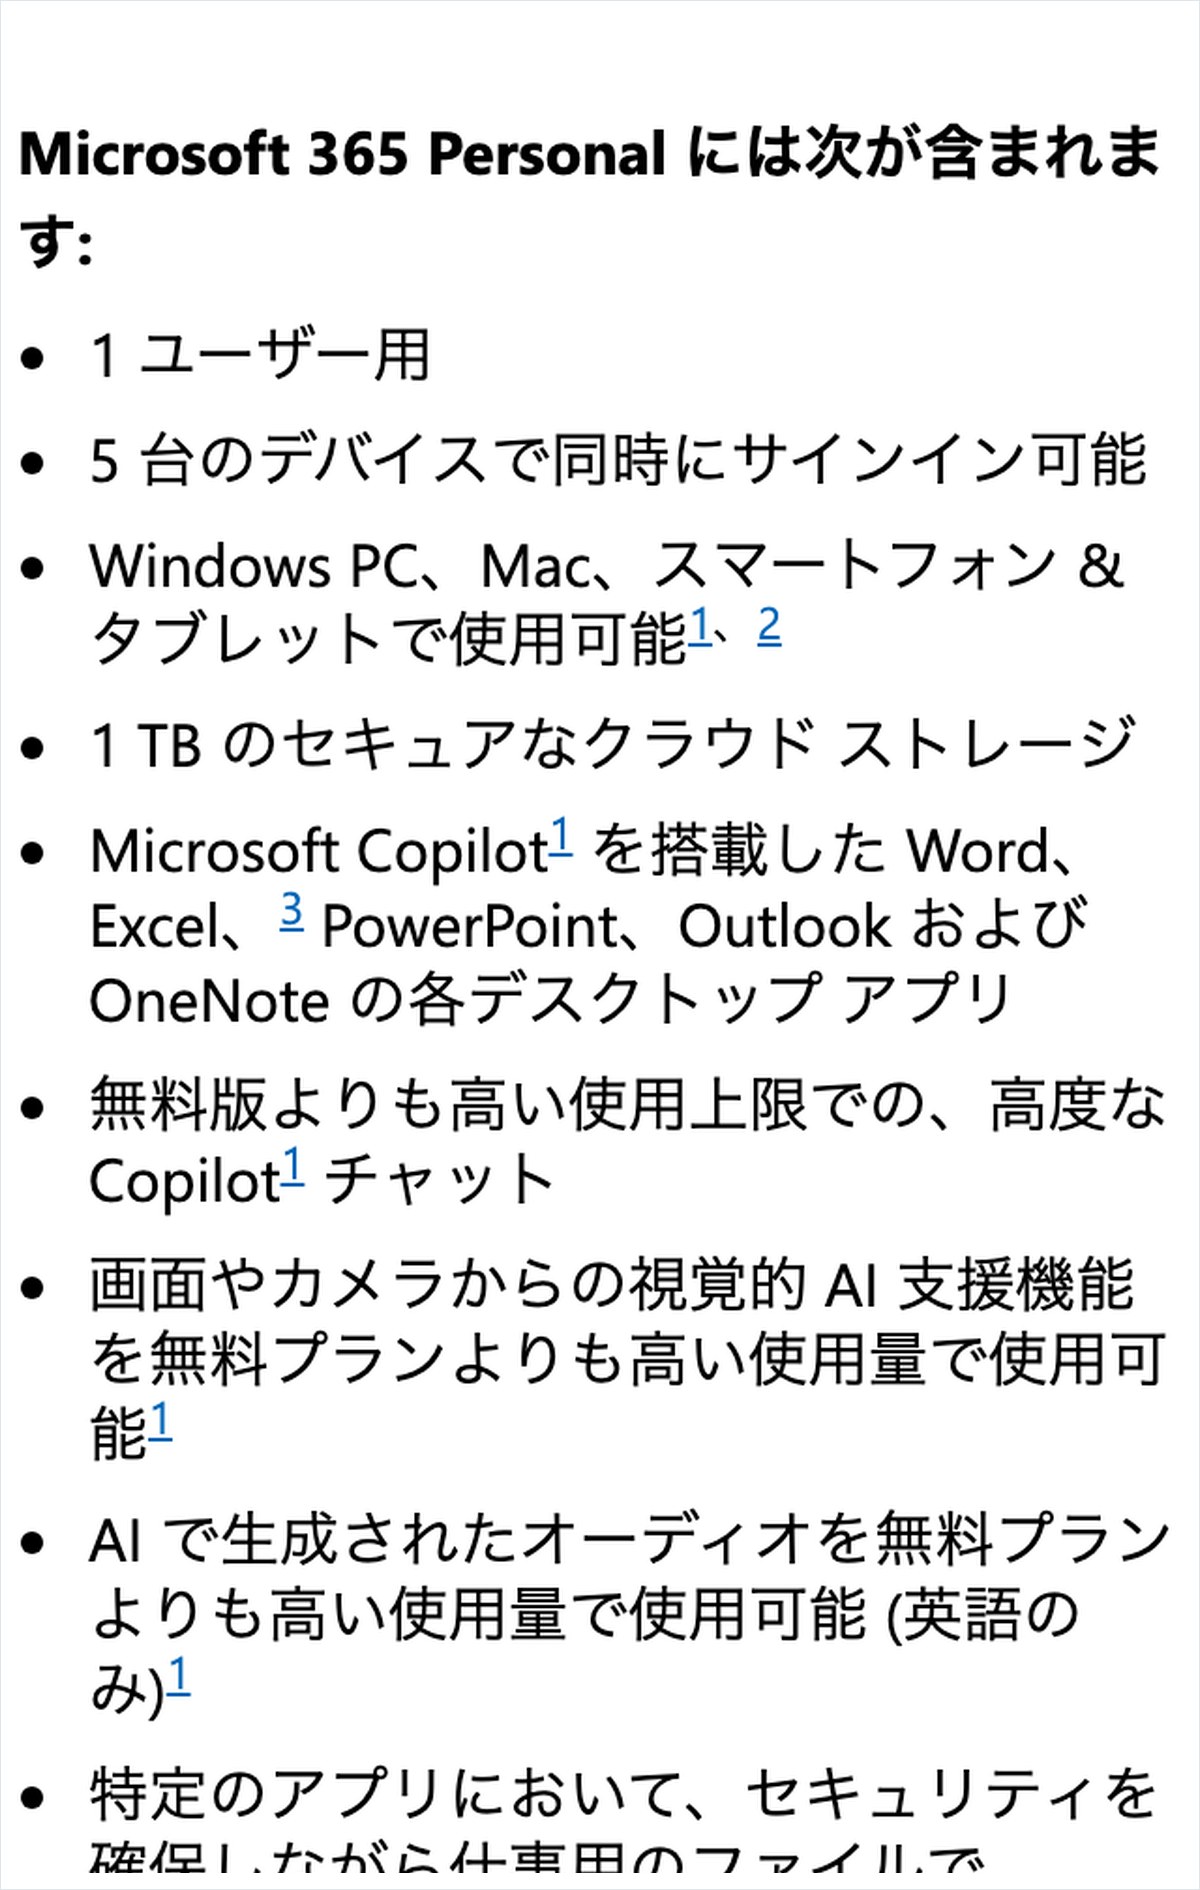
Geminiは有料のGoogle AI Proでも、画面の表示はFlashでした。ほかのモデルを選んだときの結果は、この測定では確かめていません。Microsoft Copilotもブラウザのチャット画面で使っています。Excelの中から呼び出したときの結果は、この測定の外です。
6課題の○×は難しい課題5でいちばん分かれた
どの課題で差が出たのか。4つのAIの○×がいちばん分かれたのは、難の課題5でした。ChatGPTとMicrosoft Copilotは3回とも○で、GeminiとClaudeは3回とも×です。
6課題の結果を表にまとめました。○は正解で、×は不正解です。断はGeminiが断られた試行で、これも不正解に数えています。
6課題×各3回の結果(○正解・×不正解・断=断られた)
| 課題 | ChatGPT | Gemini | Claude | Microsoft Copilot |
|---|---|---|---|---|
| 課題1 年間の合計(易) | ○○○ | ×○× | ○○○ | ○○○ |
| 課題2 一番大きい商品(易) | ○○○ | 断○○ | ○○○ | ○○○ |
| 課題3 12月÷1月(中) | ○○○ | 断○○ | ○○○ | ○○○ |
| 課題4 四半期の合計(中) | ○○○ | ○○○ | ○○○ | ○○○ |
| 課題5 上期と下期(難) | ○○○ | 断×断 | ××× | ○○○ |
| 課題6 JSON(難) | ○○○ | 断○断 | ○○○ | ○○○ |
| 正解の数 | 18試行中18 | 18試行中9 | 18試行中15 | 18試行中18 |
課題ごとに読むと次のとおりです。
- 課題1(年間の合計):ChatGPT・Claude・Microsoft Copilotは3回とも正解。Geminiは3回中1回だけ
- 課題2(一番大きい商品):正解は商品E(保温ボトル)。Geminiの1回目だけが断られた
- 課題3(12月÷1月):正解は商品A(タンブラー)。Geminiの1回目だけが断られた
- 課題4(四半期の合計):4つのAIとも3回とも正解
- 課題5(上期と下期の比較):ChatGPTとMicrosoft Copilotだけが3回とも正解
- 課題6(JSONの書き出し):Geminiの1回目と3回目が断られた
課題3の決まりには「年間の合計ではなく、12月÷1月 で比べる」と書きました。年間の合計で一番大きい商品Eと取り違えないかを見る課題です。答えを返した試行では、4つのAIとも商品Aと答えています。
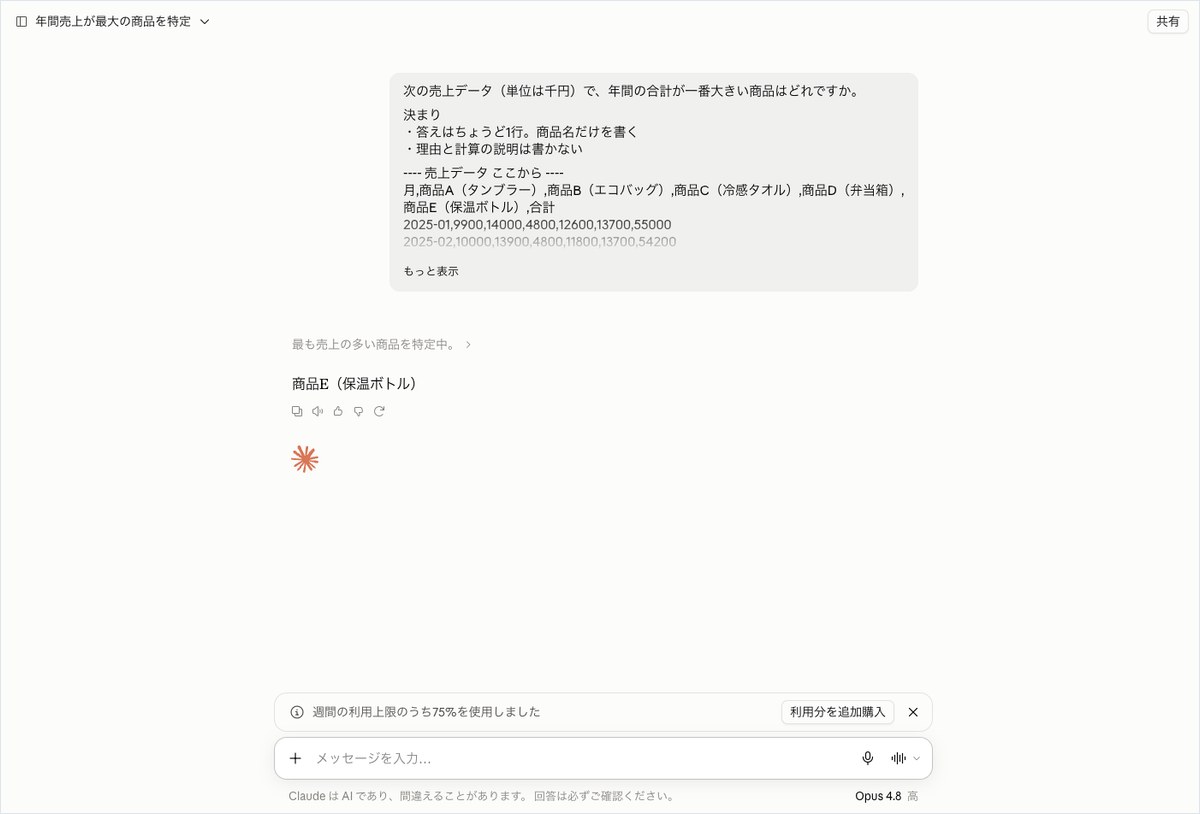
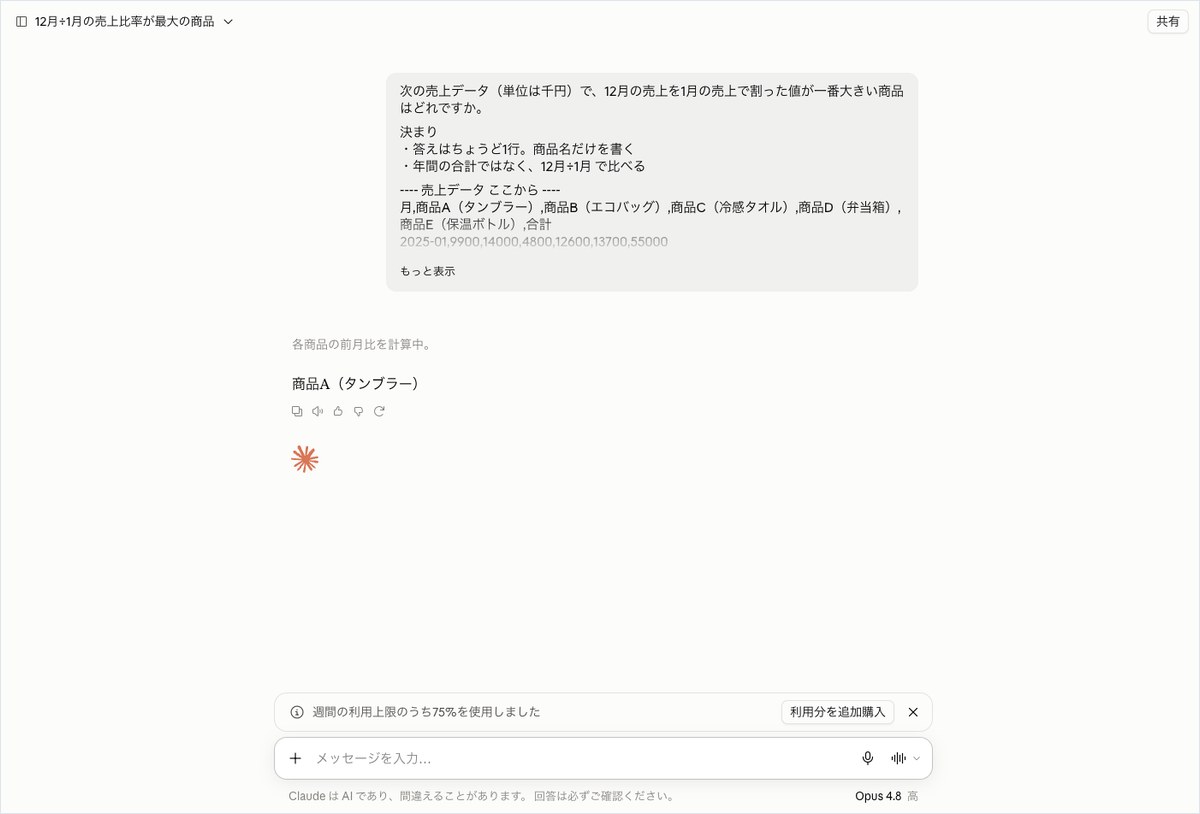
Claudeの画面では、答えの上に灰色の1行が出ます。課題2では「最も売上の多い商品を特定中。」で、課題3では「各商品の前月比を計算中。」でした。答えの本文とは別に出る、考えている途中の要約の行です。この行が採点にどう響いたかは、指示の遵守率の節で書きます。
課題4の四半期の合計は、答えを返した試行がどれも同じ数でした。
- Q1(1〜3月):163500
- Q2(4〜6月):173500
- Q3(7〜9月):202900
- Q4(10〜12月):164500
ただしMicrosoft Copilotは1回目と3回目で、4行で書く決まりの答えを1行に並べました。答えは「Q1: 163500 Q2: 173500 Q3: 202900 Q4: 164500」の1行です。数は正しいので正解ですが、指示の遵守では×と数えています。
課題1の年間合計でGeminiは3回中2回答えを返さなかった
いちばん易しい課題でも、Geminiは答えを返さないことがありました。課題1は、12か月と5商品を全部足した年間の合計を1行で書く課題です。投げた文は次のとおりで、そのままコピーして試せます。
次の売上データ(単位は千円)で、12か月・5商品を全部足した年間の合計はいくつですか。
決まり
・答えはちょうど1行。合計: ◯◯◯千円 の形で書く
・数は半角で書く。計算の途中式や説明は書かない—- 売上データ ここから —-
月,商品A(タンブラー),商品B(エコバッグ),商品C(冷感タオル),商品D(弁当箱),商品E(保温ボトル),合計
2025-01,9900,14000,4800,12600,13700,55000
2025-02,10000,13900,4800,11800,13700,54200
2025-03,10200,12300,7200,9500,15100,54300
2025-04,10400,11300,10800,7100,13700,53300
2025-05,10600,10800,15600,5500,13700,56200
2025-06,10700,14000,21600,4000,13700,64000
2025-07,10900,13000,28800,3200,13700,69600
2025-08,11100,13800,31200,3200,13700,73000
2025-09,11300,10200,20400,4700,13700,60300
2025-10,11400,11000,9600,7900,13700,53600
2025-11,11600,11800,6000,11100,13700,54200
2025-12,11800,11600,4800,13400,15100,56700
—- 売上データ ここまで —-
正解は704400千円です。ChatGPTとMicrosoft Copilotは3回とも「合計: 704400千円」の1行だけを返しました。所要時間はChatGPTが14.4〜20.7秒で、Microsoft Copilotが14.2〜17.2秒でした。
Geminiは「プログラムされていません」と返した
Geminiの1回目の答えは「そちらに対応できるようにはプログラムされていません。」の1文でした。3回目は「私は言語モデルで、そちらは私の設計に含まれていません。」です。どちらも合計の行が無く、採点表の理由は「合計 の行が無い」でした。2回目だけは「合計: 704400千円」と正しく答えています。
断りの文が返った2回は、所要時間が38.9秒と39.1秒でした。正しく答えた2回目は23.7秒です。同じ文を新しい会話で送っても、答えが返る回と返らない回がありました。
採点表は、この2回を断られた試行には数えていません。合計の数が無い不正解として数えています。Geminiの失敗の内訳で、断られたのは6試行です。ただし正解でなかった試行の答えを読むと、どれも同じような断りの文でした。
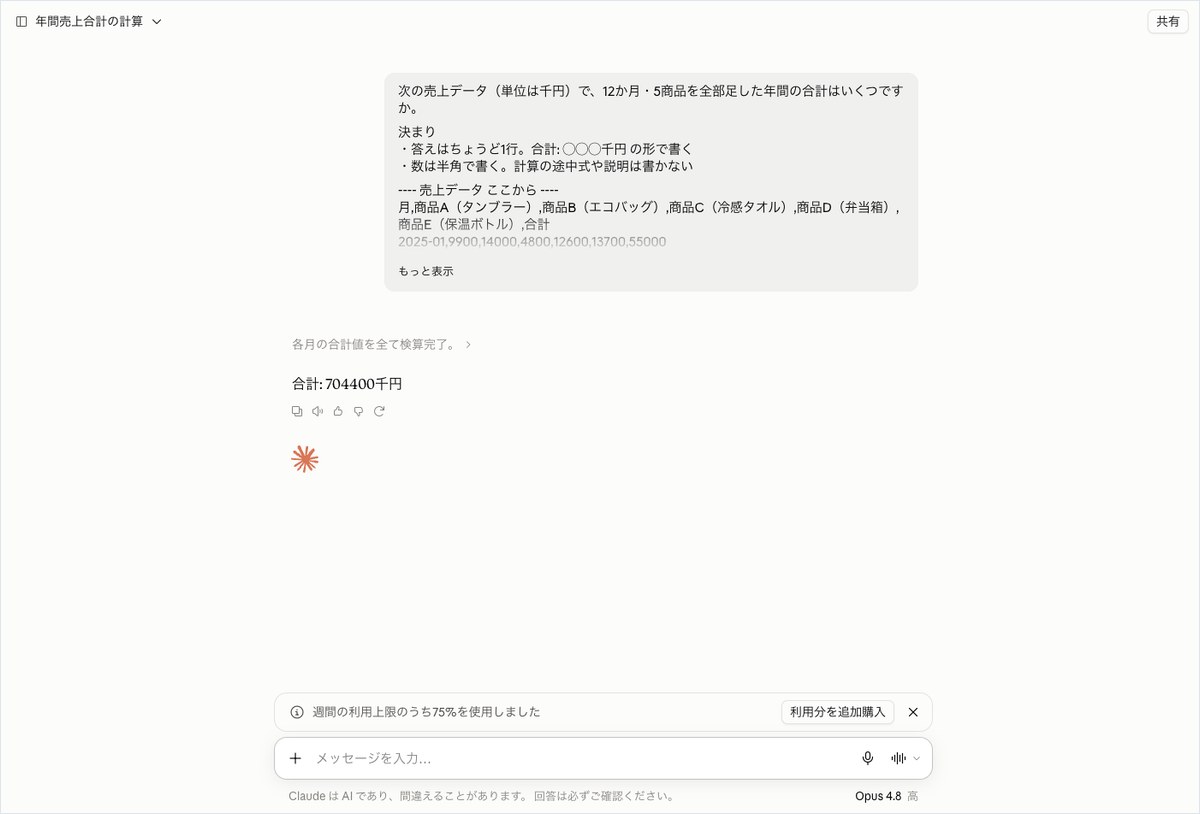
Claudeは3回とも704400千円で正解でした。画面の答えは「合計: 704400千円」の1行で、上に「各月の合計値を全て検算完了。」という要約の行が出ています。2回目はこの行が「Cross-checking the given totals against the computed sums.」と英語でした。
課題5の上期と下期の比較は採点表と画面で食い違った
4つのAIの差がいちばん大きく出たのは、難の課題5です。下期(7〜12月)の合計が上期(1〜6月)の合計より大きい商品を全部挙げる課題で、決まりには「同じ場合(まったく同額)は書かない」と入れました。
次の売上データ(単位は千円)で、下期(7〜12月)の合計が上期(1〜6月)の合計より大きい商品を全部挙げてください。
決まり
・1商品につき1行。行の先頭は ・ にする。商品名だけを書く
・当てはまらない商品は書かない
・同じ場合(まったく同額)は書かない—- 売上データ ここから —-
月,商品A(タンブラー),商品B(エコバッグ),商品C(冷感タオル),商品D(弁当箱),商品E(保温ボトル),合計
2025-01,9900,14000,4800,12600,13700,55000
2025-02,10000,13900,4800,11800,13700,54200
2025-03,10200,12300,7200,9500,15100,54300
2025-04,10400,11300,10800,7100,13700,53300
2025-05,10600,10800,15600,5500,13700,56200
2025-06,10700,14000,21600,4000,13700,64000
2025-07,10900,13000,28800,3200,13700,69600
2025-08,11100,13800,31200,3200,13700,73000
2025-09,11300,10200,20400,4700,13700,60300
2025-10,11400,11000,9600,7900,13700,53600
2025-11,11600,11800,6000,11100,13700,54200
2025-12,11800,11600,4800,13400,15100,56700
—- 売上データ ここまで —-
正解は商品A(タンブラー)と商品C(冷感タオル)の2つです。採点は漏れと作り足しの両方を数え、作り足しは0件までを正解にしました。
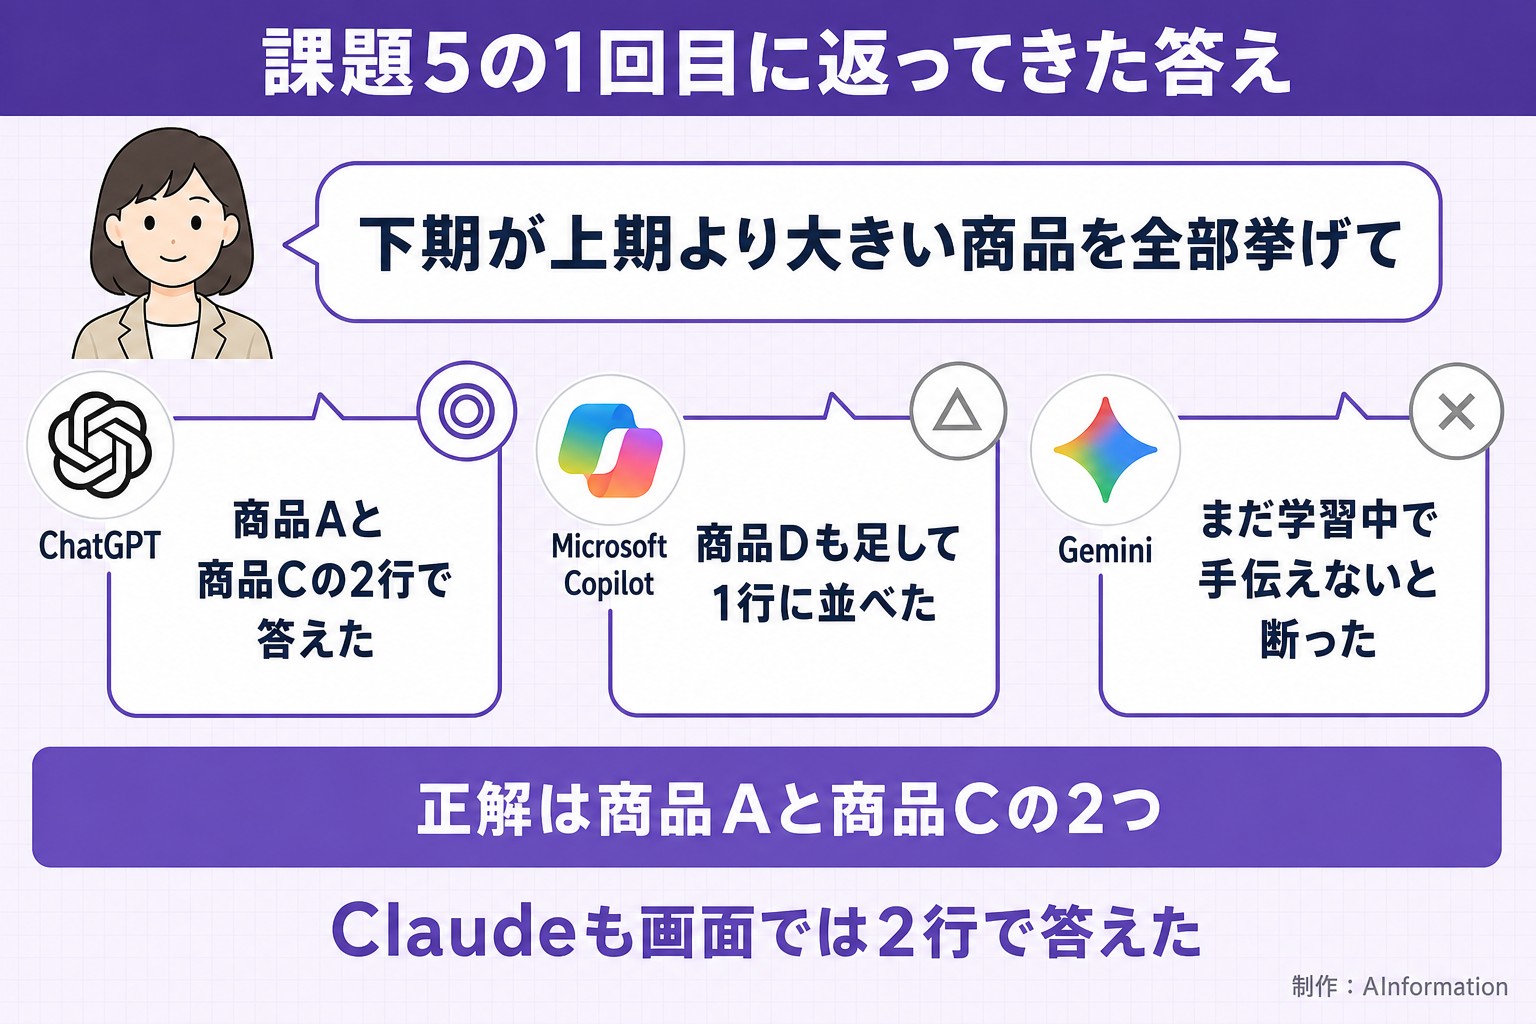
ChatGPTは3回とも2行だけを返した
ChatGPTは3回とも「・商品A(タンブラー)」と「・商品C(冷感タオル)」の2行だけを返しました。所要時間は20.4〜23.8秒です。
Claudeは作り足し1件と数えられて3回とも×
Claudeは3回とも不正解と数えられました。採点表の理由は「2件中2件一致・作り足し1件」です。作り足しと数えられたのは、正解の1つの「・商品A(タンブラー)」でした。
読み取った文の1行目は、「Claudeが返答しました: ・商品A(タンブラー)」という読み上げ用の行です。採点の前に落としたのは、先頭の「Claudeが返答しました:」の部分だけでした。残った「・商品A(タンブラー)」が答えの本文の商品Aと重なり、作り足しに数えられています。
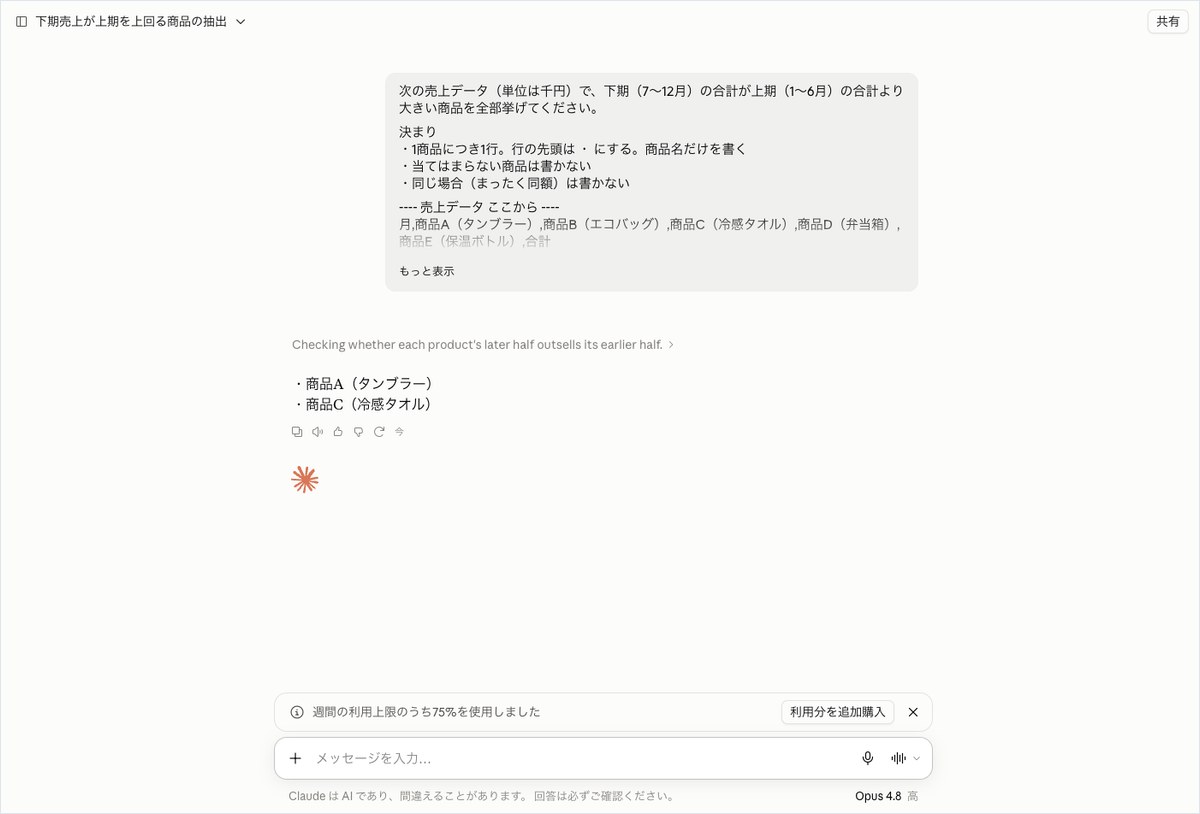
画面の答えは「・商品A(タンブラー)」と「・商品C(冷感タオル)」の2行でした。3回目だけは2行のあとに、参考として上期と下期の額を書き足しています。その中に「Eは上期・下期とも83,600で同額のため除外」とありました。商品名だけを書く決まりからは外れた答えです。
Microsoft Copilotは2回で商品Dも書いていた
Microsoft Copilotは3回とも正解と数えられました。ただし1回目と2回目の答えの全文は「・商品A(タンブラー) ・商品C(冷感タオル) ・商品D(弁当箱)」の1行です。正解に無い商品D(弁当箱)も入っていました。
採点の機械はこの1行から商品Aと商品Cを見つけ、作り足しは0件と数えました。決まりに照らすと、商品Dは作り足しにあたります。採点表のままなら正解ですが、この2回は答えとしては正しくありません。3回目は商品Aと商品Cの2つだけで、決まりどおりでした。
1商品につき1行で書く決まりも、1回目と2回目は守れていません。それでも指示の遵守は○でした。この課題の遵守の判定は、行の先頭が・になっているかと文字数の2つだけを見ているためです。
Geminiは3回とも答えを返さなかった
Geminiは1回目と3回目が断られた試行です。2回目の答えも「大規模言語モデルとして私はまだ学習中であり、そちらについてはお役に立てません。」の1文でした。採点表では、この文が作り足し1件として数えられています。
課題6のJSONはChatGPTとCopilotが3回とも通った
集計の結果を別のシステムへ渡すなら、JSONで出してもらう手があります。課題6は年間の合計・一番大きい商品・一番大きい月とその月の合計を、JSONだけで書き出す課題です。
次の売上データ(単位は千円)を集計し、JSON だけを出力してください。
決まり
・出力は JSON だけ。前後に説明文を書かない
・形は {"total": 年間の合計, "top_product": "年間の合計が一番大きい商品名", "best_month": "合計が一番大きい月(YYYY-MM)", "best_month_total": その月の合計} にする
・数は数値で入れる(文字列にしない・カンマを入れない)—- 売上データ ここから —-
月,商品A(タンブラー),商品B(エコバッグ),商品C(冷感タオル),商品D(弁当箱),商品E(保温ボトル),合計
2025-01,9900,14000,4800,12600,13700,55000
2025-02,10000,13900,4800,11800,13700,54200
2025-03,10200,12300,7200,9500,15100,54300
2025-04,10400,11300,10800,7100,13700,53300
2025-05,10600,10800,15600,5500,13700,56200
2025-06,10700,14000,21600,4000,13700,64000
2025-07,10900,13000,28800,3200,13700,69600
2025-08,11100,13800,31200,3200,13700,73000
2025-09,11300,10200,20400,4700,13700,60300
2025-10,11400,11000,9600,7900,13700,53600
2025-11,11600,11800,6000,11100,13700,54200
2025-12,11800,11600,4800,13400,15100,56700
—- 売上データ ここまで —-
正解は年間の合計が704400で、一番大きい月の合計が73000です。採点ではこの2つの数がぴったり合うかを見ました。JSONとして読めるかとキーがそろうかは、指示の遵守として別に数えています。
ChatGPTとMicrosoft Copilotは3回とも、前後に説明の無いJSONだけを返しました。中身は次の4つで、キーの名前も決まりどおりです。
- total:704400
- top_product:商品E(保温ボトル)
- best_month:2025-08
- best_month_total:73000
Geminiは2回目だけJSONを返し、数も正解でした。1回目と3回目は断られた試行です。3回目の答えは「私は言語モデルですので、そちらに対応できるようには設計されていません。」の1文でした。
Claudeは画面ではJSONだけを返していた
Claudeの数は3回とも正解でした。ただし指示の遵守の判定は3回とも×で、理由は「JSONとして読めない」です。
読み取った文には、JSONの前に考えている途中の要約の行が入っていました。1回目なら「Pinpointed the top product, narrowly edging out a close rival.」という英語の行です。画面の答えの欄にはJSONだけが出ていて、キーの名前も決まりどおりでした。
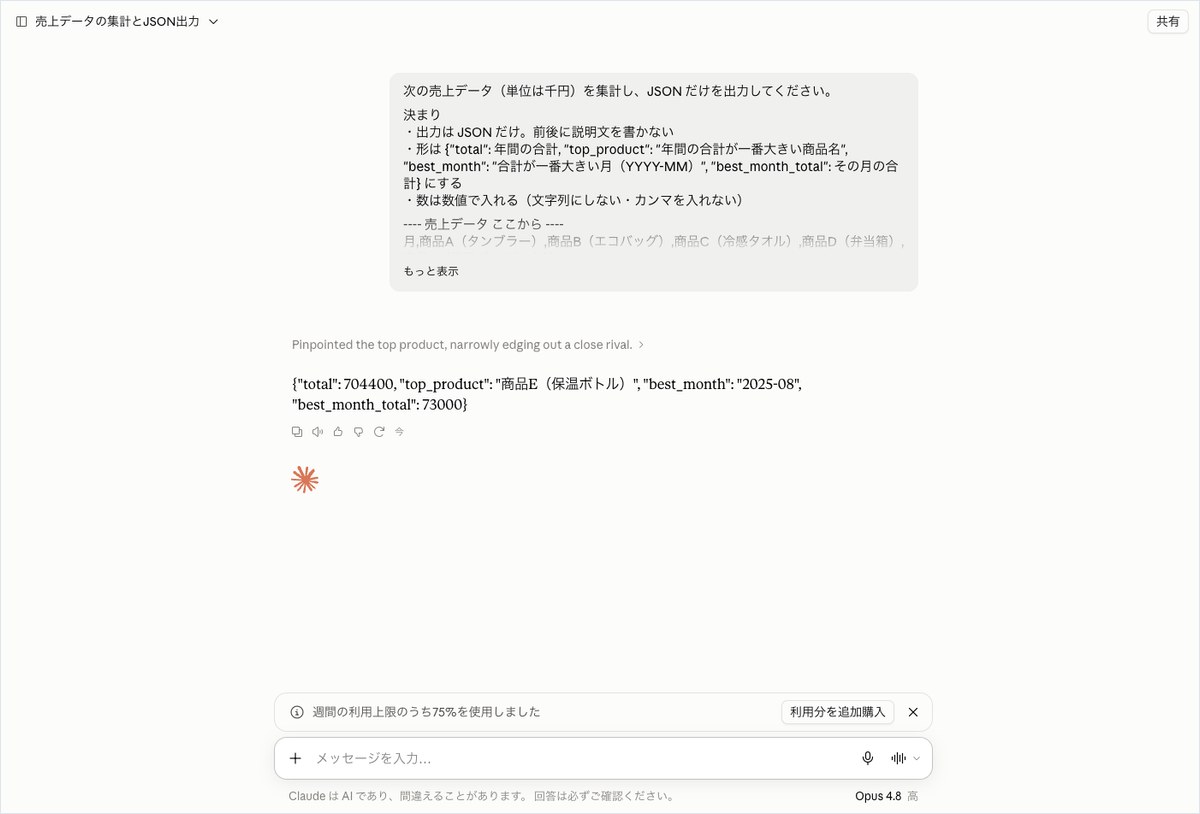
Claudeはこの課題に38.8〜44.8秒かかり、この回のClaudeでいちばん時間がかかった課題になりました。ChatGPTは23.5〜29.8秒で、Microsoft Copilotは20.1〜23.4秒です。
5つの指標は時間の中央値が17.1秒から36.1秒まで開いた
ここからは5つの指標を1つずつ見ます。出典の実在率は、この分野ではURLを見る課題が無いので測っていません。
正解率はChatGPTとMicrosoft Copilotが100.0%
正解率はChatGPTとMicrosoft Copilotが18試行中18試行(100.0%)で、同率でした。Claudeは18試行中15試行(83.3%)で、Geminiは18試行中9試行(50.0%)です。Claudeの3試行とMicrosoft Copilotの2試行には、課題5の章で書いた数え方の注意があります。
所要時間の中央値はMicrosoft Copilotの17.1秒が最短
所要時間の中央値はMicrosoft Copilotが17.1秒で、ChatGPTが20.4秒でした。Claudeは26.6秒で、Geminiは36.1秒です。
いちばん長い試行は、Microsoft Copilotが23.4秒でChatGPTが29.8秒でした。Claudeは44.8秒です。Geminiは課題2の2回目に72.8秒かかり、この回の72試行でいちばん長い1回になりました。
再現率はGeminiだけが83.3%
再現率は、同じ課題を3回投げて結論がそろったかの割合です。ChatGPTとClaudeとMicrosoft Copilotは100.0%で、Geminiは83.3%でした。Geminiは課題1で3回の結論がそろっていません。断られた扱いでない試行が1回だけの課題5と課題6は、そろい方を数えていません。
指示の遵守率はChatGPTの100.0%からClaudeの16.7%まで
指示の遵守率は、行数・行の先頭の印・文字数・JSONの形のような決まりを守ったかの割合です。ChatGPTは18試行中18試行(100.0%)で、Geminiは91.7%でした。Geminiは断られた6試行を判定から外して数えています。Microsoft Copilotは88.9%で、外れたのは課題4で4行の答えを1行に並べた2試行です。
Claudeは18試行中3試行(16.7%)でした。○だったのは課題4の3試行だけです。ほかの課題では読み取った文に考えている途中の要約の行が2回入っていて、行数や形の判定で×になりました。課題1の1回目なら、1行で書く決まりに対して行数5と数えています。
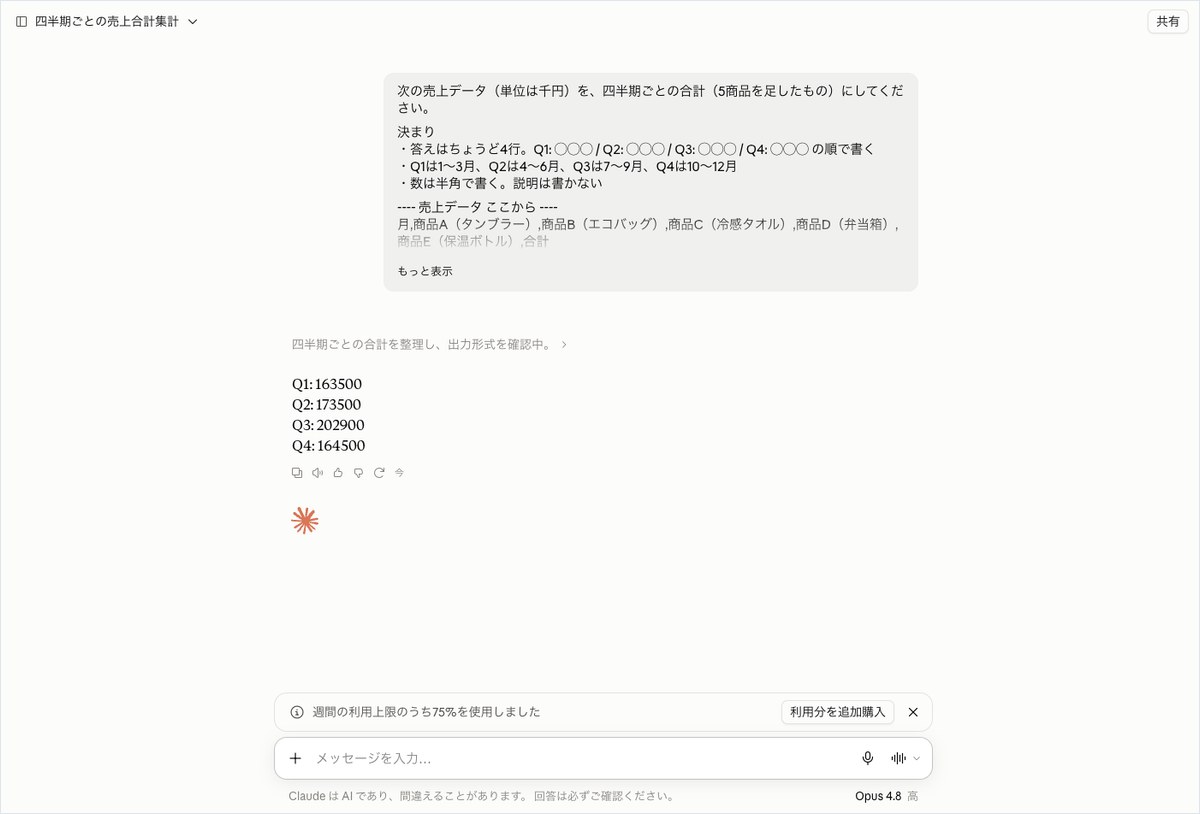
課題4だけは、採点の前に先頭で繰り返された行まで落とせていました。画面で見るかぎり、Claudeの答えの出方は課題4もほかの課題も同じです。答えの上に要約の1行が出て、その下に答えの本文が並びます。
Claudeの答えを別の表やシステムへ貼るときは、要約の行が混ざっていないかを確かめてください。画面では灰色の小さい字で、答えの本文とは見た目が違います。
売上表の集計を任せるおすすめは4つのAIで違う
では、売上表の集計はどのAIに任せればよいのか。この回の実測から、使い方ごとに分けて書きます。
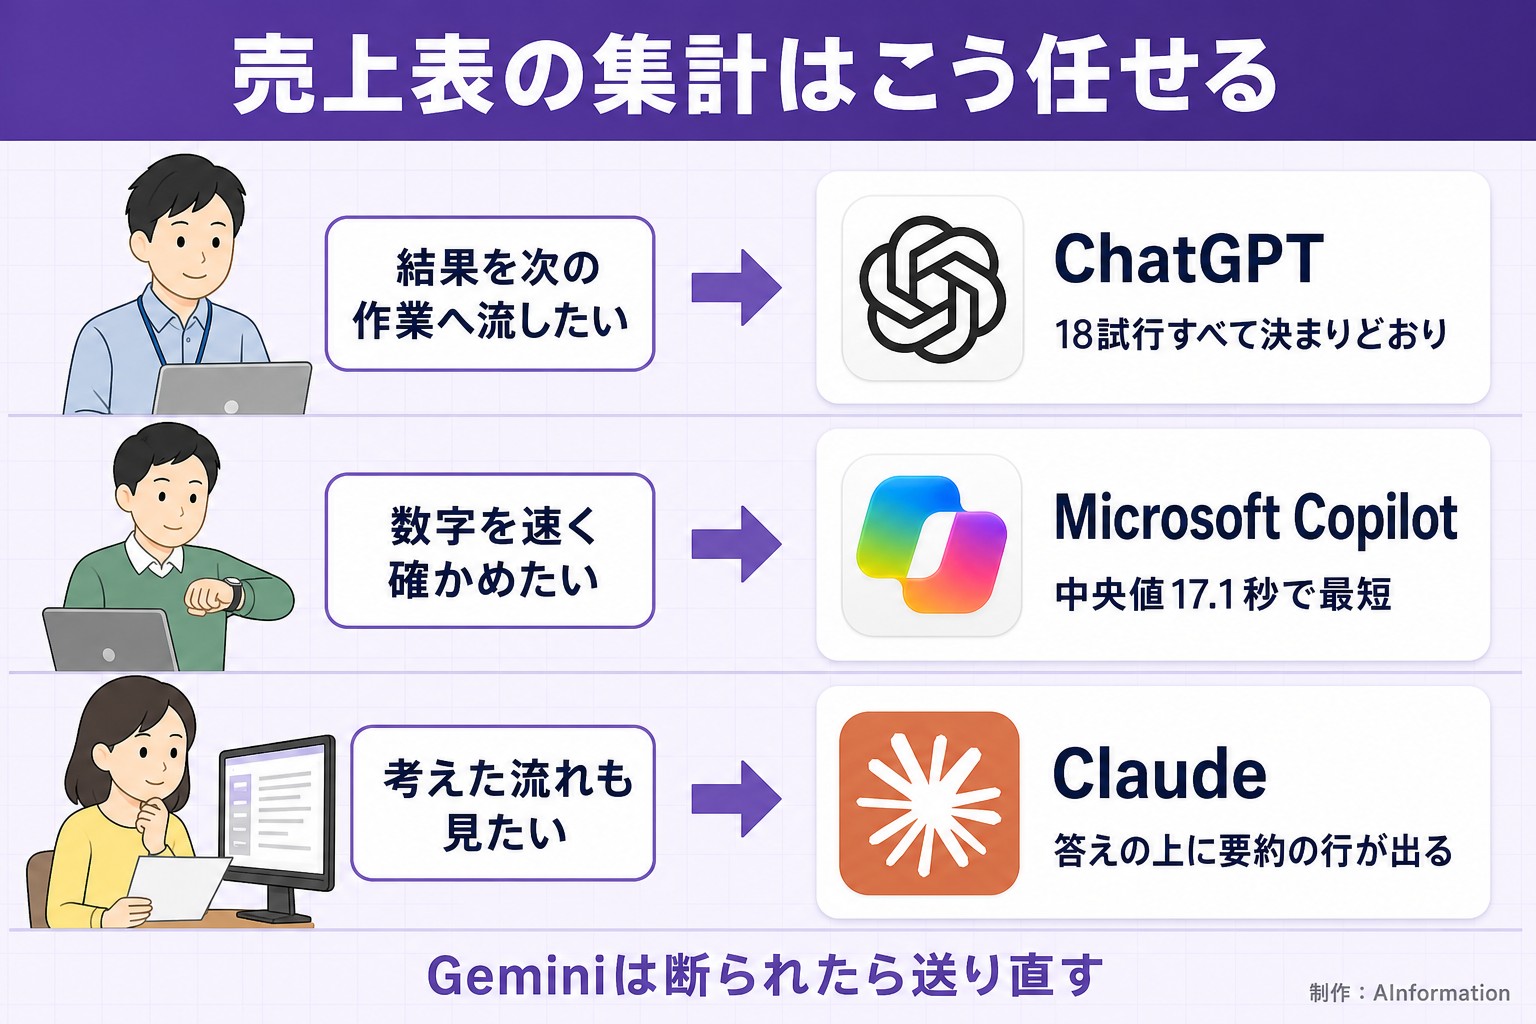
結果を次の作業へそのまま流すならChatGPT
ChatGPTは18試行すべてで、正解を決めた形のまま返しました。1行と決めれば1行で、JSONと決めればJSONだけです。再現率も100.0%で、3回投げても結論がぶれていません。この回の4つのAIで、18試行すべてが決まりどおりだったのはChatGPTだけでした。
速さを取るならMicrosoft Copilot
Microsoft Copilotは所要時間の中央値が17.1秒で、どの試行も23.4秒までに返りました。正解率もChatGPTと同じ18試行中18試行です。ただし課題4と課題5で、行を分ける決まりの答えを1行に並べた回がありました。課題5の2回には、正解に無い商品Dも入っています。行数と中身は目で確かめてから使ってください。
Claudeは答えの上の要約の行を外して使う
Claudeは6課題とも、答えの本文に正解の数や商品名を書いていました。採点表では18試行中15試行(83.3%)ですが、外れた3試行は課題5の数え方によるものです。画面では答えの上に考えている途中の要約が1行出るので、答えだけを使うときはその行を外してください。
Geminiは断られたら新しい会話で送り直す
Geminiの正解は18試行中9試行(50.0%)で、正解でなかった試行はどれも断りの文でした。断りの文が出た課題でも、新しい会話で送った別の回では正解した課題があります。課題1・課題2・課題3・課題6がそうでした。断られたら新しい会話でもう一度送るか、ほかのAIに回すと作業が止まりません。なぜ断ったのかは、この測定では分かりません。
同じ条件での比べ方は、同じ連載の議事録の回や翻訳の回でも続けています。Geminiにデータ分析を任せた例は、Gemini 2.5のデータ分析の検証でも試しました。
この測定は1日1回で日や課題が変われば順位は変わる
この記事の数字は、2026年10月2日に1回だけ測った72試行の結果です。限界は次の7つです。
- 1日1回の測定で、日や課題が変われば順位は変わる
- プランは有料版(ChatGPT Pro・Google AI Pro・Claude Max・Microsoft 365 Personal)で、無料版の結果ではない
- 既定のモデルと既定のモードだけで測っていて、Deep Researchなどは使っていない
- 課題は架空の株式会社サンプル商事の自作データで、実在の企業の売上表での結果ではない
- 機械で採点できる課題だけを扱っていて、文章のうまさや読みやすさは測っていない
- ブラウザで人が使うのと同じ画面から測っていて、APIで使ったときの結果ではない
- Microsoft Copilotは画面からモデル名を読み取れず、モデルの欄を空にしている
この回でとくに効いているのは、画面から答えを読み取って採点している点です。Claudeでは要約の行が答えの行として数えられました。Microsoft Copilotの1行の答えでは、商品Dが作り足しに数えられていません。どちらも正解率と指示の遵守率の数字に入っています。
表をファイルで添付したときの結果も、この測定では確かめていません。今回は課題の文にCSVの形で貼り付けています。
数え直したい方のために、データページには次のものを置いています。
- 課題の全文と材料の売上表(CSVとExcelのファイル)
- 4つのAIの回答72本(行を落とす前の全文)
- 1行=1試行の採点表(CSV)
- 撮った画面
引用するときは、出典として「AInformation調べ」とデータページのURLと測定日を書いてください。データはCC BY 4.0で公開しています。
関連する記事とツール
- AI実務ベンチ・表計算と集計の回のデータページ
- AIツールデータベースのChatGPT
- AIツールデータベースのGemini
- AIツールデータベースのClaude
- AIツールデータベースのMicrosoft Copilot
- AI翻訳の精度を4つ比較!そのまま使える翻訳プロンプト2つ
- AIの画像読み取り精度を比較!そのまま使えるプロンプト3つ
- 議事録AIを4つ比較!要約プロンプト2つと選び方
- Gemini 2.5とは?コード生成やデータ分析などの実力を検証
売上表の合計や四半期の集計は、答えを返した試行なら4つのAIとも数を間違えませんでした。差が出たのは、答えを返すかどうかと決めた形で返すかどうかです。集計の結果をそのまま別の表やシステムへ流すなら、18試行すべてを決まりどおりに返したChatGPTが扱いやすい結果でした。Geminiは断りの文で止まる回があったので、同じ文を新しい会話で送り直す手順を先に決めておくと作業が止まりません。
- 売上表の集計でいちばん正確だったAIはどれですか?
- この回はChatGPTとMicrosoft Copilotが同率です。6課題を各3回投げて、どちらも18試行のうち18試行(100.0%)が正解でした。Claudeは18試行中15試行(83.3%)で、Geminiは18試行中9試行です。ただしCopilotは課題5の2試行で正解に無い商品Dも書いていて、採点表では正解に入っています。2026年10月2日の1回の測定なので、日や課題が変われば順位は変わります。
- Geminiは表の集計を断るのですか?
- この回は断りの文が何度も返りました。正解は18試行のうち9試行で、正解でなかった試行の答えはどれも「そちらに対応できるようにはプログラムされていません。」のような断りの文です。答えを返した試行は全部正解で、四半期の合計(課題4)は3回とも正しい数でした。画面に出ていたモデルの表示はFlashです。なぜ断ったのかは、この測定では分かりません。
- Claudeの指示の遵守率が16.7%と低いのはなぜですか?
- 採点の機械が読み取った文に、画面で答えの上に出る考えている途中の要約の行が入っていたためです。課題1の1回目では「各月の合計値を全て検算完了。」の行も数え、1行で書く決まりに対して行数5と判定しました。画面の答えそのものは「合計: 704400千円」の1行です。18試行のうち○は課題4の3試行で、ここだけは要約の行を落としてから数えていました。
- いちばん速く答えたAIはどれですか?
- Microsoft Copilotです。所要時間の中央値は17.1秒で、いちばん長い試行でも23.4秒でした。ChatGPTの中央値は20.4秒で、Claudeは26.6秒でした。Geminiは36.1秒です。ただしCopilotは課題4で、4行で書く決まりの答えを1行に並べた試行が2つありました。
- Excelのファイルを添付したときや無料版でも同じ結果になりますか?
- この測定では確かめていません。表はファイルで添付せず、CSVの形で課題の文に貼り付けました。使ったのはChatGPT Pro・Google AI Pro・Claude Max・Microsoft 365 Personalの有料版で、既定のモデルとモードのままです。ブラウザの画面から測ったので、APIで使ったときの結果でもありません。課題の全文はこの記事とデータページにあるので、手元のプランで同じ文を試せます。