Metaの商用規約が10月30日に変わる 関連サイトをAI学習に使える
Metaは商用利用規約を改め、10月30日から新しい版を有効にする。新しい規約では仕事でMetaの製品を使う人の商品やサービスに関連するサイトを、Metaがクローラーなどで取得できるとした。取得した中身は製品の開発や改善のほか、AIの「トレーニング」にも使えると書いている。
米メディアのNieman Labが法律の専門家に取材して報じ、The Vergeも10月16日に続いた。専門家は、この規約を根拠にMetaがrobots.txtの指示より規約が優先すると主張できる余地があるとみる。米コーネル大学のジェームズ・グリメルマン教授は、ニュースサイトにとってはAIの学習を許したのと同じだと話す。
Meta側は否定している。広報のダニエル・ロバーツ氏は「クローラーの使い方は何も変わらない」と述べ、サイトの持ち主は今もrobots.txtで意思を示せると説明した。広報担当副社長のアンディ・ストーン氏もXで、ニュースサイトを狙った変更ではなく販売中の商品の情報を正しく取るための更新だと書いている。
- 10/16The Vergeが新しい商用規約への懸念を報じる
- 10/17日本語版の規約にも同じ条文があると確認
- 10/30新しい商用利用規約が発効
日本語版にも同じ条文 Instagramを仕事で使う会社が対象
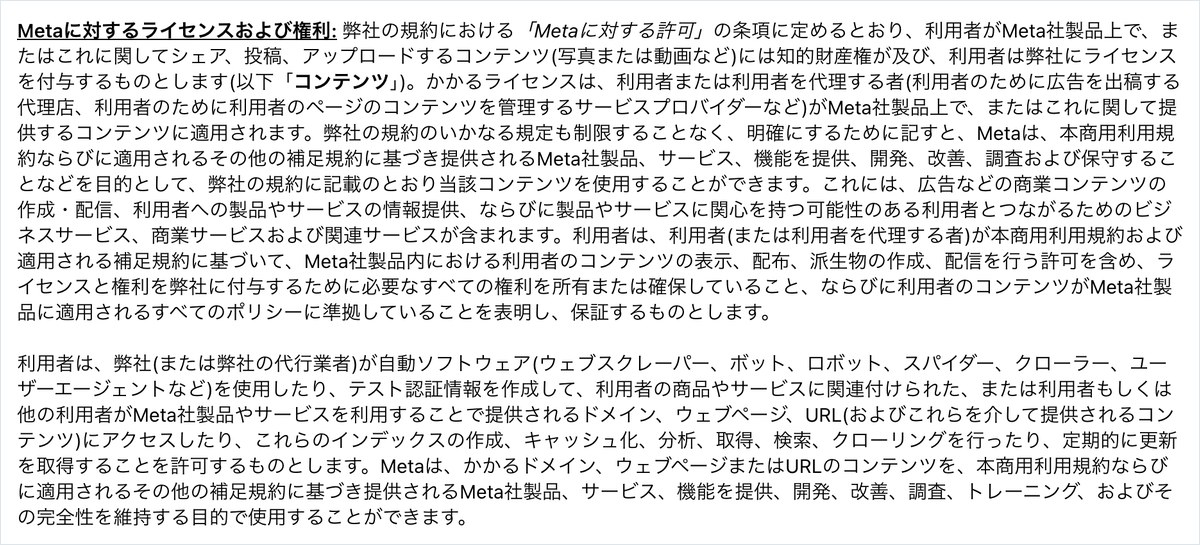
AInformationが10月17日にMetaの規約ページを日本語で開くと、更新後の版にも同じ条文が入っていた。Metaは「ウェブスクレーパー」やクローラーなどの自動ソフトでドメインやウェブページを取得できるとし、その中身を「トレーニング」に使えるとしている。発効日は2026年10月30日と書かれていた。
対象は事業や商用の目的でMetaの製品を使う人だ。日本語版は例として広告の出稿や商品の販売、ページやグループの管理を挙げている。広告マネージャやMeta Business Suiteを使う会社も入るので、Instagramで自社の発信をしている会社はほぼ当てはまる。
一方で、規約の本文にrobots.txtという語は日本語版にも英語版にも出てこなかった。robots.txtで断れるという説明は規約ではなく、開発者向けの別のページに書かれている。MetaはCNNやUSA TodayなどとAIのライセンス契約を結んできたが、この規約はそれより広い範囲に届く可能性がある。
国内24サイトのrobots.txt AI学習用を断るのは15サイト
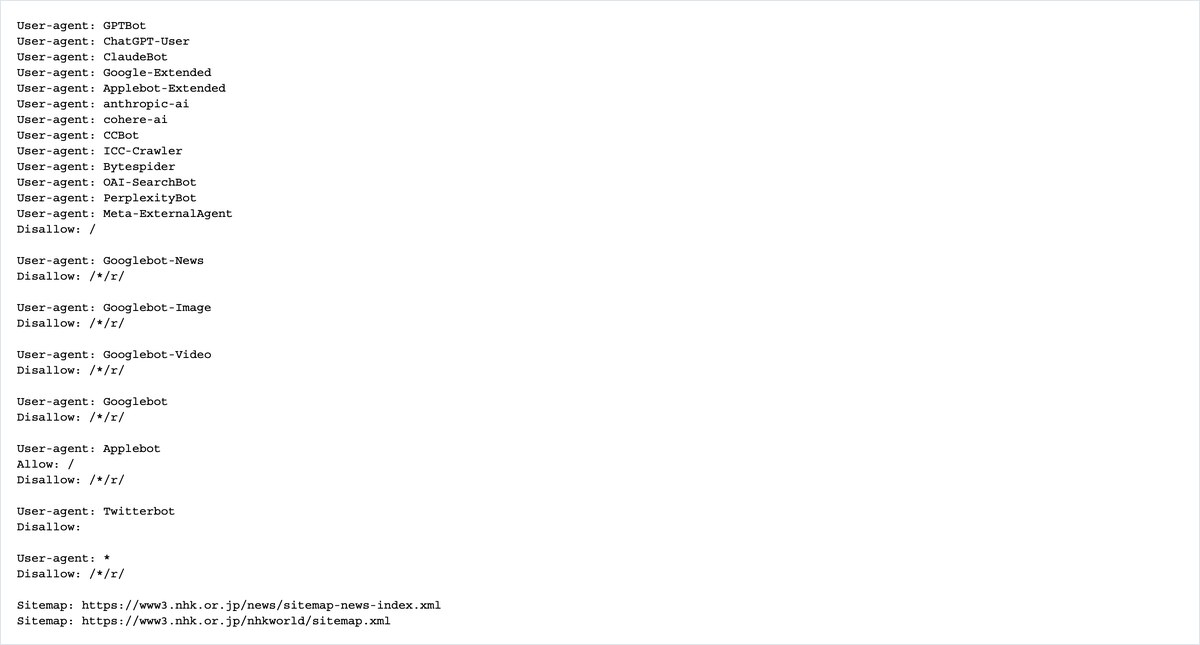
Metaは開発者向けページで、よく使う5種類のクローラーの名前と用途を公開している。基盤AIモデルのトレーニングに使うのはMeta-ExternalAgentで、広告などビジネス向けの改善にはMeta-ExternalAdsを使う。利用者の頼みで取りに行くMeta-ExternalFetcherは、robots.txtを無視する場合があると書かれている。
AInformationは10月17日に、国内の報道とIT・ビジネス系の24サイトのrobots.txtを読んだ。AI学習用のMeta-ExternalAgentを名指しで断っていたのは15サイトだった。広告用のMeta-ExternalAdsを断るサイトは1つも無かった。
| 区分 | 調べた数 | Meta-ExternalAgentを断る | Meta-ExternalAdsを断る |
|---|---|---|---|
| 新聞・通信・放送・ポータル | 14 | 13 | 0 |
| IT・ビジネス系メディア | 10 | 2 | 0 |
| 合計 | 24 | 15 | 0 |
新聞やNHK、Yahoo!ニュースなどは14サイト中13が断っていた。IT・ビジネス系で断っていたのはCNET JapanとBusiness Insider Japanの2つだけだった。新聞社がFacebookやInstagramで記事を宣伝していれば、規約とrobots.txtのどちらが効くかで扱いが変わる。
調べたのは全国紙5紙・地方紙4紙・通信社2社・NHK・Yahoo!ニュース・日刊スポーツの14サイトと、ITやビジネスを扱うWebメディア10サイト。各サイトのrobots.txtを10月17日に読んだ。
10月30日までに見る3点 robots.txtの反映は最大24時間
InstagramやFacebookを仕事で使い、自社サイトも持つ会社は次の3点を確かめておきたい。
- 広告の出稿やページの管理など、事業の目的でMetaの製品を使っているか
- 自社サイトのrobots.txtにMeta-ExternalAgentを断る行があるか
- 学習に使われたくない資料や会員向けのページが、誰でも開ける場所に置かれていないか
Metaの開発者向けページによると、robots.txtを書き換えてから効くまで最大24時間かかる。ただし規約がrobots.txtより優先するかは決着していない。ChatGPTやGeminiの学習させない設定は自分が入力した会話を守るもので、サイトの中身を取られる話とは別だと考えておきたい。
次の焦点は、10月30日までにMetaが規約の書き方を改めるかどうかだ。
企業の導入支援で多いのは、Instagramは広報が動かしサイトは情報システム部門が持つ形だ。規約に同意するのはSNSの担当者で、robots.txtを書き換えるのはサイトの管理者になる。ここが別々だと、サイトではAI学習を断っているのにSNSの規約では許していたという食い違いが起きる可能性がある。10月30日までに広報と情シスでMetaの規約と自社のrobots.txtを並べて見ておきたい。学習を断る方針を決めている会社ほど、この確認が要るとみている。
- Metaの新しい商用規約は日本の会社にも関係ある?
- 関係する。AInformationが10月17日に日本語版の更新後の規約を開くと、クローラーでサイトを取得してトレーニングに使えるとする条文が英語版と同じく入っていた。発効日は2026年10月30日だ。対象は広告の出稿やページの管理、Meta Business Suiteの利用など事業の目的でMetaの製品を使う人になる。
- robots.txtでMetaのAI学習を断れる?
- Metaは断れると説明している。開発者向けページでは基盤AIモデルのトレーニングに使うクローラーをMeta-ExternalAgentとし、robots.txtで禁止できるとしている。ただし規約の本文にrobots.txtの語は無い。法律の専門家は規約がrobots.txtより優先すると主張される余地を指摘している。書き換えてから効くまで最大24時間かかる。
- 国内のニュースサイトはMetaのクローラーを断っている?
- AI学習用は半分を超えるサイトが断っている。AInformationが10月17日に24サイトのrobots.txtを読むと、Meta-ExternalAgentを断っていたのは15サイトだった。新聞・通信・放送などは14サイト中13が断り、IT・ビジネス系は10サイト中2だけだった。広告用のMeta-ExternalAdsを断るサイトは0だった。
この記事の出典
補助資料
- [1]The Vergeこの記事の元にした報道
出典の最終確認日:2026年10月17日