11月10日の修正版で到達と判断 前の版の一文は消えた
Anthropicは11月10日に出した上場の届け出(S-1)の修正版で、社内の安全方針の基準に届いたと判断しました。基準の名前は「AI研究開発の能力のしきい値」です。
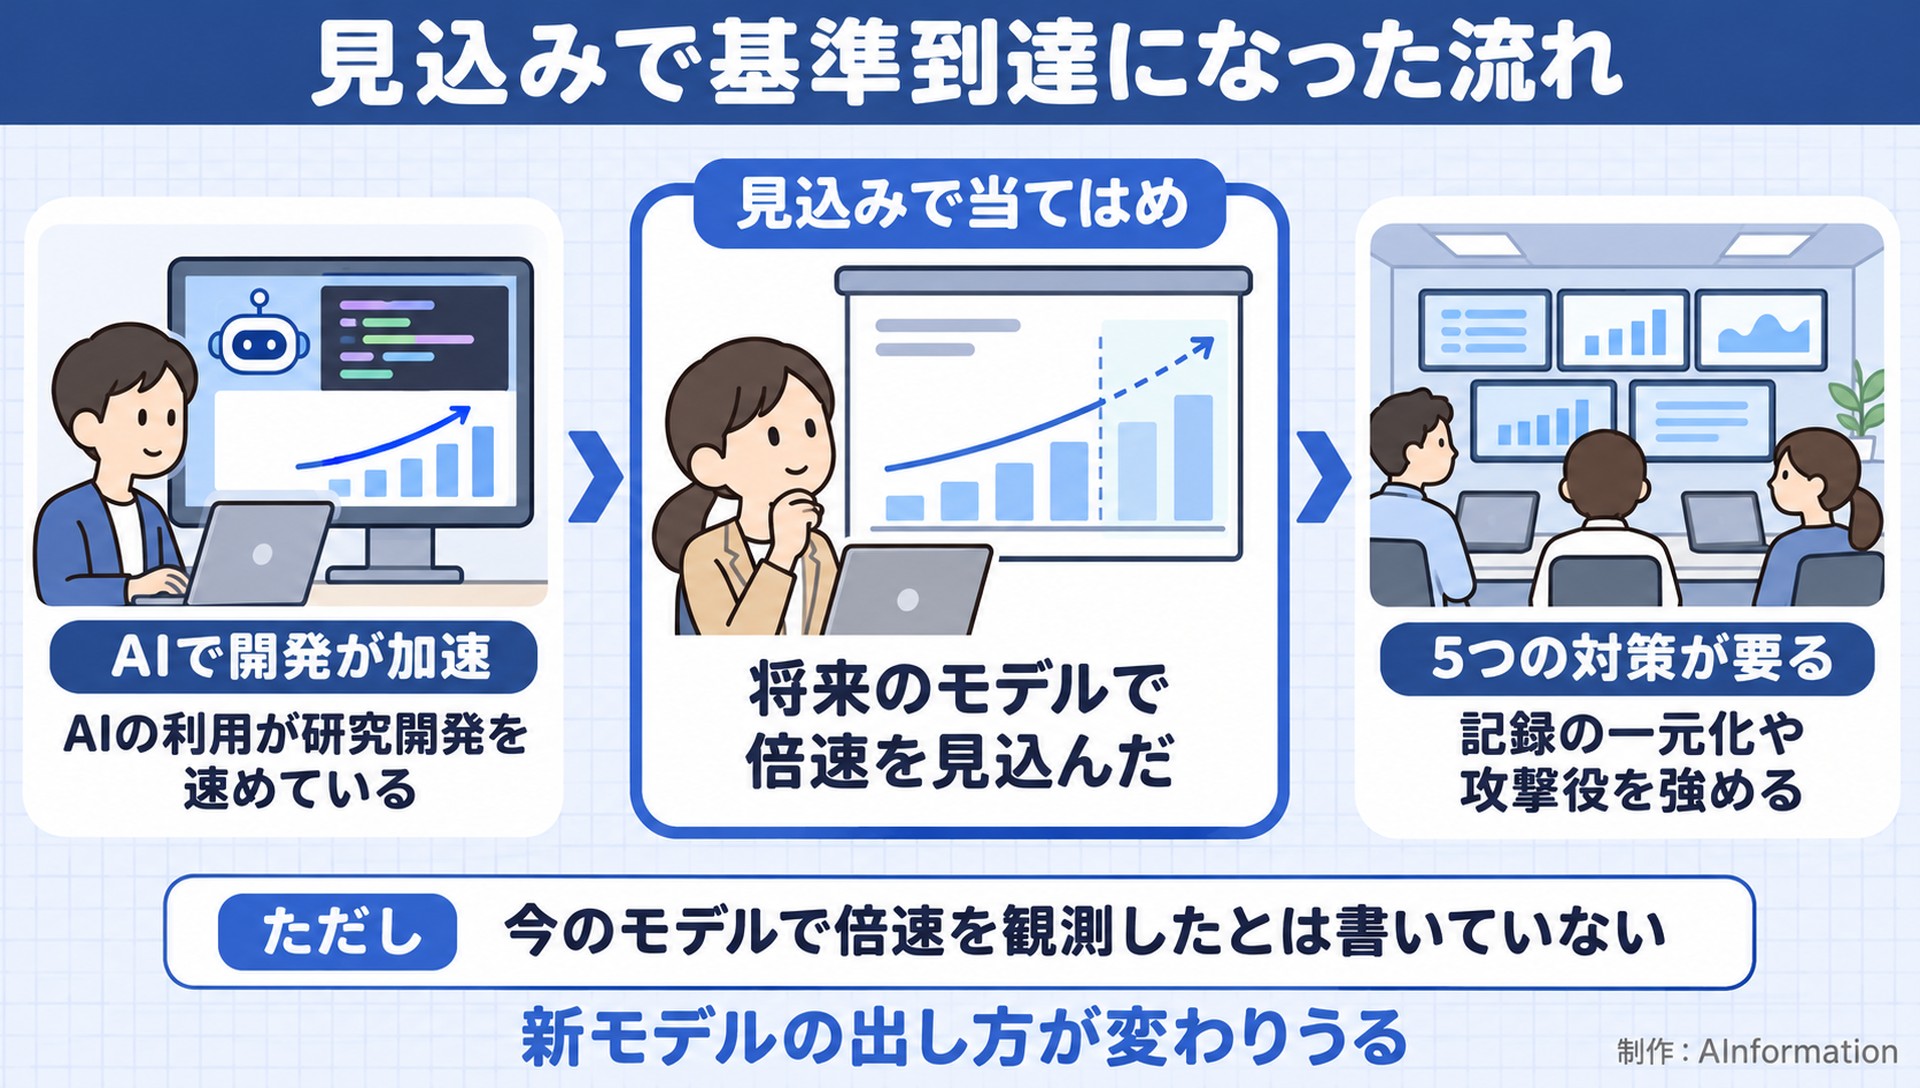
判断のもとは、今のモデルで観測したことではありません。将来のモデルに見込むことと全体の進み方をもとに決めたと書いています。
AInformationは11月16日、SECの公開データベースから11月2日版と11月10日版を取りました。同じ段落を突き合わせると、違いは次のとおりです。
| 項目 | 11月2日版 | 11月10日版 |
|---|---|---|
| 基準との距離 | まもなく届く可能性がある | 届いたと判断した |
| 今のモデル | 基準を超えたモデルは無いと明記 | その一文が消えた |
| 判断のもと | 社内の見積もりと将来のモデルの見込み | 将来のモデルの見込みと全体の進み方 |
| 今後の報告 | RSPに沿って出す | 今後出す(RSPに沿っての文言は消えた) |
消えたのは「今のモデルで基準を超えたものは無い」という一文です。8日のあいだに、まもなく届くという書き方が届いたという判断に変わりました。
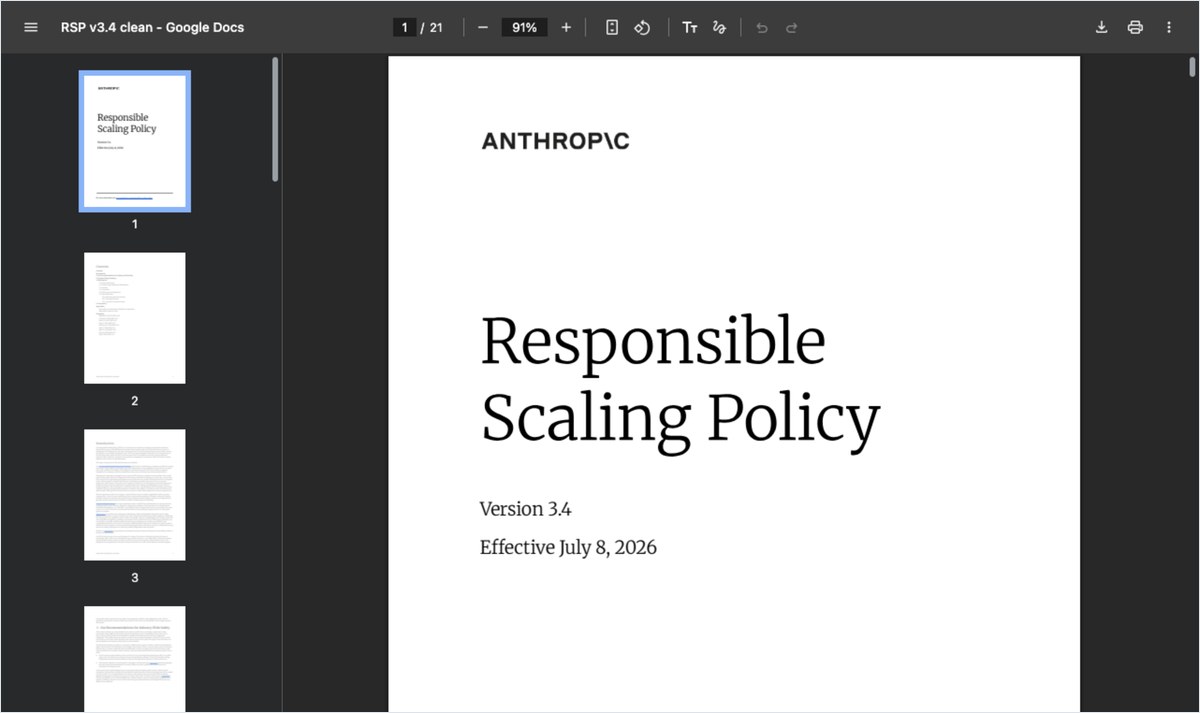
- 7/8RSPの第3.4版が効力を持つ
- 11/2S-1の修正版で基準にまもなく届く可能性と記載
- 11/10S-1の再修正版で基準に届いたと判断
RSPの基準は1年で2年分の進歩 当てはめたのは見込みのほう
基準の中身は、Anthropicの責任あるスケーリング方針(RSP)に書いてあります。7月8日から効いている第3.4版では、届いたとみなす条件は次の2つのどちらかです。
- Anthropicの研究者と研究エンジニアの全員を、AIが5倍以内の費用で置き換えられる
- 研究の自動化が理由で、AIの進歩の速さが2倍になると観測するか見込む
2倍とは、ふだんなら2年かかる進歩を1年で遂げることです。届け出が使った「観測するか見込む」という言い方は、RSPのPDFでは2つ目の条件にだけ出てくる言葉です。
Gizmodoも同じ所を指しています。再帰的自己改善が起きたわけではなく、見込みで判断を改めたものだと伝えています。
基準を超えたら求められる5つの対策
RSPは、基準を超えたときに会社として次の5つをやると決めています。
- 世界でいちばん手ごわい攻撃者にも耐える、これまでに無い水準の守りを研究する
- 社内のAI開発の記録を全部集め、人とAIの不審な動きをAIで調べる
- 解釈可能性の研究とレッドチームを使い、Claudeの振る舞いを体系的に調べる
- 社内の攻撃役を、バグ報奨金の参加者全体より脱獄を見つけられる水準にする
- 上の4つの進み具合を、外部の専門家の見直しを受けたリスク報告で出す
Claudeの新モデルは遅れうる Mythosは公開を絞った前例
使う側に関わるのは、新しいモデルの出し方です。届け出によると、過去の安全対策には公開の延期と最初の提供先の限定がありました。例はProject Glasswingを通したMythosです。
今後の対策は、モデルを作るか・どう出すか・いつ出すかに及ぶ可能性があると書いています。いつ何をどれだけの期間やるかは、前もって予測できないとしています。
日本でClaudeを業務に入れている会社は、新しいモデルが決まった時期に出る前提で予定を組まないほうがよさそうです。社内ツールの移行日は、次のモデルの公開日に合わせて決めないでおくと安心です。
創業者の手紙も、AIが自らを作って能力が速く伸びる場合はその速さを抑える必要があるかもしれないと書いています。
どのモデルかは書かれていない 次の報告で確かめる3点
11月10日版を読んでも、どのモデルを指すのかは出てきません。判断した日付も、進歩が何倍になったかの数字もありません。次の報告は「今後出す」とあるだけです。
- 次の報告で、どのモデルを基準に当てはめたか
- 5つの対策のうち、新しいモデルの公開を遅らせるものがあるか
- 新しいモデルの最初の提供先が、一部の会社に絞られるか
Gizmodoによると、Anthropicの株の売買は木曜に始まる見込みです。上場のあとに出る報告で、見込みの中身がどこまで明かされるかが次の焦点になります。
- 再帰的自己改善
- AIが自分で自分の能力を高め、その改良がさらに改良を速めていく理論上の段階。Gizmodoは今回これが起きたわけではないと伝えている
- RSP
- Anthropicの責任あるスケーリング方針。AIの能力が決まった段階に届いたら、それに合わせて安全対策を強めると定めている
※記事の事実とは分けて、筆者の考えを書いています。
分析・考察見込みの段階で基準を超えたと言い切ったのは、上場を前にした慎重さの表れとみています。基準を超えると対策が要るので、新しいモデルの出し方を縛る約束を投資家の前でしたことになります。
困るのは、Claudeの次のモデルを前提に開発や移行の予定を組んでいる会社です。情報システム部門は、次のモデルが遅れても今のモデルで回る計画にしておくと公開の延期に振り回されずに済みそうです。
- Anthropicの基準到達で今のClaudeは使えなくなる?
- 11月10日版のしきい値の段落に、今のClaudeを止めるという話は出てきません。判断と並べて挙げた対策の例は、新しいモデルの公開の延期と最初の提供先の限定です。過去にはProject Glasswingを通したMythosがその例でした。ただ届け出は一般の危険として、出したモデルを引っ込めたり直したりする可能性も挙げています。
- Anthropicで再帰的自己改善はもう始まった?
- 始まったとは書いていません。Gizmodoは、急な技術の進歩ではなく見込みで判断を改めたものだと伝えています。届け出も、今のモデルの観測ではなく将来のモデルの見込みで決めたとしています。再帰的自己改善は、AIが自分で自分を良くしていく理論上の段階を指します。
- 基準を超えたAnthropicは何をする?
- RSPの第3.4版は、基準を超えたときの対策を5つ決めています。守りの研究・開発記録の一元化とAIでの点検・Claudeの振る舞いの評価・社内の攻撃役の強化・リスク報告の公開です。リスク報告は、少なくとも1人の外部の専門家の見直しを受けてから出します。社内の攻撃役は、バグ報奨金の参加者全体より多く脱獄を見つける水準を目指します。
【この記事の出典】
- Gizmodo(この記事の元にした報道)補助資料・2026年11月16日に確認