Opus 5.5で本当に変わったのは速さと値段だけだった
Anthropicが2026年9月22日にClaude Opus 5.5を公開しました。公式の説明は「Opus 5より30%以上速い」「ふだんの使い方なら費用は40%安い」です。ただし発表を読んだだけでは、自分の仕事が速くなるのか、答えの中身まで良くなるのかは分かりません。
そこでAInformation編集部は、claude.aiの画面で実際に動かして測りました。使ったのは仕事でよくある4つの作業です。売上表の集計・会議記録からの抜き出し・傾いて暗いレシートの読み取り・決算資料からの計算。同じ材料と同じ指示文を、Opus 5.5と旧Opus 5の両方へ投げました。
結果は次のとおりです。4つの課題はどちらのモデルも全問正解でした。差が付いたのは時間だけです。合計はOpus 5.5が98.0秒でOpus 5が112.9秒。1課題あたりの平均は24.5秒と28.2秒で、Opus 5.5のほうが13%短く済みました。
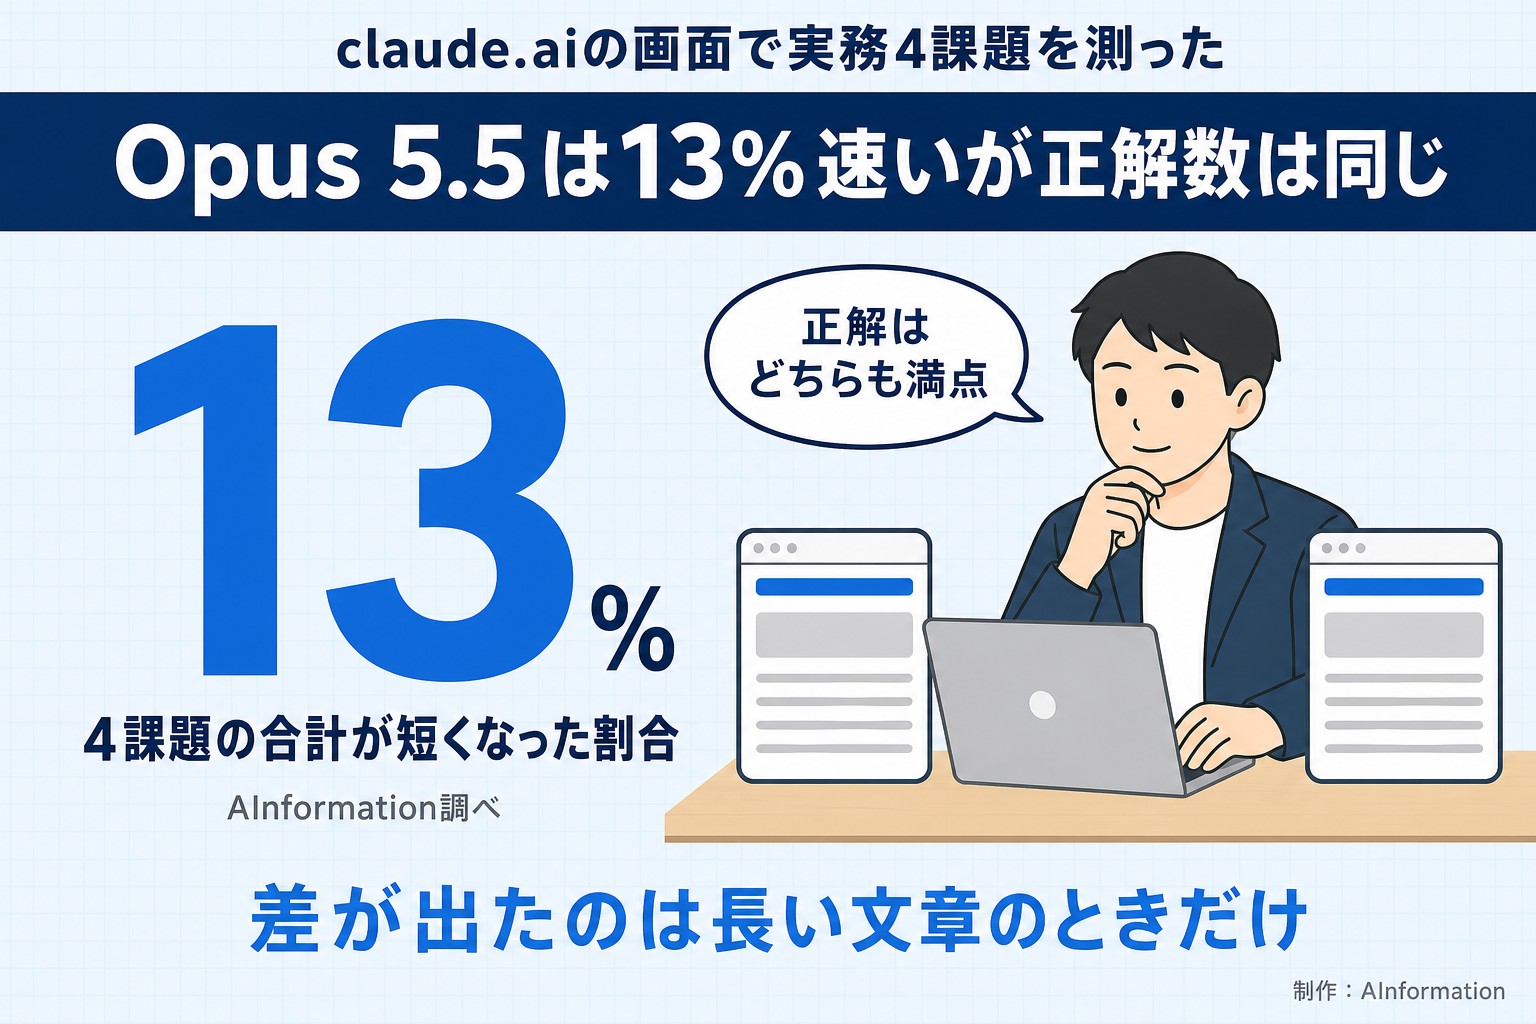
ただしこの13%という数字は、課題によって中身がまったく違います。答えが長くなる会議記録の抜き出しでは35.1秒と50.4秒で1.4倍の開きが出ました。一方で答えが短い売上表の集計は26.4秒と25.9秒で、旧モデルのほうがわずかに速いという結果でした。速くなるのは長い文章を書かせるときだけです。
もう1つ分かったことがあります。Opus 5.5には「エフォート」という設定が5段階あり、これを最大にすると会議記録の抜き出しに302.4秒かかりました。既定の「中」は34.9秒なので8.7倍です。それでいて答えの中身は既定のときと同じでした。5分待った意味はありませんでした。
この記事で分かること
- Opus 5.5と旧Opus 5に同じ仕事を4つ投げた結果(秒数と正解数)
- エフォート5段階の違い。どこまで上げる意味があるか
- 公式が言う「既定のOpus 5.5が最大設定のOpus 5に勝つ」は本当か
- claude.aiでのモデルとエフォートの変え方(画面つき)
- ChatGPT・Gemini・Copilotへ同じ課題を投げた結果
- 料金と使用量の上限がどう変わったか
claude.aiでのモデルとエフォートの変え方
先に操作から説明します。Opus 5.5はPro・Max・Team・Enterpriseの各プランで使えます。無料プランにOpusは入っていません。
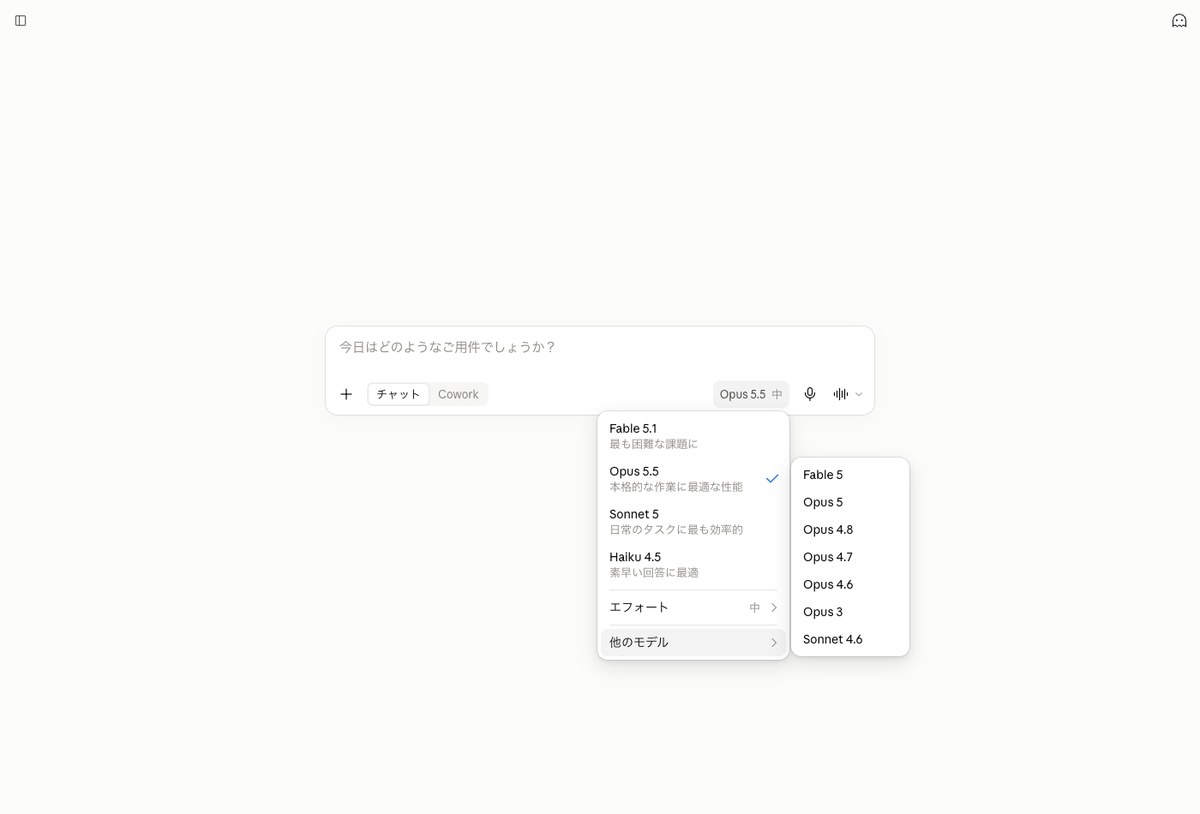
claude.aiを開くと、入力欄の右下に今のモデル名が出ています。2026年9月24日時点ではOpus 5.5が最初から選ばれていました。ここを押すとメニューが開きます。
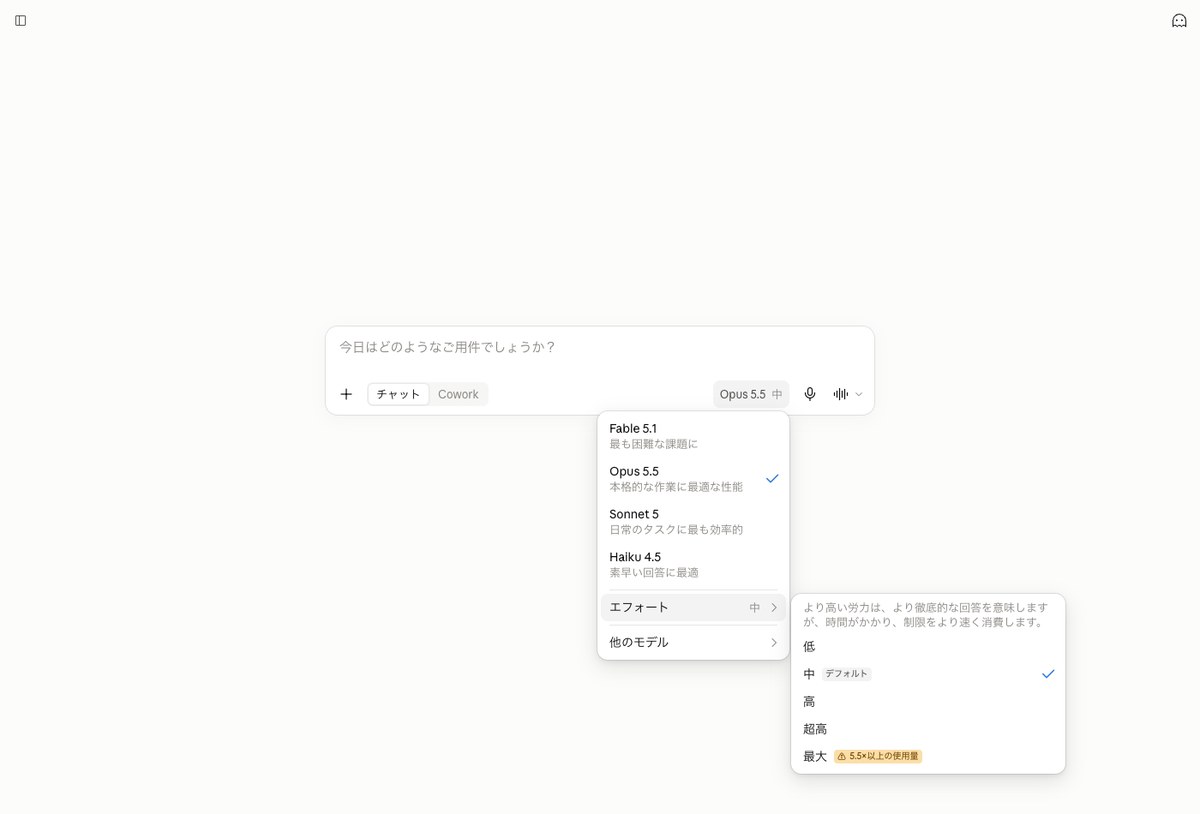
メニューには4つのモデルが並びます。Fable 5.1(最も困難な課題に)・Opus 5.5(本格的な作業に最適な性能)・Sonnet 5(日常のタスクに最も効率的)・Haiku 4.5(素早い回答に最適)です。その下に「エフォート」と「他のモデル」があります。
エフォートを押すと右側に5段階が出ます。低・中(デフォルト)・高・超高・最大です。画面にはこう書かれています。
より高い労力は、より徹底的な回答を意味しますが、時間がかかり、制限をより速く消費します。
注目したいのは最大の横に付いている警告です。5.5×以上の使用量と出ます。1回の質問で通常の5.5倍以上を消費するという意味です。5時間ごとの上限があるプランでは、ここを常用すると早く上限に当たります。
旧モデルを使いたいときは「他のモデル」を押します。中にはOpus 5・Opus 4.8・Opus 4.7・Opus 4.6・Opus 3・Fable 5・Sonnet 4.6が入っていました。前のモデルは消えていません。使い慣れたモデルを続けたい人はここから戻せます。
同じ仕事を4つ投げたら正解数は並んだ
ここからが実測です。測り方を先に書きます。
課題は4つ用意しました。どれも答えが1つに決まるものです。材料は架空の会社の資料を自分で作りました。実在する会社の資料は使っていません。
- 売上表の集計…商品5つ×12か月のCSVを渡し、年間合計と1月比で最も伸びた商品を聞く(正解は558,900千円と商品B・1.32倍)
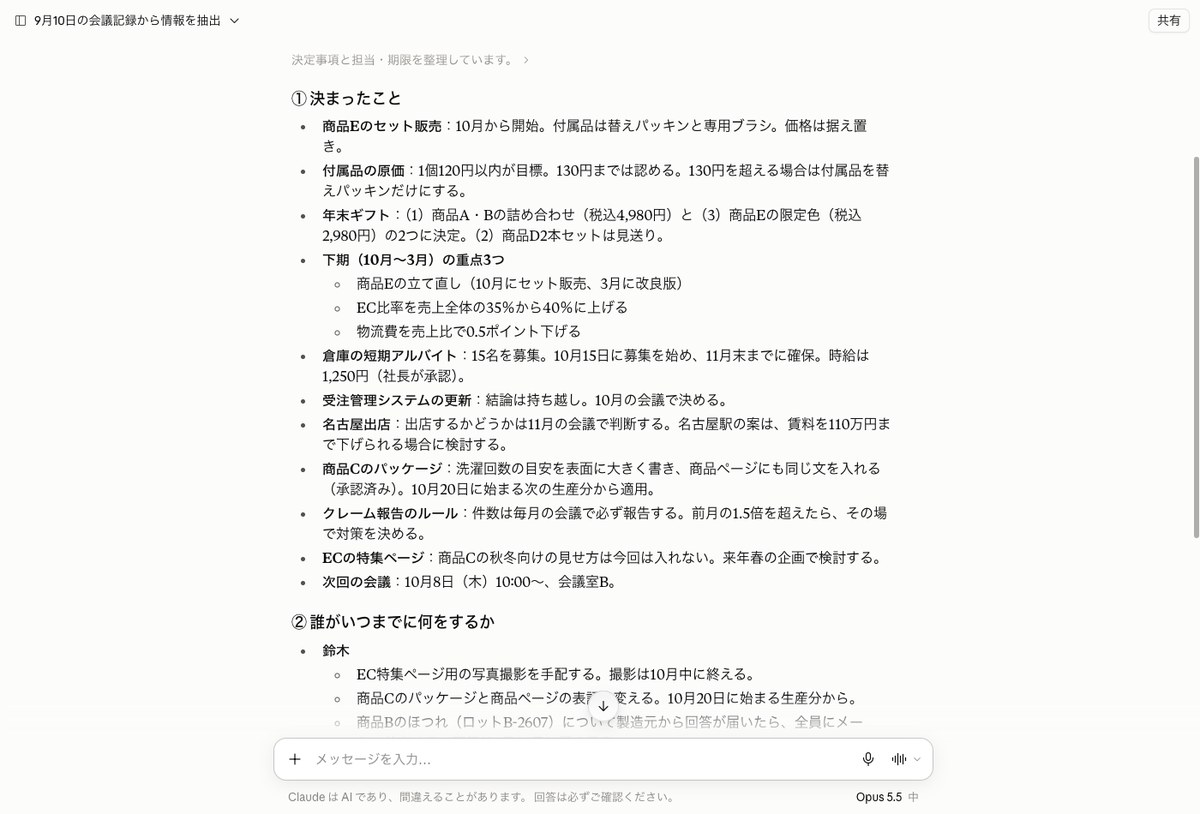
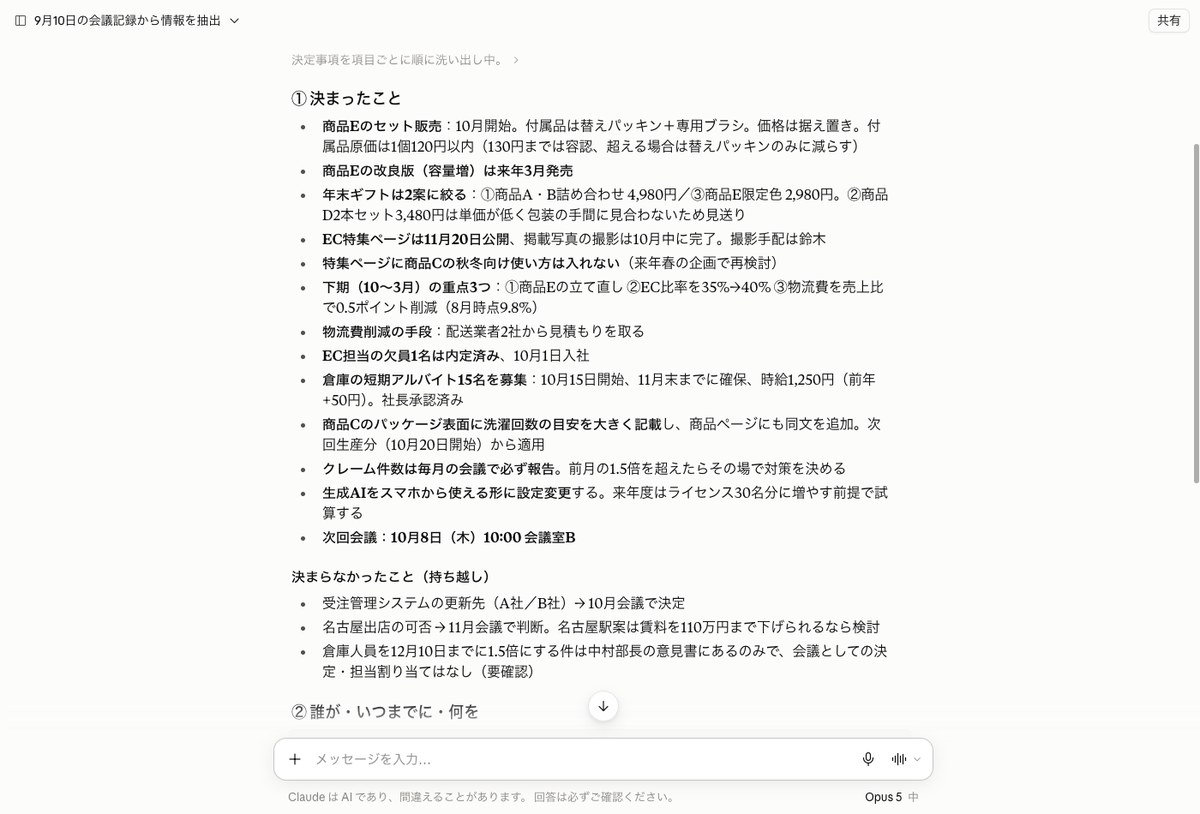
- 会議記録の抜き出し…3,359字の議事録を渡し、決まったこと8件と誰がいつまでに何をするか11件を全部抜かせる
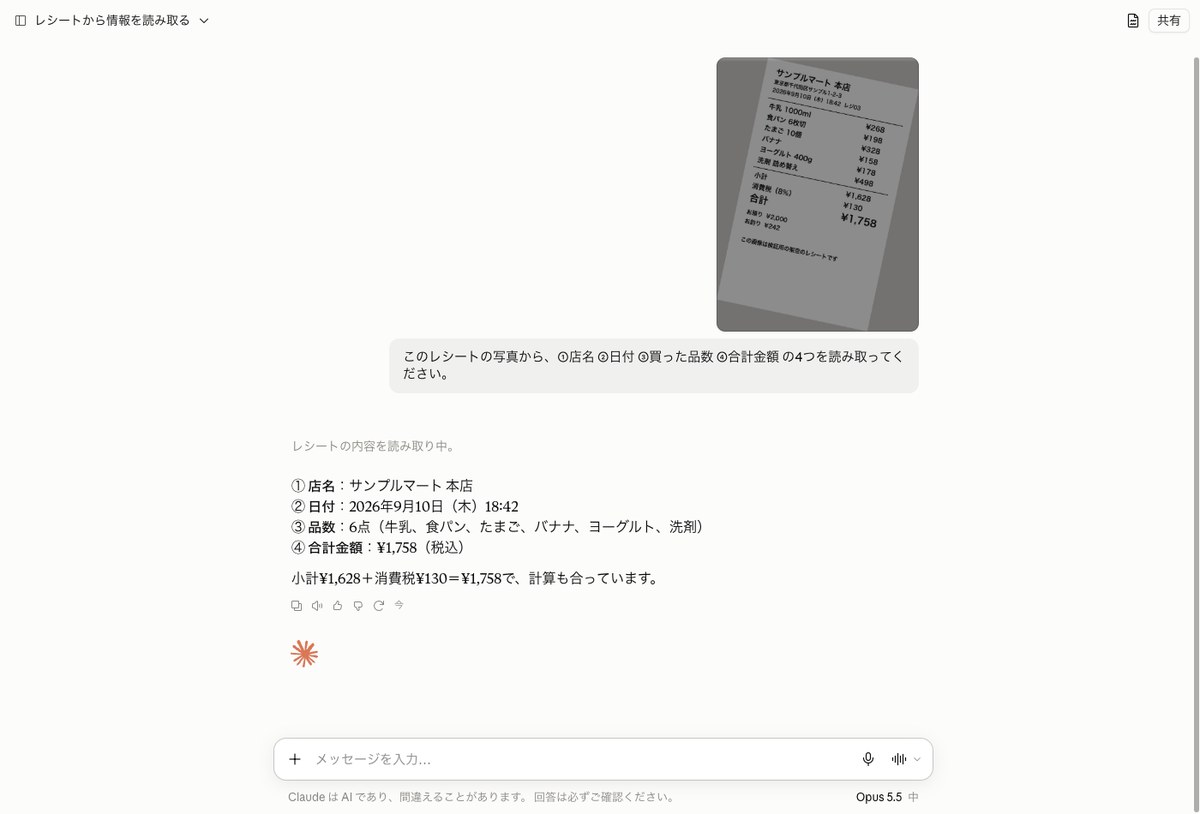
- 傾いて暗いレシートを読む…12度傾けて明るさを55%に落としたレシート写真から店名・日付・品数・合計を読ませる(正解は1,758円・6点)
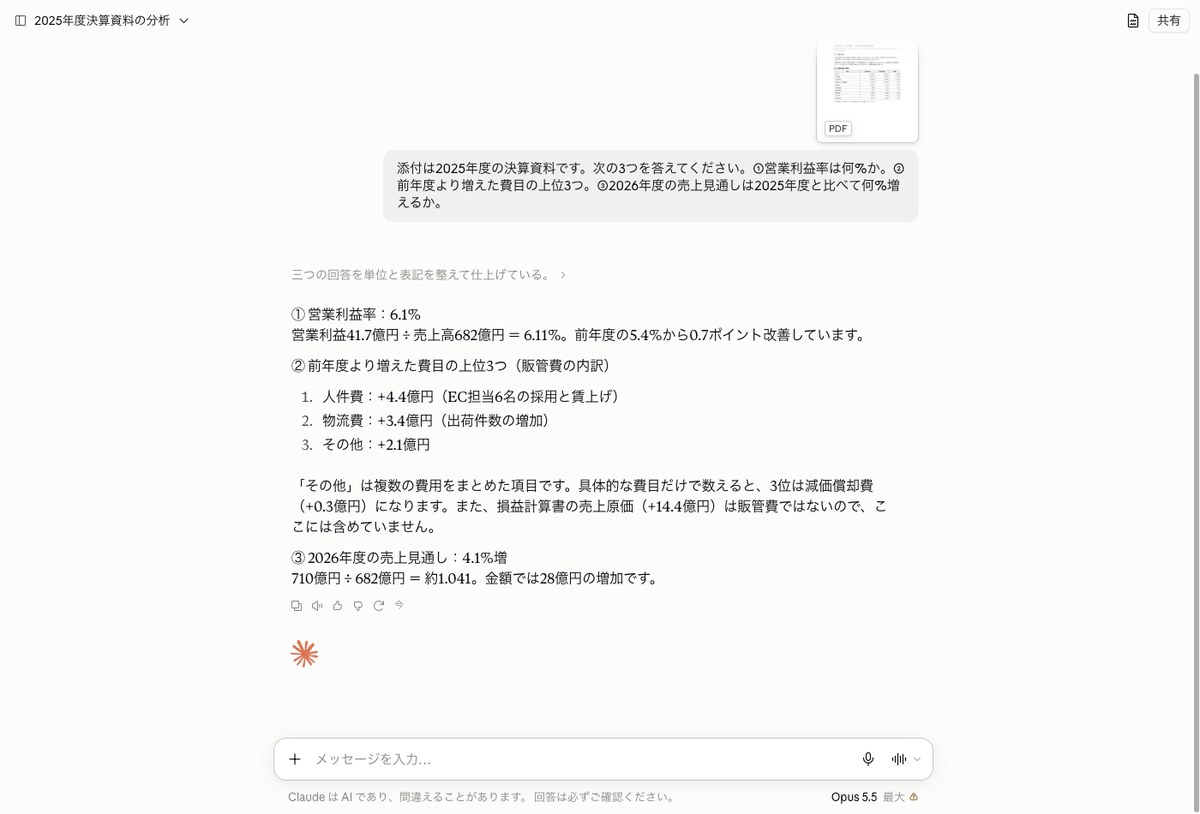
- 決算資料から計算…決算のPDFを渡し、営業利益率と増えた費目の上位3つと翌年度の伸び率を聞く(正解は6.1%と4.1%増)
正解かどうかは人が読んで決めるのではなく、答えの文章に正しい数字と語が入っているかを機械で照合しました。会議記録だけは拾えた件数で数えています。エフォートは両方とも既定の「中」にそろえました。測ったのは2026年9月24日の朝です。
| 課題 | Opus 5.5 | Opus 5 | 正解 |
|---|---|---|---|
| 売上表の集計 | 26.4秒 | 25.9秒 | 両方とも3問中3問 |
| 会議記録の抜き出し | 35.1秒 | 50.4秒 | 両方とも決定7件・宿題9件 |
| 傾いて暗いレシートを読む | 16.7秒 | 16.8秒 | 両方とも4問中4問 |
| 決算資料から計算 | 19.8秒 | 19.8秒 | 両方とも4問中4問 |
| 合計 | 98.0秒 | 112.9秒 | — |
表のとおり、4つの課題はOpus 5.5もOpus 5も全問正解でした。傾いて暗いレシートも両方が店名・日付・6点・1,758円を正しく読みました。Opus 5.5は読み取りのあとに「画像が傾いているため価格の列が品名より1行ずつ下にずれて見えます」と添えてきました。聞いていないことまで見ていた形です。
つまりこの4つの範囲では、答えの正しさに差は出ませんでした。旧Opus 5でも同じ答えが返ってきます。買い替えの判断を「賢くなったから」で決めると、思ったほどの違いを感じない可能性があります。
傾いて暗いレシートの読み取りは、実際の画面がこれです。12度傾けて暗くした写真でも、店名から合計金額まで正しく読み取りました。
速くなるのは長い文章を書かせるときだけだった
1回ずつ測っただけでは、本当に速いのか、たまたまその時すいていたのかが分かりません。そこで答えの短い課題と長い課題を選び、Opus 5.5と旧Opus 5で3回ずつ測り直しました。出てきた3つの真ん中の値(中央値)で比べます。
| 課題 | Opus 5.5 | Opus 5 | 短くなった割合 |
|---|---|---|---|
| 売上表の集計(答えは約360字) | 22.9秒 | 25.8秒 | 11% |
| 会議記録の抜き出し(答えは約1,200字) | 32.1秒 | 50.2秒 | 36% |
はっきり分かれました。答えが短い課題は11%で、長い課題は36%です。公式が言う「30%以上速い」は長い文章を書かせたときにだけ当てはまりました。
理由は書く速さそのものにあります。答えの文字数を秒数で割ると、会議記録ではOpus 5.5が37.1字/秒でOpus 5が26.2字/秒でした。1.42倍の差です。売上表のほうは14.8字/秒と13.9字/秒で1.06倍しかありません。短い答えでは、書き始めるまでの準備の時間が全体の大半を占めるので、書く速さの差が表に出ないわけです。
もう1つ大事なことが分かりました。最初に1回だけ測ったときは、売上表の集計がOpus 5.5の26.4秒に対してOpus 5が25.9秒で、旧モデルのほうが速いという結果でした。3回測ると22.9秒と25.8秒でひっくり返ります。数秒の違いは混み具合で簡単に動きます。速さを比べた記事を読むときは、何回測ったのかを見てください。
旧Opus 5は音声を断りOpus 5.5は文字起こしまでやった
ここまでは文字とPDFと画像の課題でした。差は時間だけです。ところが音声を渡した瞬間に、時間ではなく可否が分かれました。
使ったのは1分43秒の会議の音声(mp3)です。商品企画の週次ミーティングという設定で、決まったことと担当者と期限が入っています。指示は文字の課題と同じで、決定事項と担当と期限を箇条書きにしてください、というものです。
Opus 5.5は214.4秒かけて全部を書き出しました。まず音声を文字に起こし、そこから決定事項3件と宿題2件と次回の日時を拾っています。こちらが用意した正解7項目はすべて入っていました。
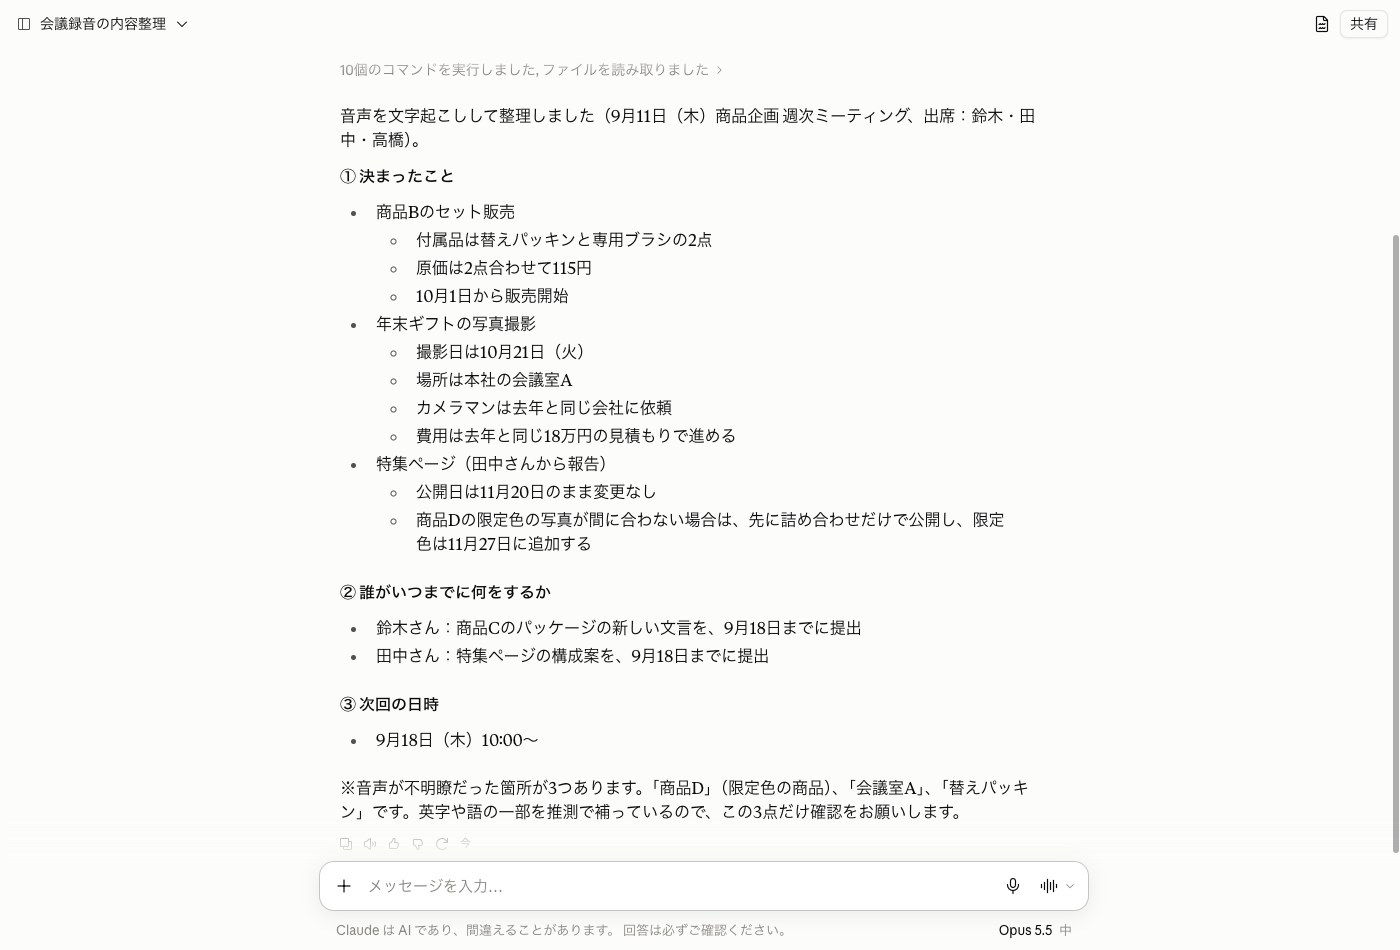
答えの最後にはこう添えてありました。音声が不明瞭だった箇所が3つあります、商品Dと会議室Aと替えパッキンです、英字や語の一部を推測で補っているのでこの3点だけ確認をお願いします。聞き取れなかった場所を自分から申告しています。実務では、この一言があるかどうかで確認の手間がまったく変わります。
一方の旧Opus 5は、同じファイルを受け取ってこう答えました。
音声ファイルの中身を聞き取ることができないため、このままでは議事録を作成できません。テキスト化されたものであれば対応できます。
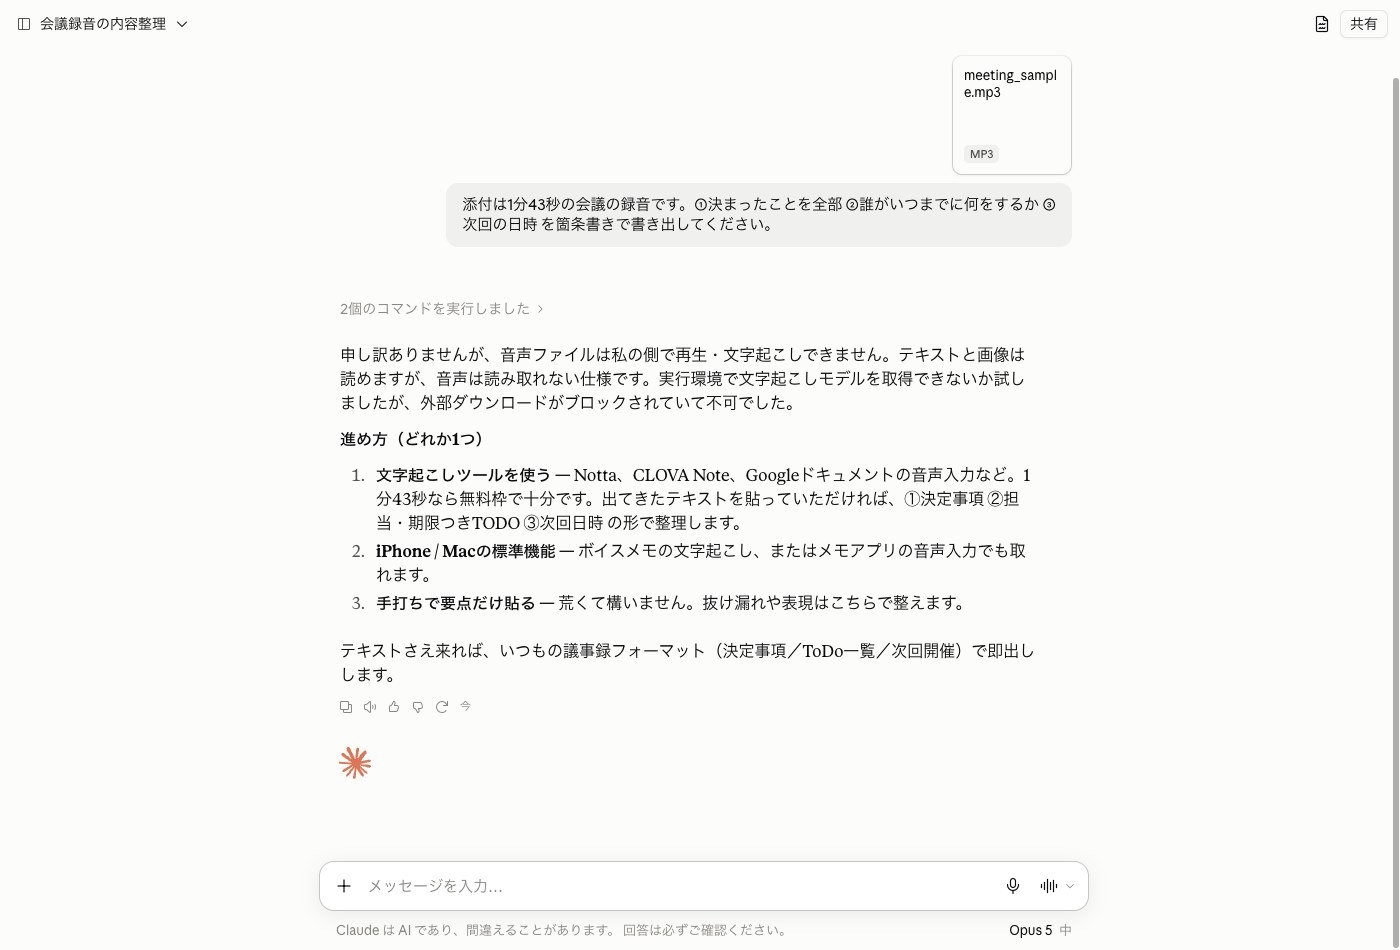
そのうえでNottaやCLOVA Noteで文字起こししてから貼り直すよう案内してきました。たまたま断ったのではないか気になったので3回試しました。3回とも断りました。かかった時間は23.0秒と41.2秒と26.0秒で、どれも中身を処理せずに返事だけを返しています。Opus 5.5のほうも2回試して、どちらも7項目すべて正解でした。
| 回 | Claude Opus 5.5 | 旧Opus 5 |
|---|---|---|
| 1回目 | 214.4秒・7項目すべて正解 | 23.0秒・聞き取れないと回答 |
| 2回目 | 181.2秒・7項目すべて正解 | 41.2秒・再生も文字起こしもできないと回答 |
| 3回目 | - | 26.0秒・同じ理由で断る |
公式の発表は速さと料金が中心で、音声を扱えるようになったとは書かれていません。実際に投げてみて初めて出てきた差です。会議の録音をそのまま渡して議事録にしたい人にとっては、13%の速さより、この1点のほうが乗り換える理由になります。
注意したいのは時間です。1分43秒の音声に214.4秒かかりました。音声の長さの倍以上です。1時間の会議をそのまま渡すと、待ち時間はかなりのものになります。長い録音は文字起こしの道具で先にテキストにしてから渡したほうが速く終わります。
Claudeの4モデルへ同じ会議記録を投げた
claude.aiで選べるモデルは、2026年9月24日の時点でFable 5.1・Opus 5.5・Sonnet 5・Haiku 4.5の4つです。Opus 5.5と旧モデルを比べるだけでは、どれを選べばいいのかが分かりません。そこで4つ全部へ同じ仕事を投げました。課題は会議記録の抜き出しと売上表の集計の2つで、エフォートはすべて既定にそろえています。
| モデル | 会議記録の抜き出し | 拾えた項目 | 売上表の集計 |
|---|---|---|---|
| Opus 5.5 | 31.9秒 | 2/2 | 22.9秒 |
| Haiku 4.5 | 31.9秒 | 1/2 | 22.8秒 |
| Fable 5.1 | 41.1秒 | 2/2 | 22.8秒 |
| Sonnet 5 | 59.2秒 | 2/2 | 22.9秒 |
答えの短い売上表では4つとも22.8秒から22.9秒に収まりました。差はほとんどありません。この課題でモデルを選ぶ意味は薄いということです。
長い会議記録になると開きます。いちばん速いOpus 5.5とHaiku 4.5が31.9秒で、いちばん遅いSonnet 5は59.2秒でした。1.86倍の差です。名前のとおりHaiku 4.5は速さに振ったモデルで、そこはOpus 5.5に並びました。
ただしHaiku 4.5だけ落としました。決まったこと8件のうち拾えたのは6件です。抜けたのは商品Cのパッケージの話とクレーム報告の基準で、どちらも会議記録の後ろのほうに書いてあります。速く返すぶん、長い文章の後半が薄くなる形です。
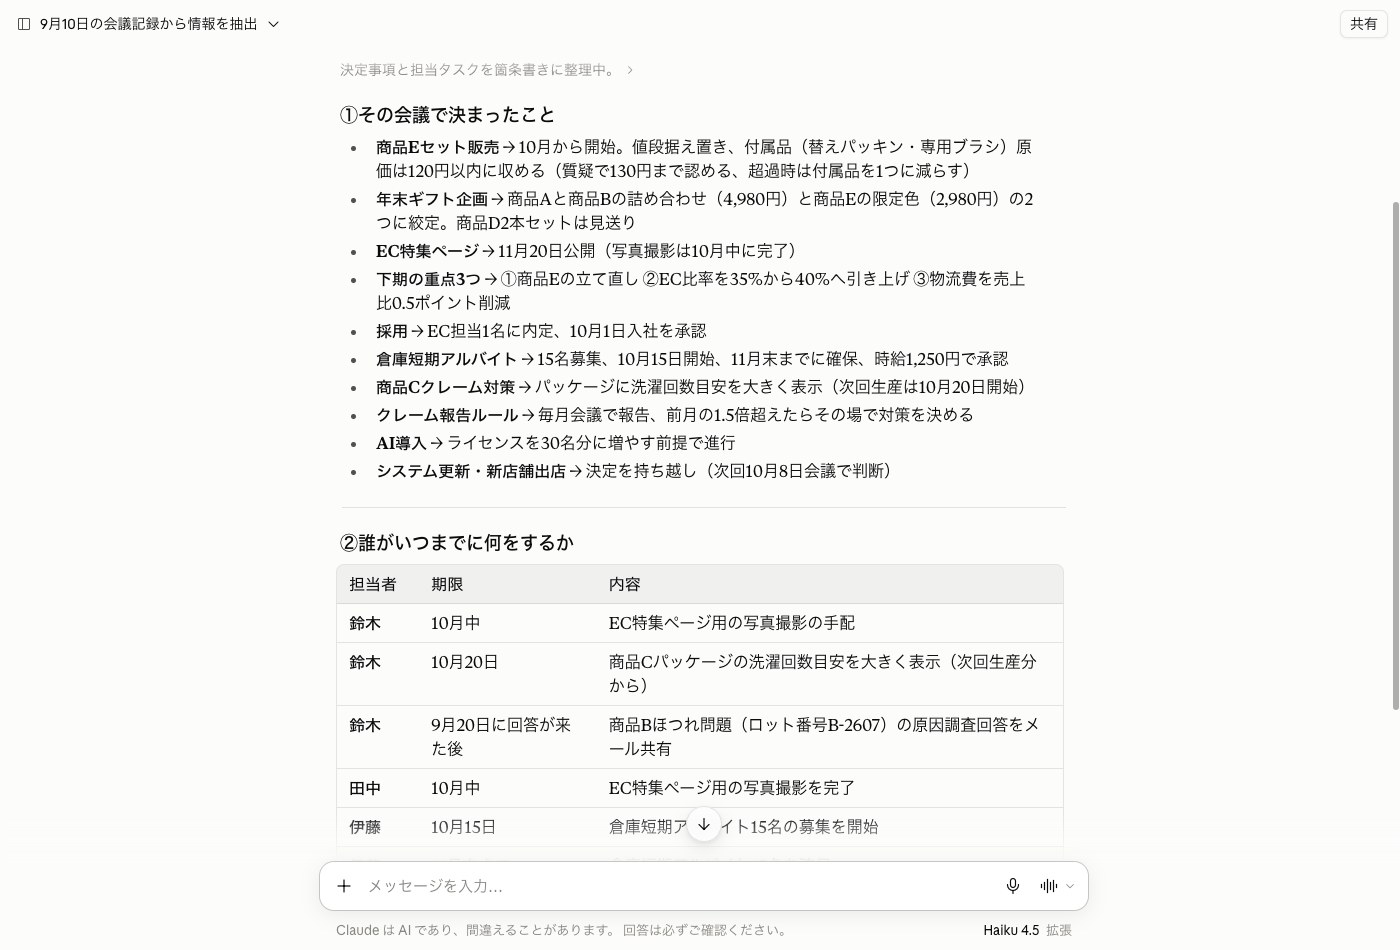
もう1つHaiku 4.5には他と違う点があります。エフォートの選択肢がありません。メニューを開いても低・中・高・超高・最大の5段階が出てこず、モデル名の横には拡張とだけ表示されます。じっくり考えさせたい仕事では、そもそも設定で粘らせることができません。
Fable 5.1は41.1秒で2項目とも正解でした。最も難しい課題に向くという位置づけのモデルですが、この程度の会議記録ではOpus 5.5より9.2秒遅いだけで、答えの中身に差は出ませんでした。難しい課題でないならOpus 5.5で足ります。
エフォートは上げても正解が増えなかった
Opus 5.5でいちばん迷うのがエフォートの設定です。低・中・高・超高・最大の5段階があり、既定は中です。上げれば賢くなるのかを確かめました。
決算資料から3つの数字を計算させる課題を、5段階すべてで解かせました。
| エフォート | 決算資料から計算 | 会議記録の抜き出し | 正解 |
|---|---|---|---|
| 低 | 13.7秒 | 28.9秒 | どちらも満点 |
| 中(既定) | 16.8秒 | 34.9秒 | どちらも満点 |
| 高 | 16.7秒 | 測っていない | 満点 |
| 超高 | 23.0秒 | 測っていない | 満点 |
| 最大 | 56.2秒 | 302.4秒 | どちらも満点 |
結果は分かりやすいものでした。5段階すべてで全問正解です。そして時間だけが伸びました。低は13.7秒で最大は56.2秒なので4.1倍です。中と高はほぼ同じ(16.8秒と16.7秒)で、超高から目に見えて遅くなります。
もっと極端な差が出たのが会議記録の抜き出しです。低が28.9秒、中が34.9秒、そして最大は302.4秒でした。5分です。
それでも拾えた件数は変わりませんでした。決まったこと7件・宿題9件で、既定の中とまったく同じです。5分待って増えたものは何もありませんでした。
画面の説明文には「より高い労力は、より徹底的な回答を意味しますが、時間がかかり、制限をより速く消費します」と書かれています。最大には「5.5×以上の使用量」の警告も付きます。今回のような答えの決まった事務作業では、上げる理由が見当たりませんでした。
逆に言えば低まで下げても正解は落ちませんでした。急いでいるときは下げる選択肢があります。ただし今回試したのは答えが1つに決まる課題だけです。難しい設計や長い推論が要る仕事では違う結果になる可能性があります。
公式が言う「既定のOpus 5.5が最大設定のOpus 5に勝つ」を確かめた
Anthropicは発表の中でこう書いています。
Opus 5.5 at default effort beats Opus 5 at max effort for about a fifth of the cost(既定のエフォートのOpus 5.5が、最大エフォートのOpus 5を約5分の1の費用で上回る)
同じ決算の課題で、この2つを直接ぶつけました。
| 設定 | かかった時間 | 正解 |
|---|---|---|
| Opus 5.5・エフォート中(既定) | 16.8秒 | 4問中4問 |
| Opus 5・エフォート最大 | 22.8秒 | 4問中4問 |
時間では既定のOpus 5.5が6.0秒速く、公式の言うとおりになりました。ただし正解数はどちらも満点で差が付きません。「上回る」と言えるのは速さと費用の面だけで、答えの質までは今回の課題で確かめられませんでした。
費用の「5分の1」も補足が要ります。エフォート最大は使用量を5.5倍以上消費します。単価が20%安いことと合わせると5分の1前後になる計算です。claude.aiの定額プランを使っている人にとっては、財布から出ていくお金ではなく5時間ごとの上限の減り方として効いてきます。
ChatGPT・Gemini・Copilotへ同じ課題を投げた
Opus 5.5だけを見ても、他のAIと比べてどうかは分かりません。そこで同じ3つの課題を、ChatGPT・Gemini・Copilotへも同じ文面で投げました。どれもAInformation編集部が契約している月額アカウントのブラウザ画面から操作しています。モデルはGeminiがPro 拡張、CopilotがSmartで、どちらも既定のままです。
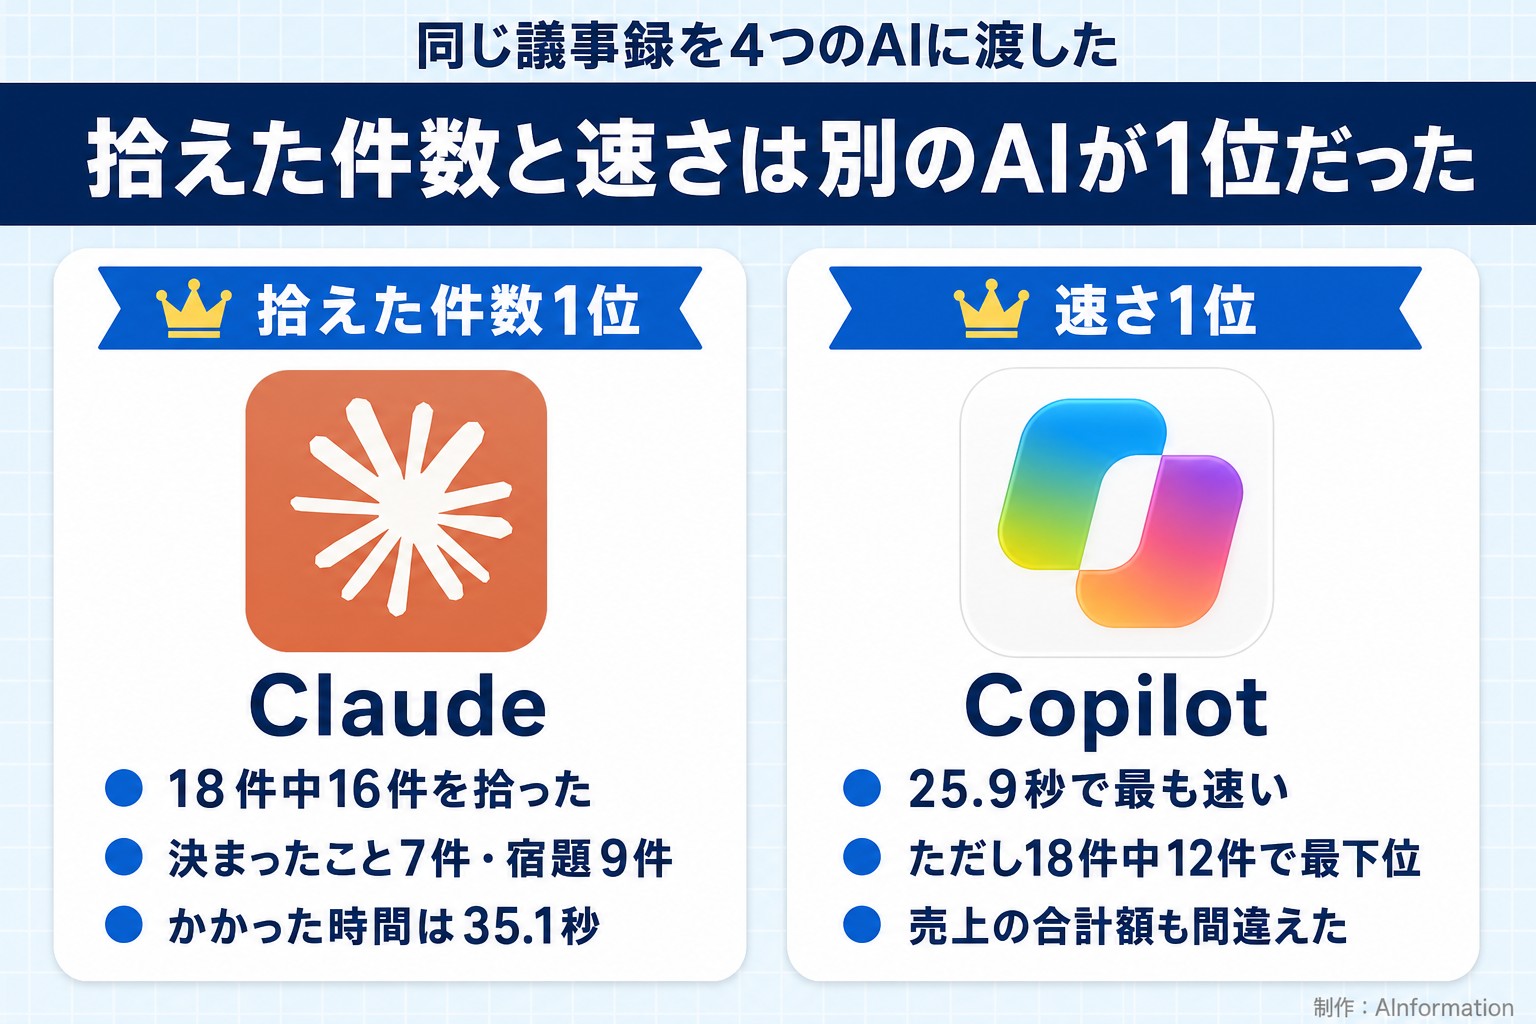
いちばん差が出たのが会議記録の抜き出しでした。決まったこと8件と宿題10件のうち、どれだけ拾えたかを数えています。
| AI | 時間 | 決まったこと | 宿題 | 合計 |
|---|---|---|---|---|
| Claude(Opus 5.5) | 35.1秒 | 7件/8件 | 9件/10件 | 16/18 |
| ChatGPT | 47.6秒 | 7件/8件 | 6件/10件 | 13/18 |
| Gemini | 40.2秒 | 6件/8件 | 7件/10件 | 13/18 |
| Copilot | 25.9秒 | 5件/8件 | 7件/10件 | 12/18 |
Claudeがいちばん多く拾いました。いちばん速かったのはCopilotですが、拾えたのは12件で最下位です。速いAIが取りこぼしているという関係が、そのまま出ました。
売上表の集計ではもっとはっきりした差が出ました。Copilotは年間合計を547,200千円と答えています。正解は558,900千円です。最も伸びた商品も商品E(1.06倍)と答えました。正解は商品B(1.32倍)です。
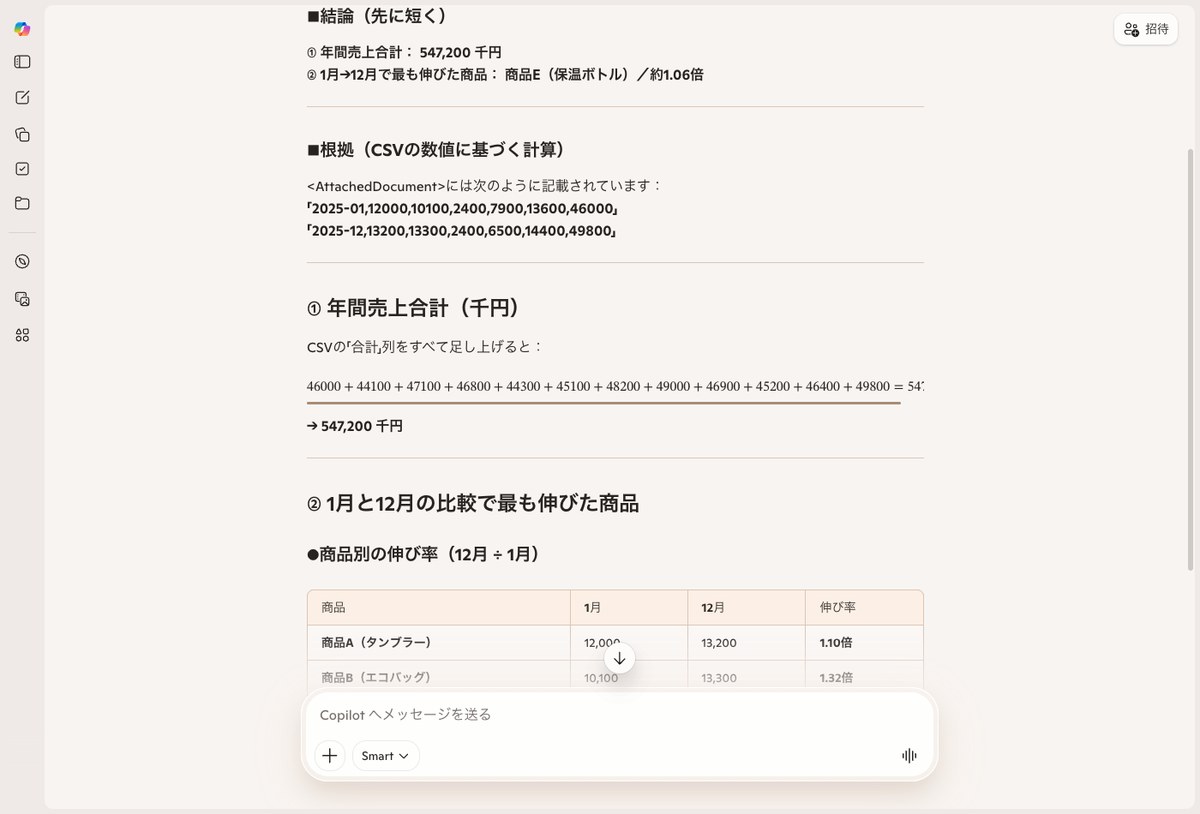
面白いのはこの画面の下です。Copilot自身が出した表には商品B 1.32倍と正しく書かれています。表では正しく計算しておきながら、結論で別の商品を選びました。数字を自分で確かめない使い方だと、この取り違えには気づけません。
傾いて暗いレシートは4つとも正解でした。写真の読み取りはどのAIでも実用になっています。Copilotが13.7秒で最も速く、Geminiが22.0秒で最も遅いという差だけでした。
Excel・PDF・画像のどれで渡しても答えは同じだった
同じ表でも、Excelのまま渡すのかPDFにするのか画面を撮って渡すのかで手間が変わります。そこでまったく同じ売上表を3つの形式で作り、Opus 5.5へ順に投げました。聞いたことは年間合計と伸びた商品と倍率の3つで、正解はどれも同じです。
| 渡し方 | かかった時間 | 正解 |
|---|---|---|
| Excel(.xlsx) | 22.8秒 | 3/3 |
| 22.9秒 | 3/3 | |
| 画面を撮った画像(.png) | 19.8秒 | 3/3 |
3つとも全問正解でした。年間合計の558,900千円も、伸びた商品Bも、1.32倍という倍率も同じように答えています。形式をそろえるために変換する必要はありません。手元にあるものをそのまま渡せば済みます。
意外だったのは画像が最も速かったことです。19.8秒でExcelより3.0秒短く終わりました。表を画像として一度に見るほうが、セルを1つずつ読むより手数が少ないのかもしれません。とはいえ3秒の違いなので、使いやすい形式を選んで構いません。
レシートは手ブレさせても画質を落としても読めた
紙の書類をスマホで撮って渡す場面では、いつもきれいに撮れるとは限りません。そこで同じレシートを3通り用意しました。きれいに撮ったもの、手ブレさせたもの、画質を大きく落としたものです。聞いたのは店名・日付・品数・合計金額の4つです。
| レシートの状態 | かかった時間 | 正解 |
|---|---|---|
| きれいに撮ったもの | 13.8秒 | 4/4 |
| 手ブレしたもの | 16.7秒 | 4/4 |
| 画質を落としたもの | 16.8秒 | 4/4 |
3つとも全問正解です。合計金額の1,758円も、6品という品数も、崩した画像から正しく読めました。時間は3.0秒ほど延びますが、読み違えは起きていません。撮り直す手間をかけるより、そのまま投げてみるほうが早いという結果です。
棒グラフと表の写真からも数字を読めた
資料の中身がグラフになっていることもあります。棒グラフの画像と、紙の表を撮った写真の2つを渡して、数字を読み取らせました。
| 渡したもの | かかった時間 | 正解 |
|---|---|---|
| 棒グラフの画像 | 13.7秒 | 4/4 |
| 表を撮った写真 | 13.7秒 | 3/3 |
どちらも13.7秒で全問正解でした。棒グラフでは各月の数値と最大の月を、表の写真では行と列を突き合わせた値を正しく答えています。数字が画像の中にあっても、表計算のファイルと同じように扱えます。
英語のプレスリリースと敬語のメールも試した
実務では日本語だけとは限りません。英語のプレスリリースと、遠回しな敬語で書かれたお詫びのメールも投げました。
| 課題 | Claude Opus 5.5 | 旧Opus 5 |
|---|---|---|
| 英語のプレスリリースを読む | 13.7秒・5/5 | 13.7秒・5/5 |
| お詫びメールから要点を抜く | 13.7秒・6/6 | - |
英語は新旧どちらも13.7秒で全問正解でした。金額も日付も社名も落としていません。ここでは差が出ないということです。
敬語のメールはOpus 5.5で13.7秒・6項目すべて正解でした。何卒ご容赦いただきたく、のような遠回しな言い回しからも、実際に何が起きて誰がいつまでに何をするのかを取り出せています。
決算資料とグラフは他社のAIとも比べた
会議記録では4つのAIに差が出ました。では決算資料の計算やグラフの読み取りではどうでしょうか。GeminiとCopilotへも同じものを投げました。
| 課題 | Claude Opus 5.5 | Gemini | Copilot |
|---|---|---|---|
| 決算資料から計算 | 16.8秒・4/4 | 37.3秒・4/4 | 23.0秒・4/4 |
| 英語のプレスリリース | 13.7秒・5/5 | 25.0秒・5/5 | 16.8秒・5/5 |
| 棒グラフから数値を読む | 13.7秒・4/4 | 22.0秒・4/4 | 19.7秒・4/4 |
この3つの課題では9試行とも全問正解でした。営業利益率の4.1%も、前年比の伸びも、グラフの各月の数値も、3つとも同じ答えを出しています。会議記録でCopilotが年間合計を間違えたような読み違えは起きませんでした。
差が出たのは時間だけです。英語のプレスリリースではClaude Opus 5.5が13.7秒でGeminiの25.0秒より11.3秒短く終わりました。決算資料でも16.8秒と37.3秒で2.2倍の開きです。答えの正しさで選べないなら、待ち時間で選ぶことになります。
つまり課題の種類で選び分ける形になります。決まった項目を拾うだけの仕事はどれを使っても正解にたどり着きます。長い会議記録のように拾う項目が多い仕事では、正解数そのものに差が出ます。ここは記事の前半で見たとおりです。
料金は2割下がり5時間ごとの上限も伸びた
APIで使う場合の単価は下がりました。入力が100万トークンあたり4ドルで、Opus 5の5ドルから20%下がっています。出力は20ドルで、こちらも25ドルから20%減です。いちばん下げ幅が大きいのはキャッシュの読み取りで、0.50ドルから0.20ドルへ60%下がりました。
| 項目(100万トークンあたり) | Opus 5 | Opus 5.5 |
|---|---|---|
| 入力 | 5ドル | 4ドル |
| 出力 | 25ドル | 20ドル |
| キャッシュの読み取り | 0.50ドル | 0.20ドル |
| ふだんの使い方の合計 | 基準 | 40%減 |
claude.aiの定額プランを使っている人には、単価より5時間ごとの使用量の上限のほうが関係します。公式はこの上限も引き上げたと書いています。同じ仕事を少ないトークンで終えられるので、上限に当たるまでの回数が増える計算です。
発表そのものの中身はOpus 5.5は出力100万トークン20ドルで暴走も85%減ったにまとめてあります。安全性の評価やAPI利用の注意はそちらを見てください。他社との料金の比較はOpus 5を費用9%で抜いたGPT-6 SolはまだChatに来ないで扱っています。
変えたほうがいい人と急がなくていい人
今回の実測から言えることを整理します。
変えたほうがいいのは、長い文章を書かせる人です。議事録の要約・資料の下書き・長文の翻訳のように出力が1,000字を超える作業では、待ち時間がはっきり短くなりました。会議記録の課題では50.4秒が35.1秒になっています。1日に何度も繰り返す作業なら効いてきます。
急がなくていいのは、短い質問を中心に使っている人です。売上表の集計のように答えが数行で終わる作業では、26.4秒と25.9秒でほとんど変わりませんでした。答えの正しさも4課題すべてで同じでした。使い慣れたモデルをそのまま使っても困りません。
エフォートは既定の中のままで問題ありません。今回の範囲では上げても正解が増えず、時間と使用量だけが増えました。急ぐときは低へ下げる手があります。
そしてどのモデルを使っても、数字は自分で確かめる必要があります。Copilotは自分の表と食い違う結論を出しました。Claudeは今回の4課題を全問正解しましたが、これは答えが1つに決まる事務作業だからです。判断や前提が絡む仕事では、AIの答えをそのまま使わずに根拠を開いて見てください。
どう測ったか
数字の出どころをはっきりさせておきます。
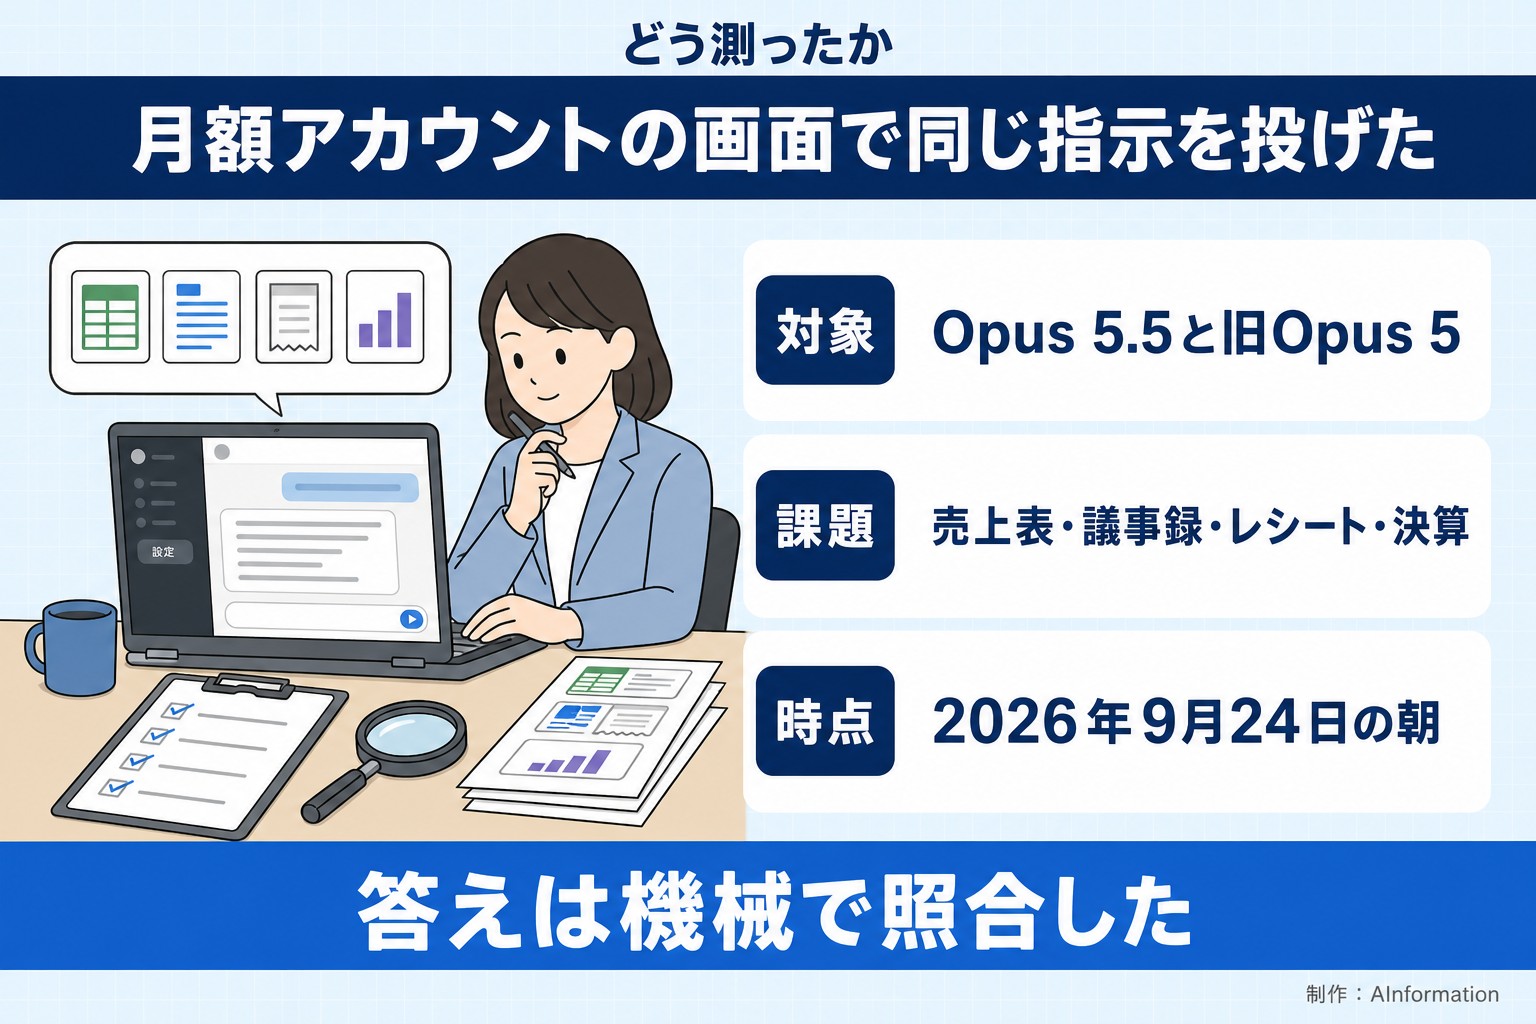
測ったのは2026年9月24日の朝7時50分から8時40分にかけてです。claude.ai・chatgpt.com・gemini.google.com・copilot.microsoft.comの各画面を、AInformation編集部が契約している月額アカウントで開いて操作しました。APIは使っていません。読者が同じ画面で同じことをしたときに近い数字にするためです。
時間は、送信ボタンを押してから答えが書き終わるまでを機械で測りました。この数字はサーバーの混み具合に左右されます。同じ課題を別の時間に投げれば数秒は動きます。1回の測定だけで速い遅いを決めないよう、主な課題は日を分けずに繰り返して中央値も取りました。
正解かどうかは、答えの文章に正しい数字と語が入っているかを機械で照合しています。AIに採点させると甘くなるためです。会議記録の抜き出しだけは、決まったこと8件と宿題10件それぞれについて、中身を指す語が含まれるかで数えました。
材料はすべて架空の会社のものを自分で作りました。実在する会社の資料や個人情報は使っていません。
まとめ
Claude Opus 5.5をclaude.aiの画面で実際に動かした結果をまとめます。
- 実務4課題はOpus 5.5もOpus 5も全問正解だった。答えの正しさに差は出なかった
- 速さは合計98.0秒と112.9秒で13%短縮。ただし差が出たのは答えが長い課題だけで、短い集計では逆転した
- エフォート5段階はすべて全問正解。最大にすると会議記録で302.4秒(既定の8.7倍)かかり、増えたものは何も無かった
- 公式の「既定のOpus 5.5が最大設定のOpus 5を上回る」は、時間では16.8秒と22.8秒でそのとおりだった。正解数は同じ
- 4つのAIで同じ課題を解かせると、会議記録の抜き出しはClaudeが16/18でいちばん多く拾った。最速のCopilotは12/18で最下位だった
発表の「30%速い」「40%安い」は正しい一方で、それが効くのは長い文章を書かせるときに限られます。賢くなったから乗り換える、という買い方にはならない結果でした。使っているプランにOpusが含まれているなら、既定のまま使い続けるのがいちばん無駄がありません。