robots.txtにAI学習拒否の共通行 4社が読むと表明
Google・Microsoft・OpenAI・Anthropicが、robots.txtの共通の1行をAI学習の拒否として読むと表明した。これまでは会社ごとにクローラーの名前を並べて断る必要があった。
新しい書き方の元は、Anthropicの技術者がIETFに出した草案だ。User-Agentの欄に「__usage_ai-training」という名前を置き、その下にいつもどおりDisallowを書く。サイト全体を断るなら次の2行になる。
- User-Agent: __usage_ai-training
- Disallow: /
断るのは学習に使うことで、クローラーが読みに来ること自体は止めない。何も書かなければ学習してよいという扱いになる。すでに集められた文章を消す仕組みもない。
読むのはAnthropicだけ Microsoftは2027年2月
4社のうち、もう読み始めたと言っているのはAnthropicだけだ。残る3社は時期がばらばらで、OpenAIは日付を出していない。
| 会社 | 共通の1行への対応 | 学習と引用を分けられるか |
|---|---|---|
| Anthropic | 対応を始めた | 発表に記載なし |
| OpenAI | 数か月のうちに対応・日付なし | 発表に記載なし |
| Microsoft | 2027年2月1日からクロール時に読む | 分けられる(ページごとの引用の設定) |
| 2027年の対応を目指す | 分ける方法の説明なし | |
| Meta | 守るとは約束していない | ― |
しかも草案はIETFが認めた標準ではなく、個人の草案という扱いだ。見直されなければ2027年5月3日に効力が切れる。OpenAIは対象を「基盤となる生成AIの学習」と書いていて、草案の定義より狭く見える。
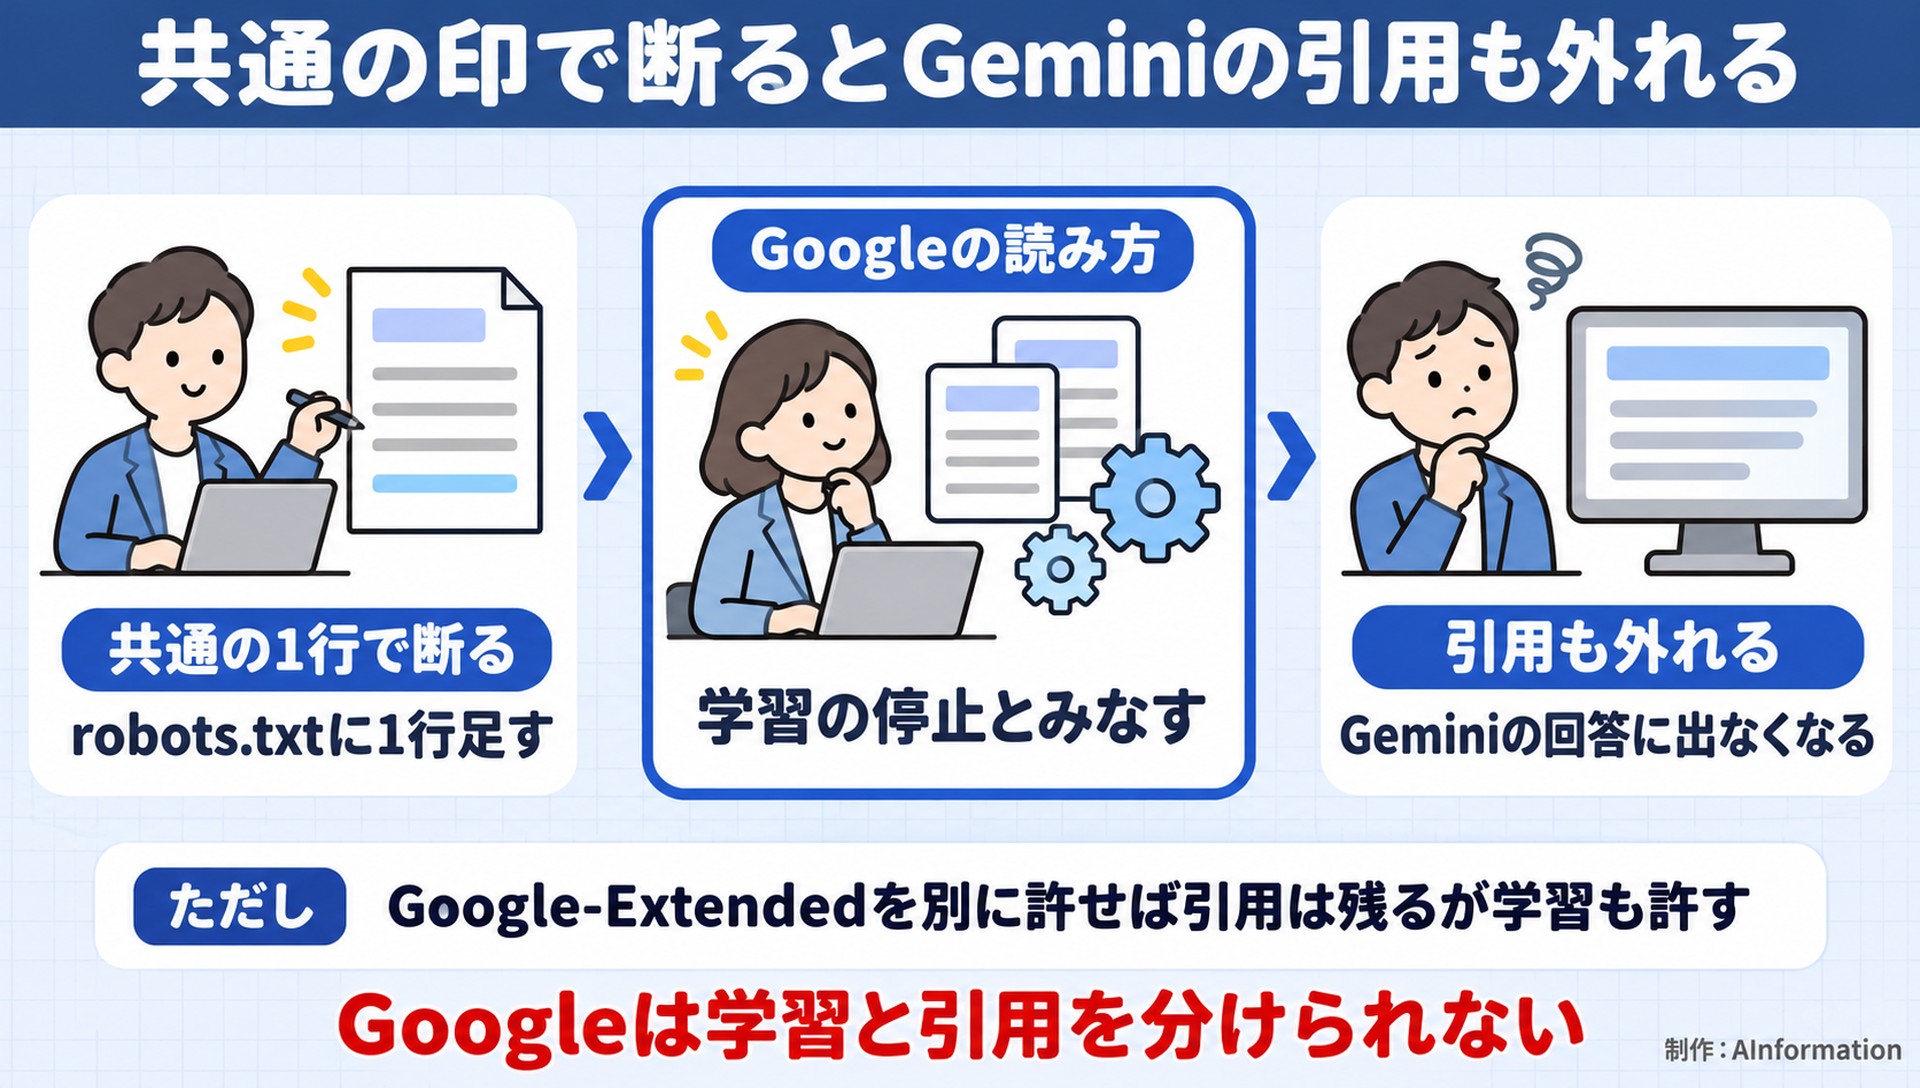
Googleは学習と引用を分けない Geminiの回答からも外れる
学習だけ断りたいサイトが気をつけたいのはGoogleだ。共通の1行で断ってGoogle-Extendedを別に書いていないと、Googleはそれを止めたのと同じに扱う。
Google-ExtendedはGeminiアプリでの引用にも効く。Googleの検索セントラルのブログは、これを許したサイトが回答に出られると書く。分ける方法は説明書に無いとSearch Engine Journalは伝えた。
Microsoftは逆で、学習と引用を別々に決められる。DisallowExtendedを選ぶと、Copilotなど自社の製品にだけ出せる。他社へ売る引用の仕組みからは外れるとBingのブログは書く。
国内21サイトで共通の印は1件 自社のrobots.txtを開く
AInformationは11月9日に国内のニュースサイトや大手サービス21件のrobots.txtを数えた。共通の1行を書いていたのはクックパッドの1件だけだった。Google-Extendedを全体で止めていたのは8件だ。
8件には朝日新聞・日本経済新聞・読売新聞・NHKなどが入る。Googleの説明に沿えば、Geminiアプリの回答で引用される対象から外れている可能性がある。新しい1行より前に、各社がもう学習を断っていたことになる。
自社のサイトを持つ会社が今やっておきたいのは次の3つだ。
- ブラウザで自社のドメインの後ろに /robots.txt を付けて開き、Google-ExtendedとGPTBotの行があるか見る
- 断りたいのが学習だけか、AIの回答での引用までかを先に決める
- Geminiの引用を残したいなら、Google-Extendedを許す行を別に書く。そのときGoogleの学習は断れない
Googleが対応する2027年までは、共通の1行を足してもGoogleの扱いは変わらない。急いで書き足すより、どちらを取るかを社内で決めるほうが先だ。
- Google-Extended
- GoogleがAI学習を断る印としてrobots.txtで使う名前。Geminiアプリの回答で引用されるかどうかにも効く
- IETF
- インターネットの技術の決まりを作る国際的な団体。今回の書き方はその中の作業部会の議論から出た草案
※記事の事実とは分けて、筆者の考えを書いています。
分析・考察情報システム部門や広報がつまずきそうなのは、断る理由が学習なのか引用なのかを社内で決めていないことだ。共通の1行は手軽なぶん、深く考えずに足される可能性がある。
Googleが対応する2027年までに、自社の記事をAIの回答で紹介されたいかを決めておきたい。製品ページは許して有料の記事だけ断るように、道ごとに分けて書く会社が増えるとみている。
- robots.txtに共通の1行を書けばすぐAI学習は止まる?
- すぐには止まらない。4社のうち読み始めたのはAnthropicだけで、OpenAIは数か月のうちに対応するとしたが日付は出していない。Microsoftは2027年2月1日から、Googleは2027年の対応を目指している。断れるのは学習に使うことで、クローラーが読みに来ることは止めない。すでに集められた文章も消えない。
- Googleの学習だけ断ってGeminiの引用は残せる?
- いまのGoogleの説明では分けられない。共通の1行で断ってGoogle-Extendedを書いていないと、GoogleはGoogle-Extendedを止めたのと同じに扱う。Google-ExtendedはGeminiアプリの回答で引用されるかどうかにも効くので、引用からも外れる。引用を残したいならGoogle-Extendedを許す行を別に書くことになり、そのときGoogleの学習も許す形になる。
- BingやCopilotでは学習と引用を別に決められる?
- 別に決められる。Microsoftは共通の1行で学習を断ったまま、ページごとの設定で引用を許せる。DisallowExtendedを選ぶと、Copilotなど自社の製品の回答には出しつつ、他社に提供する引用の仕組みからは外せる。Microsoftがこの設定を読み始めるのは2027年2月1日からだ。
- 日本のサイトはもう共通の1行を書いている?
- まだほとんど書いていない。AInformationが11月9日に国内のニュースサイトや大手サービス21件のrobots.txtを見たところ、共通の1行があったのはクックパッドの1件だけだった。一方でGoogle-Extendedをサイト全体で止めていたのは8件あり、朝日新聞や日本経済新聞、NHKなどが入っていた。
【この記事の出典】
- TechRadar(この記事の元にした報道)補助資料・2026年11月9日に確認