GoogleでフォローするGoogle検索でAInformationの記事が出やすくなります
Inkling 2 Smallは594B 動くのは17Bだけ
OpenAIの元CTOのミラ・ムラティ氏が作ったThinking Machines Labは、米国時間の11月5日にAIモデル「Inkling 2 Small」を発表した。中身はMoEと呼ばれる作りで、全体は5940億パラメーターだが1回の処理で動くのは170億だけになる。文字と画像を読み、答えは文字で返す。
総合点も大きく伸びた。Artificial Analysis Intelligence Indexでは31点で、Gemini 3.8 Flashと並んだ。前の世代は13点だった。デザインの出来を比べるDesignArenaでは、GPT-6.1 Solを上回ったという。
重みの配り方は2段になる。いまはThinking Machines Labの学習基盤「Tinker」の上でだけ動かせる。外部の安全テストが終わったあと、来週にApache 2.0で重みを公開する予定だ。公開されれば中国以外の会社のオープンモデルで最も高い性能になる、とGIGAZINEは伝えている。
- 11/5Thinking Machines LabがInkling 2 Smallを発表
- 11/5Tinkerで推論と追加学習を始める
- 11月第2週安全テストの後にApache 2.0で重みを公開予定
出力100万トークン1ドル DeepSeekの3.6ドルより安い
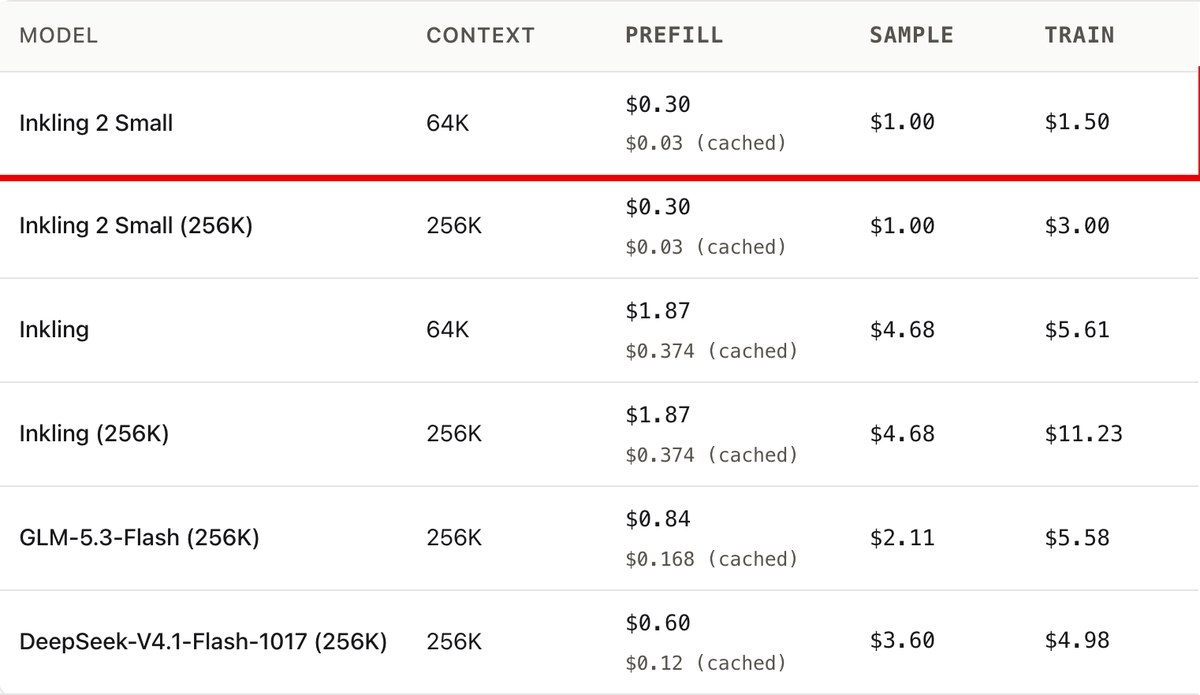
Tinkerの料金表では、Inkling 2 Smallの単価は100万トークンあたり入力0.30ドル・出力1.00ドルだ。1ドル158.46円(11月5日)で直すと、入力は約48円で出力は約158円になる。自社のデータで追加学習させる単価は1.50ドルだ。
同じ表に並ぶ競合と比べると差ははっきりしている。発表で比べられたDeepSeek-V4.1-Flash-1017は出力3.60ドルで約570円かかる。Inkling 2 Smallの出力単価はその27.8%で、3割に届かない。
| モデル(Tinker) | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| Inkling 2 Small | 0.30ドル | 1.00ドル |
| DeepSeek-V4.1-Flash-1017 | 0.60ドル | 3.60ドル |
| GLM-5.3-Flash | 0.84ドル | 2.11ドル |
| Inkling(前の世代) | 1.87ドル | 4.68ドル |
表はTinkerの公式料金ページの数字を写した(11月6日時点)。前の世代のInklingの出力4.68ドルからも大きく下がった。
コーディングの点はDeepSeekが上 Inklingは安さで戦う
点数だけならDeepSeek-V4.1-Flash-1017のほうが上の項目が多い。公式の比較表では、DeepSWEは72.1%対77.0%、Vibe Code Benchは81.6%対87.7%でDeepSeekが勝った。同じ表でKimi K3は85.0%だった。Muse Spark Openは76.2%でGLM-5.3-Flashは30.8%にとどまる。Inkling 2 Smallは多くの項目で2番手に入っている。
GPUの処理を速くする課題(69問)では、10時間で解けた数がGPT-6 Astraの63問に対し54.25問だった。Claude Opus 5.5の60問にも届いていない。
強みとして押し出しているのは、追加学習の伸びやすさだ。Tinkerの上でInkling 2 Smallに小さなモデルの学習を任せた例がある。4時間17分で426ドル(約67,504円)を使い、予測の誤差を元のモデルより約15%減らした。
日本から試すにはログインが要る 日本語の扱いは書かれていない
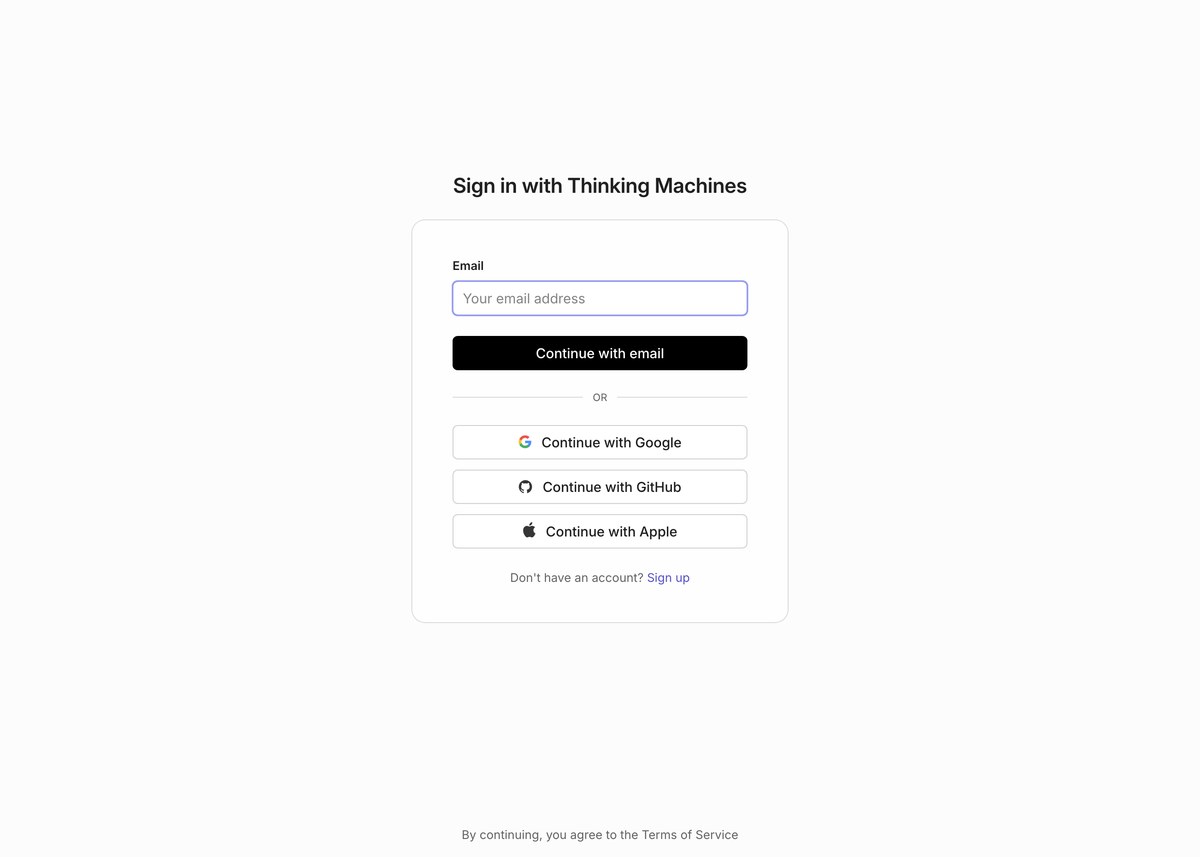
すぐ触れる入口はTinker Playgroundだ。ただしAInformationが11月6日に開くと、Thinking Machinesのログイン画面へ回された。メールかGoogle・GitHub・Appleのアカウントで登録してから使う形になる。このため11月6日の時点で、AInformationはInkling 2 Smallに質問を投げて試すことはできなかった。
モデルカードの対応言語は「英語と一般的な多言語対応」とあるだけで、日本語の名前は出てこない。読める長さもモデルカードは最大100万トークンとしているが、Tinkerで選べるのは6.4万と25.6万トークンの2つだった。
弱みも公式が自分で挙げている。チャットの受け答えは磨き込みが足りず、整理が下手でスラッシュを使いすぎるという。音声も読めない。社内で使うなら、まずTinkerで自社の日本語の資料を数本読ませて答えの質を見ておきたい。来週の重みの公開後は手元のサーバーでも動かせるので、オープンモデルを探している会社は比べる候補が1つ増える。
- MoE
- 質問ごとに中の専門家の一部だけを動かす作り。全体は大きくても1回の計算は軽く済み、単価を抑えやすい
- Tinker
- Thinking Machines Labの学習基盤。オープンモデルの追加学習と推論をAPIで動かせ、トークン単位で料金がかかる
企業の導入で見ると、この安さが効くのは自社データで追加学習したい会社だ。出力の単価が1ドルなら、社内文書の要約を大量に回しても請求は読みやすい。一方で日本語の対応が明記されておらず、チャットの受け答えも弱いと公式が認めている。窓口の自動応答にそのまま使うより、情報システム部門が社内の日本語資料で答えの質を測ってから、要約や分類の裏方に回すのが現実的とみている。重みが出れば社外にデータを出さずに動かせる点は、金融や医療の会社に響きそうだ。
- Inkling 2 Smallはいくらで使える?
- Tinkerでは100万トークンあたり入力0.30ドル・出力1.00ドルだ。1ドル158.46円で直すと入力は約48円で出力は約158円になる。追加学習は6.4万トークン版で1.50ドルかかる。比べられたDeepSeek-V4.1-Flash-1017の出力は3.60ドルなので、出力単価はその3割に届かない。
- Inkling 2 Smallは無料で試せる?
- 無料の枠は料金表に書かれていない。入口のTinker Playgroundは、AInformationが11月6日に開くとログイン画面へ回された。メールかGoogle・GitHub・Appleで登録してから使う形だ。来週にApache 2.0で重みが公開されれば、自分のサーバーで動かす道もできる。
- Inkling 2 Smallは日本語に対応している?
- 日本語の対応ははっきり書かれていない。モデルカードの言語の欄は「英語と一般的な多言語対応」だけだ。公式はチャットの受け答えが磨き込み不足だとも認めている。社内で使う前に自社の日本語の資料で答えの質を試しておくとよい。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年11月6日