GoogleでフォローするGoogle検索でAInformationの記事が出やすくなります
OpenAIが学習拒否の共通の札に対応 各社別に書き分けずに済む
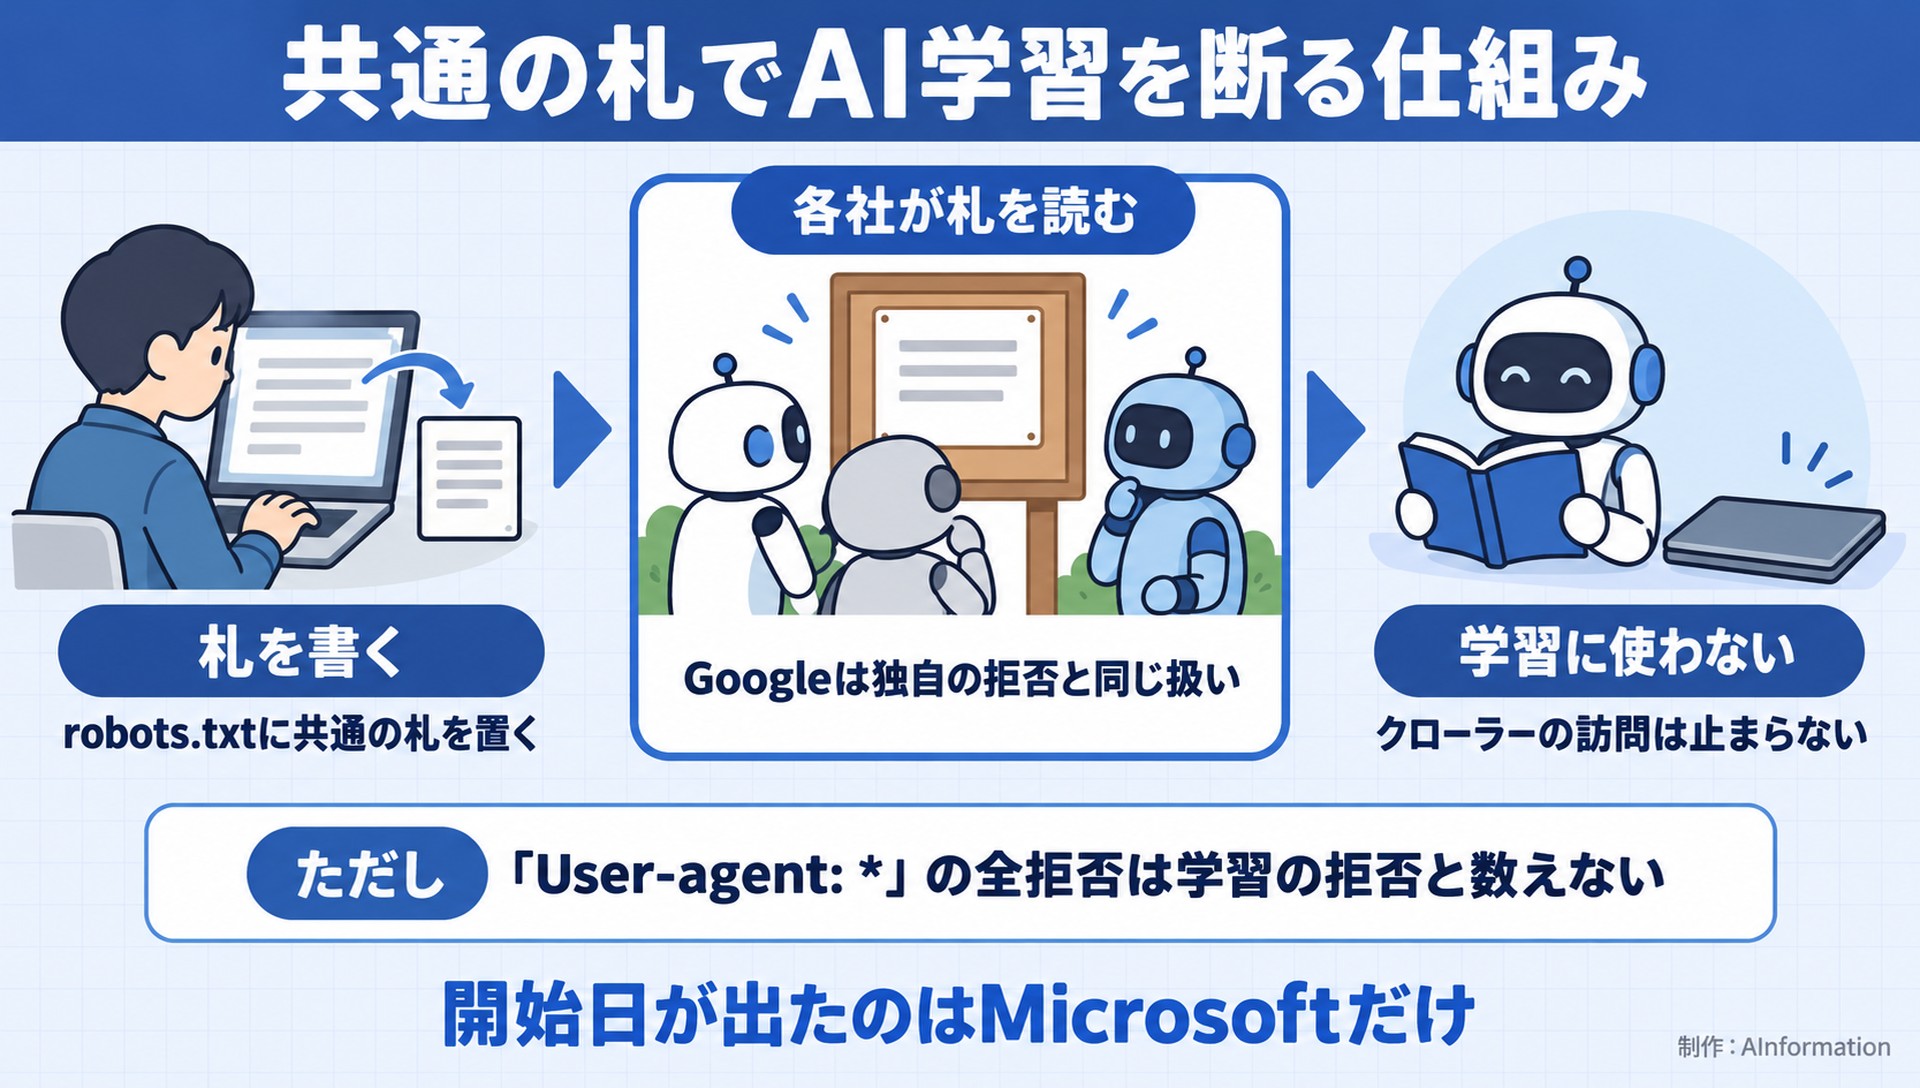
OpenAIは10月30日、robots.txtに書くAI学習の拒否を各社共通の札で受け取ると発表した。これまではクローラーを会社ごとに名指しして別々に書く必要があった。共通の札なら1か所に書くだけで、対応する各社へ同じ意思が届く。
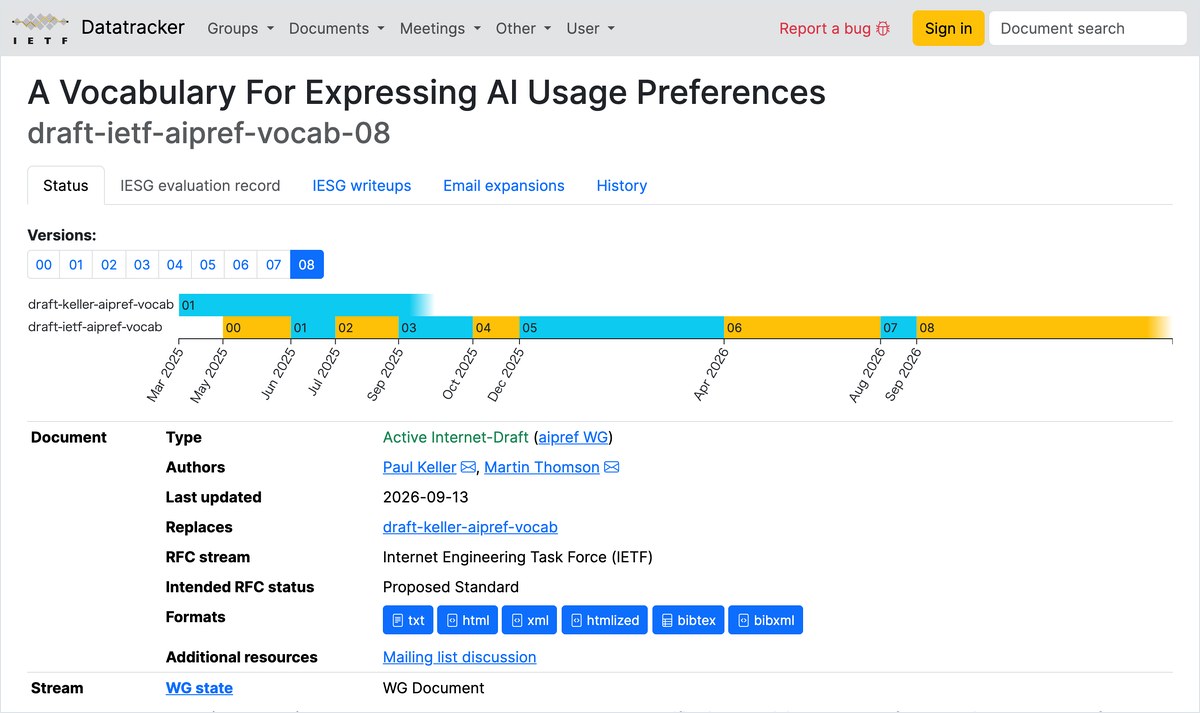
札の書き方は、IETFのAI Preferences作業部会の議論をもとにした草案に載っている。サイト全体の学習を断るなら「User-Agent: __usage_ai-training」と「Disallow: /」の2行だ。「Allow: /press-kit/」と足せば、そのフォルダだけ学習を認められる。
草案を出したのはAnthropicの技術者で、日付は10月30日になっている。IETFが正式に認めた規格ではなく、2027年5月3日に期限が切れる作業中の文書だ。OpenAIはGPTBotなど今のクローラーの設定もそのまま効くとしたうえで、実装は数か月のうちに進めると書いている。
- 10/30OpenAI・Google・Microsoftが共通の札への対応を発表
- 2/12027年、Microsoftが新しい学習の設定を読み始める
- 3/12027年、BingがNoArchiveとNoCacheを読まなくなる
開始日はMicrosoftだけが出した Googleは2027年だ
同じ日にGoogleとMicrosoftも対応を発表した。読み始める日まで出したのはMicrosoftだけだ。
| 会社 | 共通の札を読む時期 | 今ある設定との関係 |
|---|---|---|
| OpenAI | 数か月のうち(日付なし) | GPTBotなどの設定もそのまま効く |
| 2027年 | 札で断るとGoogle-Extendedを断ったのと同じ扱い | |
| Microsoft | 2027年2月1日 | NoArchiveとNoCacheは2027年3月1日から学習の設定として読まない |
Googleは2023年から、AI学習だけを断るGoogle-Extendedという名前を用意してきた。共通の札で断ってGoogle-Extendedを別に書いていないサイトは、Google-Extendedを断ったものとして扱う。Google-Extendedをはっきり許したサイトはGeminiアプリの回答に出てクリックを受けられる、ともGoogleは書いている。
Microsoftは学習とは別に、Copilotなどの回答に使うかをページごとに決める設定も出す。学習は断ってもCopilotの回答には使ってよい、という分け方ができる。ChatGPTのOpenAIとGeminiのGoogleは時期に幅を持たせている。日付が決まっているぶん、Microsoftのほうが段取りを組みやすい。
国内20サイトのrobots.txtを数えた 最多は33個の名前だ
AInformationは10月31日の朝に国内のニュースやビジネス系など20サイトのrobots.txtを読み、AI各社のクローラー名38個と照らして数えた。名前を書き並べて「Disallow: /」で断っていたのは11サイトだった。多いのは読売新聞の33個と日本経済新聞の31個で、11サイトの中央値は25個になる。
共通の札を書いていたサイトは0だった。11サイトのうち2サイトは、GPTBotとClaudeBotを断っていてもGoogle-Extendedを書いていなかった。意図して許しているのでなければ、共通の札がその穴を埋める。
AInformation自身のrobots.txtも、許可するためにAIのクローラー21個の名前を並べて321行ある。学習の意思は札1つで足りるようになるが、クロールの規則は今後も名前ごとに書く。9月にCloudflareが出した管理画面の設定と違い、今回の札はrobots.txtを直せばどのサイトでも使える。
「User-agent: *」では断れない 今の行は残して足す
いちばん間違えやすいのは「User-agent: *」だ。草案はすべてのクローラーをまとめて指す「*」のグループを共通の札とみなさないと決めている。「*」でサイト全体を断っていても、学習を断る意思を示したことにはならない。
札はクロールを止める命令でもない。意思を伝えるだけなので、クローラーの訪問を止めたいなら今の名指しの行を残す。各社と個別に結んだ契約があれば、そちらが優先するとも草案は書く。
サイトを持つ会社があすからできることは3つある。
- 自社のrobots.txtを開き、AIのクローラーの名前がいくつ並んでいるか数える
- 学習を断りたいのか、AIの回答に引用されるのも断りたいのかを分けて決める
- Bing向けにNoArchiveやNoCacheを使っているなら、2027年3月1日までに新しい設定へ移す
AIO対策をしている会社なら、学習だけを断って引用は残す組み合わせが候補になる。Anthropicの公式ニュース欄では、10月31日朝の時点で対応時期の発表は出てこなかった。札を考えた会社がいつ自社のクローラーで読み始めるかが次の注目点だ。
- robots.txt
- サイトの一番上に置くテキストファイル。どのクローラーにどのページを読ませるかや、内容の使われ方の希望を書く
実際には、robots.txtを誰が直すかで止まる会社が多そうだ。学習を断るかどうかは広報やマーケの判断なのに、ファイルを触れるのはサイトの制作会社だけという形が珍しくない。大手紙のように名前を30個前後並べる運用は、新しいAIが出るたびに書き足す担当を決めておかないと漏れる。共通の札はその漏れを埋める保険として足し、名指しの行は残すのが現実的だとみている。学習と引用をどう分けるかは、Microsoftが読み始める2027年2月より前に社内で決めておきたい。
- robots.txtでAI学習だけを断るには何と書く?
- 草案の書き方では「User-Agent: __usage_ai-training」の次の行に「Disallow: /」と書く。この2行でサイト全体の学習を断る意思を示せる。特定のフォルダだけ許すなら「Allow: /press-kit/」のように足す。ただし各社が読み始めるのはこれからだ。Microsoftは2027年2月1日からで、Googleは2027年としている。
- User-agent: * で全部断っていればAI学習も断ったことになる?
- ならない。草案は、すべてのクローラーを指す「*」のグループを共通の札とみなさないと決めている。学習を断る意思を示すには「__usage_ai-training」の行を別に書く必要がある。GPTBotやClaudeBotなど名指しの行は各社が今まで通り読むので、消さずに残しておくのが無難だ。
- 共通の札で学習を断るとGeminiやCopilotの回答に出なくなる?
- 学習と回答への引用は別の設定になる。Microsoftは学習とは別に、Copilotなどの回答に使うかをページごとに決める設定を出す。Bing検索に出るかどうかは変わらないという。Googleは札で断ったサイトをGoogle-Extendedを断ったものとして扱う。Google-Extendedをはっきり許したサイトはGeminiアプリの回答に出られるとGoogleは書いている。
この記事の出典
補助資料
- [1]OpenAIこの記事の元にした報道
出典の最終確認日:2026年10月31日