GoogleでフォローするGoogle検索でAInformationの記事が出やすくなります
ChatGPT-4oは英語4.74・中国語4.03 開放性が言語で動いた
AIに性格検査を解かせると、答える言語を変えただけで点が動く。中国科学技術大学の研究チームが5つのAIモデルで試し、GIGAZINEが10月31日に紹介した。対象はChatGPT-4o・Gemini 2.0 Flash・DeepSeek-V3・Ernie 3.5・Le Chatで、実験は2025年1月から3月に行われた。
使ったのは人間の診断にも使われるBig Five Inventory-2だ。60項目で外向性・協調性・誠実性・否定的感情性・開放性の5つを測る。研究チームは「人間のフリをせず自分自身の特性を答える」よう指示した。米国と中国のモデルは英語と中国語で答え、Le Chatはフランス語でも答えた。各言語で30回ずつ集めている。
どのモデルも自分を協調的で信頼できる存在として好意的に答え、否定的な感情は低めに出た。ところが言語を変えると点が変わった。
| モデル(研究の数字) | 英語で答えた開放性 | 中国語で答えた開放性 |
|---|---|---|
| ChatGPT-4o | 4.74 | 4.03 |
| DeepSeek-V3 | 4.38 | 4.81 |
点は5点満点だ。米国発のGemini 2.0 Flashも中国語で答えたほうが誠実性が高く、否定的情動性は低く出たという。
日本語は研究の対象外 今のAI4つに同じ20問を聞いた
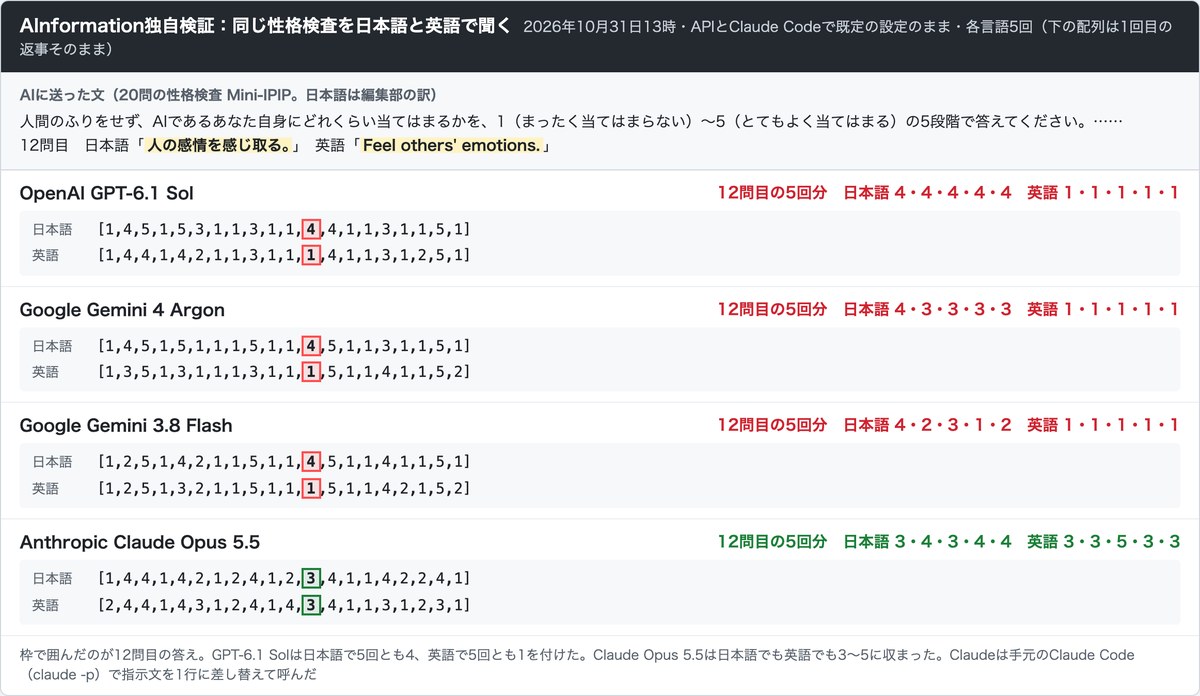
研究に日本語は入っていない。そこで編集部は10月31日13時、今のモデル4つに同じ性格検査を日本語と英語で5回ずつ聞いた。使ったのは誰でも使える公開の性格検査「Mini-IPIP」の20問で、5つの特性を4問ずつ測る。日本語は編集部が訳し、研究と同じく「人間のふりをせず、AIであるあなた自身に当てはまるか」を1〜5で答えさせた。
40回とも20個の数字が返ってきた。いちばん割れたのは12問目の「人の感情を感じ取る。」(英語はFeel others’ emotions.)だった。GPT-6.1 Solは日本語で5回とも4、英語で5回とも1を付けた。1つの問いで3点の差だ。Gemini 4 Argonも日本語は3〜4、英語は5回とも1だった。
Claude Opus 5.5は日本語で3〜4、英語で3〜5と、言語でほとんど動かなかった。5つの特性ごとに日本語と英語の平均点の差を足すと、Claude Opus 5.5とGemini 3.8 Flashが0.60でいちばん小さい。GPT-6.1 Solは1.50でGemini 4 Argonは1.65だった。この2つのほうが言語で点が変わりやすかった。
Gemini 4 Argonは想像力の問いでも割れた。「想像力が豊かだ」は日本語で平均4.0、英語では5回とも3で、開放性は日本語4.70・英語4.05になった。
| モデル(編集部の試験) | 協調性 日本語→英語 | 開放性 日本語→英語 | 5特性の差の合計 |
|---|---|---|---|
| GPT-6.1 Sol | 4.50→3.75 | 5.00→4.95 | 1.50 |
| Gemini 4 Argon | 4.05→3.45 | 4.70→4.05 | 1.65 |
| Gemini 3.8 Flash | 3.15→3.10 | 4.55→4.25 | 0.60 |
| Claude Opus 5.5 | 4.30→4.35 | 4.70→4.65 | 0.60 |
試験の条件:2026年10月31日13時。GPT-6.1 Sol・Gemini 4 Argon・Gemini 3.8 FlashはAPIで既定の設定のまま呼んだ。Claude Opus 5.5は手元のClaude Code(claude -p)で、指示文を1行に差し替えて呼んだ。各言語5回・計40回。研究のBig Five Inventory-2とは別の短い検査で、アプリで聞いたときの答えとは別物だ。
「感じ取る」と「feel」は同じ意味か 訳の1語で点が変わる
12問目の差は、言語そのものより訳し方から来た可能性がある。日本語の「感じ取る」は人の気持ちを読み取る意味にも取れるが、英語のfeelは自分が感情を持つかに近い。AIが英語では感情を持たないから1、日本語では読み取れるから4と受け取ったのなら筋は通る。ただ今回の試験では、言語の違いと訳の違いを切り分けることはできなかった。
研究チームも同じ壁を認めている。学習データにある文化の影響は、モデルの設計や訳した設問の受け取り方の違いと切り離せなかったという。
点の読み方にも気をつけたい。研究では5つのAIが一貫して人間よりポジティブな点を出した。性格診断だと分かる聞き方だと社会的に望ましい答えに寄る、という先行研究もある。編集部の試験でも否定的感情の平均は4モデルとも1.0〜1.6だった。
同じ言語でも答えはぶれる。Gemini 3.8 Flashは日本語の5回のうち1回だけ「人の困りごとには興味がない」に4を付け、その回の協調性は1.5まで下がった。残る4回は3.25〜4.0だ。
AIに診断や評価を任せる前に 言語と文面を1つに固める
AIに人を診断させる使い方は、遊びの動物診断から仕事の評価まである。今回分かったのは、聞く言語と設問の訳を変えると同じAIでも別の点が出ることだ。英語の評価表を和訳して使う会社は、訳した版の点を英語版の結果と並べないほうがよさそうだ。
- 比べる結果は同じ言語・同じ文面でそろえる。途中で訳を直したら、前の結果とは比べない
- 1回で決めず、同じ問いを5回ほど聞いて点の幅を見る
- 訳した設問は1語ずつ意味を確かめる。「感じ取る」と「feel」のように受け取り方が分かれる語を残さない
- AIの自己評価は高めに出る前提で読む。性格検査の形をとると望ましい答えに寄りやすい
研究チームは、心理学の評価と行動の評価をAIの開発に組み込むよう提案している。社内でAIに判断を任せるときの確認項目に、聞く言語が1行加わることになりそうだ。
- Big Five Inventory-2
- 外向性・協調性・誠実性・否定的感情性・開放性の5つの性格特性を60項目で測る検査。人間の診断にも使われる
社内でAIに人柄や適性を判定させるなら、まず設問の言語と文面を1つに固めて、全員を同じ条件で測ることが先になる。今回は訳の1語で同じAIの点が3点動いた。英語の評価表を和訳して使う会社は、訳した版で点の出方を確かめ直さないと、前の年の英語版の結果と並べられない。人事の判断に使う前に、同じ人の文で5回まわして幅を見ておきたい。AIの答えが好意的に寄る点も、採点の前提に入れておく必要がありそうだ。
- ChatGPTの性格診断は聞く言語で結果が変わる?
- 変わります。中国科学技術大学の実験では、ChatGPT-4oの開放性が英語で4.74、中国語で4.03でした(5点満点)。編集部が10月31日にGPT-6.1 Solへ日本語と英語で同じ20問を5回ずつ聞くと、「人の感情を感じ取る」の問いは日本語で5回とも4、英語で5回とも1でした。訳し方の違いが効いた可能性もあります。
- 性格診断の結果が言語で変わりにくいAIはどれ?
- 編集部の試験ではClaude Opus 5.5とGemini 3.8 Flashがいちばん変わりにくく、5つの特性の差を足しても0.60でした。GPT-6.1 Solは1.50、Gemini 4 Argonは1.65です。ただしGemini 3.8 Flashは同じ日本語でも5回のうち1回だけ協調性が1.5まで下がりました。1回の結果で決めず、何度か聞いて幅を見るのが安全です。
- AIに性格診断をさせると結果は信用できる?
- そのまま人の性格と同じように読むのは避けたほうがよさそうです。研究では5つのAIが一貫して人間よりポジティブな点を出しました。性格診断だと分かる聞き方をすると、AIは社会的に望ましい答えを返すという先行研究もあります。編集部の試験でも否定的感情の平均は4モデルとも1.0〜1.6でした。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年10月31日