GoogleでフォローするGoogle検索でAInformationの記事が出やすくなります
アルトマン氏「PCに大量のDRAMは問題」 使われるのは時間の5%
OpenAIのサム・アルトマンCEOは、個人のPCが大量のメモリーを抱えるのは世界の資源の使い方として問題だと語った。Stripe共同創業者のジョン・コリソン氏のポッドキャスト番組での発言で、テクノエッジが10月31日に伝えた。話題がローカルAIの広がりでデータセンターへの依存が減るかどうかに移ったときに出た。
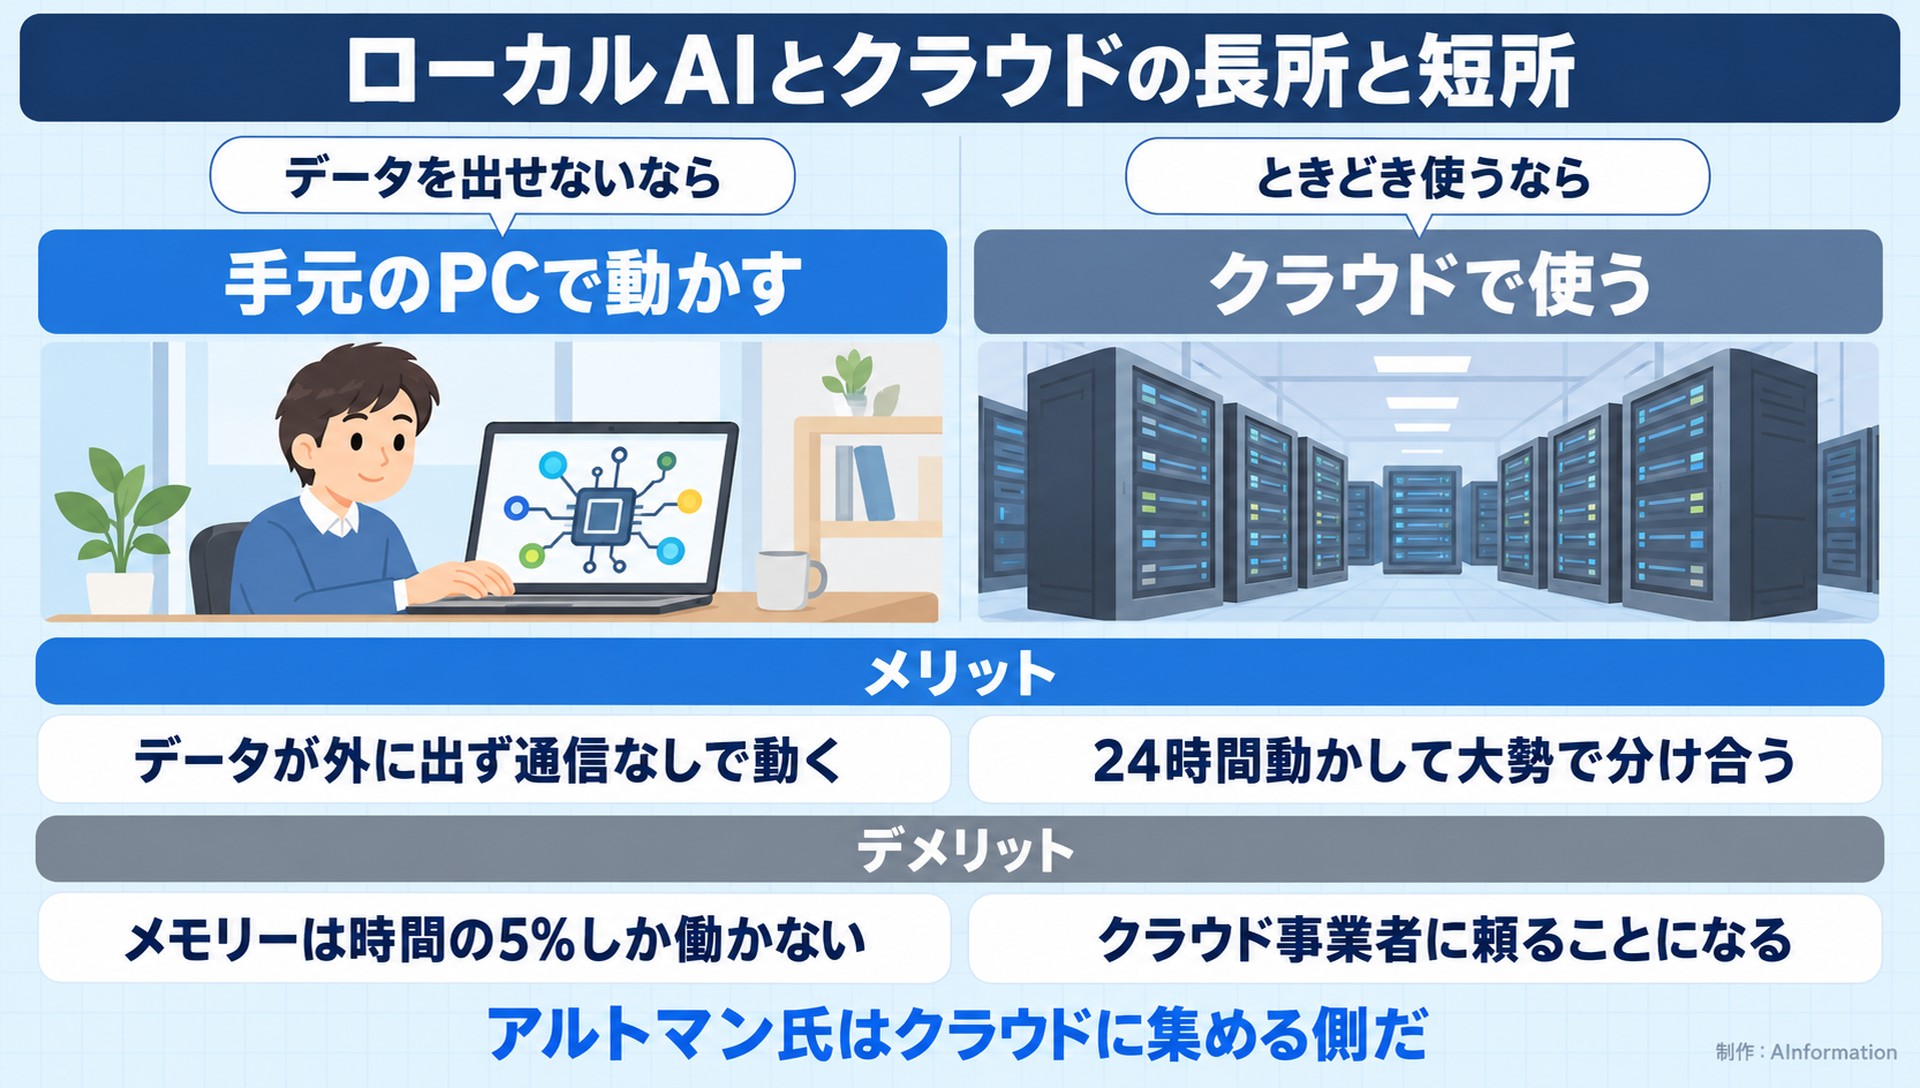
根拠はメモリーの使われ方だ。世界中の人が限られたDRAMを自分のPCに大量に抱え込み、そのメモリーは時間全体でわずか5%しか使われないという。それならデータセンターに集めて24時間止めずに動かし、大勢で分けて使うほうが限られた資源を生かせるという。
同氏は、多くの人がローカル推論を望むのは「そうなればDRAMの供給不足の問題は解決されると思い込んでいるからだ」とも述べた。番組はYouTubeで公開されている。
ローカルAIを求める声は強い Mac Studioは品薄になった
アルトマン氏自身も、ローカル推論を求める人が多いと認めている。公開モデルの性能が上がり、モデルを自分のPCに落として推論させる使い方が広がった。その実行環境として大容量のユニファイドメモリーを積んだMac Studioの人気が急に高まり、アップルの供給が追いつかない事態も起きた。
AIの推論ではモデルの重みだけでなく、処理中のデータやkey-value cacheにもメモリーが要る。大きなモデルや複数のエージェントを並べて動かすほど、容量と帯域幅が効いてくる。
ローカルAIの利点として、テクノエッジはプライバシーの守りやすさ・通信の遅れの少なさ・ネットなしでも動く点・クラウド事業者に頼らずに済む点を挙げる。一方でローカルLLMのためにPCを使う人はまだ少数派だともみている。OpenAIの事業の柱はデータセンターで動くクローズドなモデルで、同記事は今の形を守りたいのは当然かもしれないと書いている。
4Bの公開モデル2つを手元で測った結果
| 項目 | Gemma 3 4B | Qwen3 4B |
|---|---|---|
| 使ったメモリー | 2.33GB | 3.18GB |
| 5問の計算時間 | 18.18秒(読み込みを含む) | 23.84秒(読み込みを含む) |
| 日本語で答えた数 | 5問中5問 | 5問中0問 |
| 答え終えたあと | 5分間メモリーを持ち続けた | 5分間メモリーを持ち続けた |
| 目立った誤り | 1,400円の12か月分を17,600と答えた | 英語の考えごとだけで終わった |
編集部のMacで4Bを2つ測る 計算した時間は5.7%だった
手元で測ると、メモリーを抱えていた時間のうち計算に使ったのは5.7%だった。編集部は11月1日未明に24GBのMac(MacBook Pro・M4 Pro)へ無料のOllama 0.40.6を入れた。4ビットに縮めた4Bの公開モデル2つに、仕事の質問を5問ずつ続けて聞いた。質問は議事録の要約のコツ・お詫びメールの書き出し・料金の計算・Excelの重複探し・敬語への直しの5つだ。
Gemma 3 4Bは読み込みを含めて5問を18.18秒で答え、メモリーは2.33GBを使った。Ollamaは既定の設定だと、答え終えたあとも5分間モデルを読み込んだままにする。読み込みから手放すまでの318秒のうち、計算していたのは18.18秒だけだった。
続けて聞くほど割合は上がり、1問だけ聞いて離れれば下がる。2つ目のモデルを読み込んでも1つ目は降ろされず、Qwen3 4Bの3.18GBと合わせて5.51GBを同時に抱えていた。使い終えたらすぐ空ける作りではない。
Qwen3 4Bは日本語の答えが出てこなかった
Qwen3 4Bは3.18GBを使って5問に23.84秒をかけ、5問とも英語で考えごとを始めた。考えを切る指定を2通り試し、出力を800トークンまで広げても日本語の答えは出てこなかった。小さなモデルは入れても思った形で答えるとは限らない。
日本語で答えたGemma 3 4Bにも誤りがあった。「月額1,400円のサービスを12か月使うと合計いくらか」には17,600と返したが、正しくは16,800円だ。「重複した行を見つける方法」には、見つける手順ではなく消す手順を答えた。
ローカルかクラウドか 決め手は社外に出せない資料の量
どちらを選ぶかは、社外に出せない資料をどれだけAIに読ませたいかで決まる。議事録や顧客の資料を外に出せないなら、手元で動かす意味は大きい。ときどき相談する程度なら、メモリーを積んだPCを用意するより月額のクラウドで足りる人が多そうだ。
クラウド側の費用は、AInformation調べでは日本円で払えるチャットAIの有料プランが月725円から月3,200円までだ。ChatGPTのGoは月1,400円で使える。
アルトマン氏は同じ番組でデータセンターの建設・独自チップ・ロボットによる製造の自動化にも触れた。AIの需要が増え続けるなら、エネルギーや半導体の製造まで含めて供給網全体を広げる必要があるという。
手元で試すならOllamaのような無料のツールで4Bほどのモデルを1つ動かし、自分の業務の質問で金額や手順を間違えないかを先に確かめておきたい。答え終えて5分たったらメモリーが空くかも、あわせて見ておくとよい。
- ローカル推論
- AIのモデルを自分のPCに落とし、手元で答えを計算させる使い方。データを外へ送らずに済み、ネットが無くても動く
- key-value cache
- AIが答えを作る途中の計算結果をためておく場所。モデルの重みとは別にメモリーを使う
社内でローカルAIを検討する会社は、たいてい「データを外に出したくない」が出発点だ。ただ今回の手元の試しのように、4Bほどの小さなモデルは掛け算や手順の読み取りで平気で間違える。情報システム部門は、ローカルで扱う業務を要約や下書きに絞っておきたい。金額や数字が絡む業務はクラウドの大きなモデルか人の確認に回す線を先に引かないと、高いメモリーを積んだPCが使われないまま並ぶことになりそうだ。
- ローカルAIはどれくらいメモリーを使う?
- 4Bの小さなモデルでも2〜3GBを使う。編集部が24GBのMacで測るとGemma 3 4Bは2.33GB、Qwen3 4Bは3.18GBだった。2つを続けて読み込むと前のモデルは降ろされず、合わせて5.51GBを同時に持っていた。Ollamaの既定の設定では答え終えたあとも5分間メモリーを手放さない。
- 小さなローカルAIは仕事に使える?
- 要約や文面の下書きなら使えるが、数字と手順は人が確かめ直したほうがよい。編集部の試しではGemma 3 4Bが月額1,400円の12か月分を17,600と答えた。正しくは16,800円だ。Qwen3 4Bは英語で考え続け、5問とも日本語の答えまで届かなかった。
- クラウドのAIに払うといくらかかる?
- 日本円で払えるチャットAIの有料プランは、AInformation調べで月725円から月3,200円までだ。ChatGPTのGoは月1,400円で使える。アルトマン氏の主張どおりクラウドに寄せるなら、PCに大きなメモリーを積む代わりにこうした月額を払う形になる。
この記事の出典
補助資料
- [1]テクノエッジこの記事の元にした報道
出典の最終確認日:2026年11月1日