v0.6.0は10月5日公開 GLM-5.3-Flashに対応
ggml-orgは10月5日(現地時間)、手元のPCでLLMを動かすソフト「llama.cpp」のv0.6.0を公開した。GitHubから0円でダウンロードでき、ライセンスはMITだ。柱は新しいモデルへの対応とApple GPU向けの高速化の2つになる。
新しく動かせるのは、Zhipu AIのテキストと画像を扱う総パラメータ320Bのモデル「GLM-5.3-Flash」などだ。124Bのマルチモーダルモデル「Ling 3.0 VL」も加わり、判断モデルの「Clef」と「Nimble」にも対応した。
Qwen4Expは対応の質が上がった。MTPを使った投機的デコードで、DGX Spark上の生成速度は約1.5倍になるという。このほか多くの不具合が直り、Web UIも作り直された。
開発者向けには、トークンと埋め込みを混ぜて渡せるバッチAPI「llama_batch_ext」と「llama_process()」が入った。サーバー機能には判断モデル用の「/v1/systemone」ができた。「/v1/embeddings」は画像・音声・動画の入力を受け付け、「/v1/models」はモデルの入出力の種類を返すようになった。
- 10/5Metalの少数行カーネル(#29869)が取り込まれた
- 10/5ggml-orgがllama.cpp v0.6.0を公開
- 10/6Mac用の実行ファイルが入ったb11438が出た
Metalの約3倍はM1〜M4向け 効くのは同時生成だ
Apple GPU向けの高速化は、使い方によって効き方が変わる。Metalには投機的デコードとバッチデコード向けの少数行の行列演算カーネルが入り、行列演算は最大で約3倍速くなった。F16のKVキャッシュ向けのフラッシュアテンションも新しく実装された。
GitHubに載っている変更の説明(#29869)を読むと、新しいカーネルは2〜16行をまとめて計算する場面のためのものだ。複数の会話を同時に流すときや、下書きのトークンをまとめて確かめる投機的デコードが当たる。対象はテンソルAPIを持たないM1〜M4世代のApple GPUと書かれている。
社内で1台のMacにllama.cppのサーバーを立てて、数人で同時に使う構成なら効きやすい。逆に1人が1問ずつ聞く使い方は、この変更の狙いから外れる。
GLM-5.3-Flashの公式の重みは328.4GB
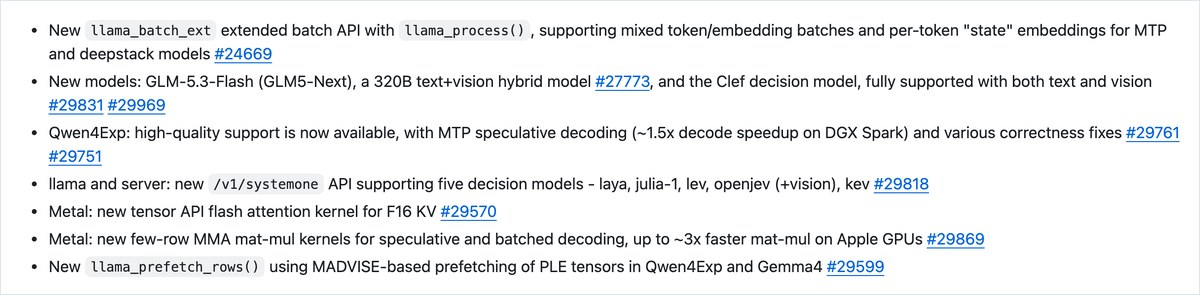
対応モデルの目玉であるGLM-5.3-Flashは、手元のMacで動かす話とは分けて考えたい。AInformationが10月6日にHugging Faceの公式の置き場を見た。1つ5.36GB前後のファイルが62個に分かれ、置き場の合計は328.4GBあった。
DGX Spark向けに公開されていた2ビットのGGUFでも84.9GBだ。編集部のMac(M4 Pro・メモリ24GB)では、GLM-5.3-Flashは試すことができなかった。動かすなら、メモリの大きい機械を別に用意することになる。
M4 Proで8本同時に生成 新版は4回とも2倍超だった
8本を同時に生成させると、新版は4回とも旧版の2倍を超える速さだった。AInformationは10月6日に編集部のM4 Proで2つの版を比べた。旧版は高速化が入る直前のb11400(0.5.0-dev)、新版はv0.6.0の後のb11438(0.6.0-dev)だ。
モデルはQwen2.5-1.5B-Instructの4ビット版(Q4_K_M・1.1GB)を使った。測り方は付属のllama-batched-benchで、128トークンを読ませてから128トークンを生成させた。新旧を交互に4回ずつ流し、生成の速さ(トークン/秒)を並べたのが次の表だ。
| 回 | 8本同時・旧版 | 8本同時・新版 | 1本・旧版 | 1本・新版 |
|---|---|---|---|---|
| 1回目 | 90.20 | 339.01 | 119.26 | 129.19 |
| 2回目 | 75.33 | 194.39 | 60.13 | 96.78 |
| 3回目 | 49.47 | 115.92 | 21.52 | 28.16 |
| 4回目 | 46.41 | 106.26 | 27.64 | 38.64 |
いちばん差が出た1回目は、90.20から339.01トークン/秒へ上がった。1本だけの生成も4回とも新版が上回ったが、差は8本同時より小さかった。測定中は同じMacで別の作業も動いていて、速さそのものは回ごとに大きく揺れている。
そのため新旧は同じ回の中で並べて比べた。1.5Bの小さいモデル1つで4回だけ測った結果で、大きなモデルでは差が変わる可能性がある。
Mac版はv0.6.0のページに無い 番号つきの版から落とす
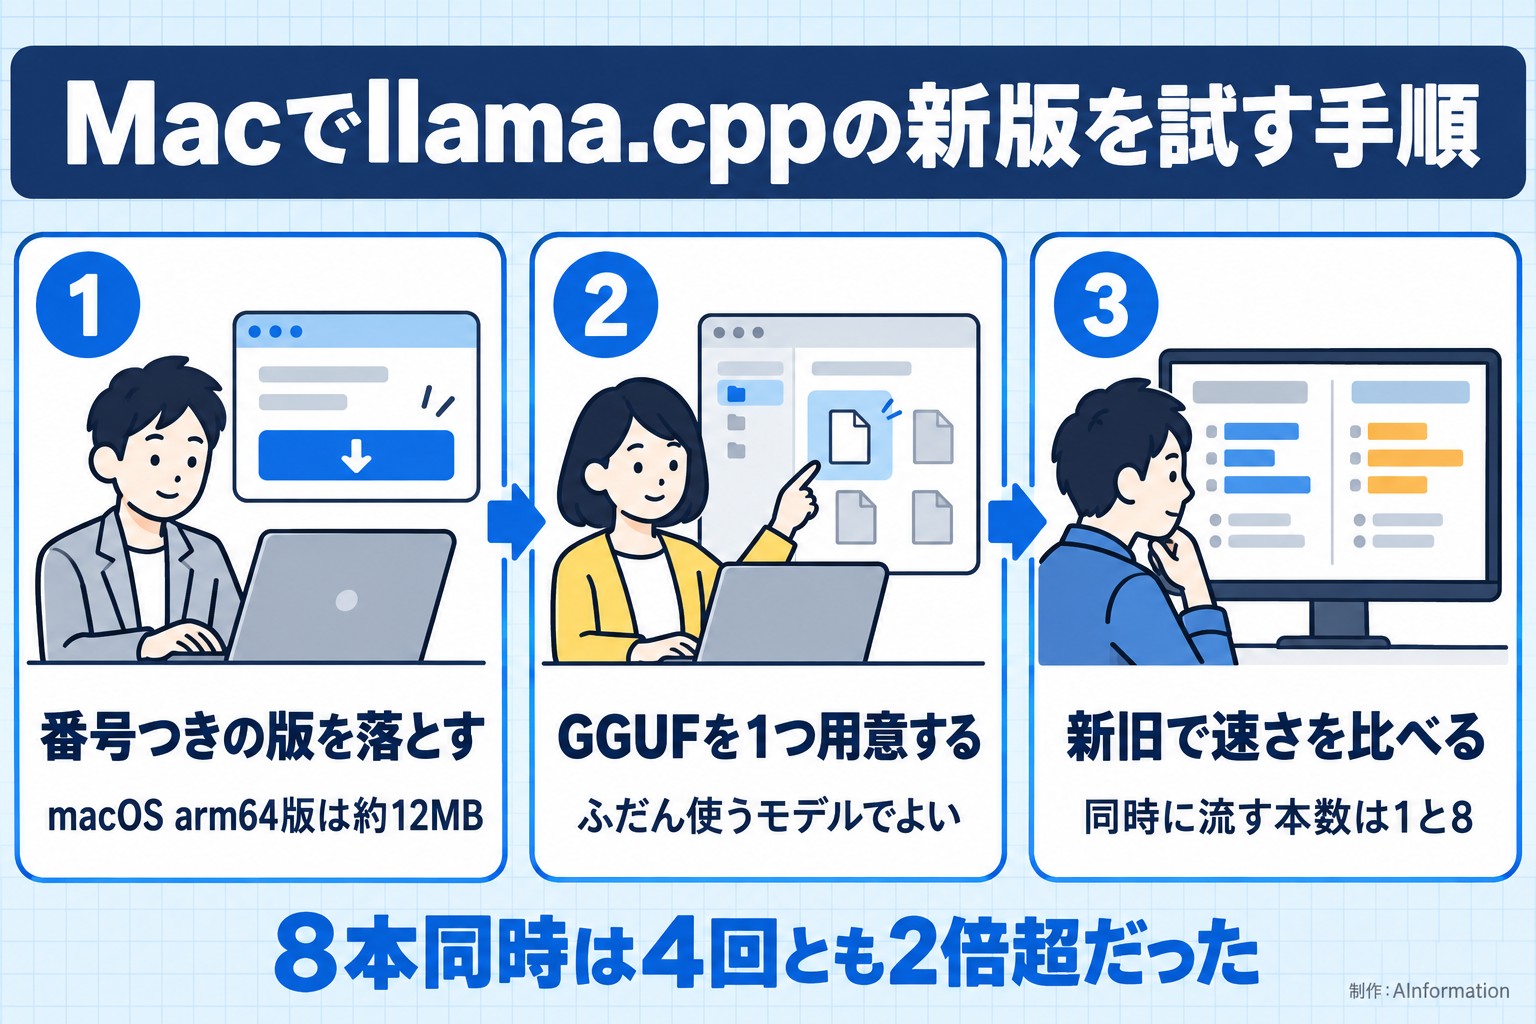
Macで試すなら、v0.6.0の公開ページではなく番号つきの版から実行ファイルを取る。10月6日時点でv0.6.0のページに付いているのは小さなテキストファイル1つだけで、Mac用の実行ファイルは無かった。b11438のページには「macOS Apple Silicon (arm64)」の版があり、約12MBだった。
試す順番は次の3つだ。
- 番号つきの版からmacOS arm64版を落として展開する
- ふだん使っているGGUFのモデルを1つ用意する
- 新旧の両方でllama-batched-benchを流し、同時に流す本数を1と8で比べる
社内のMacでサーバーを動かしているなら、まず同時に何人が使っているかを数えておきたい。同時の利用が多い職場ほど、今回の版へ上げる理由ははっきりする。
社内の文書を外へ出せない部署では、1台のMacにllama.cppのサーバーを立てて数人で使う形がある。この形なら今回の版はそのまま待ち時間の短さに出そうだ。一方で1人が1問ずつ聞くだけなら、上げても体感はあまり変わらないとみている。情報システム部門は、上げる前に同時に何人が使っているかを数えておきたい。GLM-5.3-Flashのような大型モデルへの対応は、手元のMacで動くかどうかとは別の話として切り分けたほうがよい。
- llama.cpp 0.6.0はいくらで使える?
- 0円で使える。llama.cppのv0.6.0はGitHubから無料でダウンロードでき、ライセンスはMITだ。Macで動かす実行ファイルはv0.6.0のページには付いておらず、b11438のような番号つきの版に入っている。10月6日時点でmacOS arm64版は約12MBだった。
- GLM-5.3-Flashは手元のMacで動く?
- メモリ24GBのMacでは試せなかった。llama.cpp 0.6.0はGLM-5.3-Flashに対応したが、総パラメータは320Bある。Hugging Faceの公式の置き場はファイルの合計が328.4GBで、DGX Spark向けの2ビット版でも84.9GBだった。動かすにはメモリの大きい機械が要る。
- Metalの高速化はどのMacで効く?
- テンソルAPIを持たないM1〜M4世代のApple GPUで、複数の会話を同時に流すときに効く。公式の説明では行列演算が最大で約3倍速くなる。AInformationがM4 Proで8本同時の生成を4回測ると、新版はいずれも旧版の2倍を超えた。1本ずつの生成は差が小さかった。
この記事の出典
補助資料
- [1]PC Watchこの記事の元にした報道
出典の最終確認日:2026年10月6日