GoogleでフォローするGoogle検索でAInformationの記事が出やすくなります
LifeVal公開 GPT-6 Astraは80.6%だった
OpenAIは11月2日(米国時間)に、生活の用事をAIがどこまでこなせるかを測るLifeValを発表した。新居の近くで幼稚園を選ぶ、条件に合う引っ越し先を絞る、洪水に備えて地域のボランティアを組む、といった課題が並ぶ。学校の試験のような知識ではなく、実際に用事を片づけられるかを見る物差しだ。
点はGPT-5.2が49.3%、GPT-5.4が73.0%、GPT-6 Astraが80.6%だった。OpenAIによると、GPTの版は処理にかかる時間をあまり増やさずに点を上げている。LifeValは過去1年、日常の課題でモデルの出来を追って直すためにも使ってきたという。
課題の選び方には米国の時間の使い方の調べAmerican Time Use Surveyと、国をまたいだMultinational Time Use Studyを使った。そこに3,995人へのアンケートを足して調整している。対象は子育て・介護・健康・教育・家の管理・家計・買い物・役所の手続きなどだ。
ブラウザ操作まで採点 家探しの例は100%
LifeValは答えの文章だけでなく、ブラウザやパソコンの操作とほかのサービスとの連携まで含めて採点する。OpenAIが見せた例では、家族の条件に合う家を探して不動産の譲渡税を出し、権利書をカートに入れるところまでの課題で100%だった。
| OpenAIが示した課題の例 | 点 |
|---|---|
| 家探しから譲渡税の計算・権利書をカートへ | 100% |
| 水害対策のボランティアを組む | 98.0% |
| 離れて住む家族とスポーツを見る環境づくり | 96.3% |
| 引っ越し後の幼稚園選び | 93.1% |
| 糖尿病と診断された親の世話と食事の計画 | 90.4% |
この5つはうまくいった個別の例で、ベンチマーク全体の平均ではない。全体の点は上の80.6%のほうを見る。
点はGPTだけ ClaudeとGeminiは載っていない
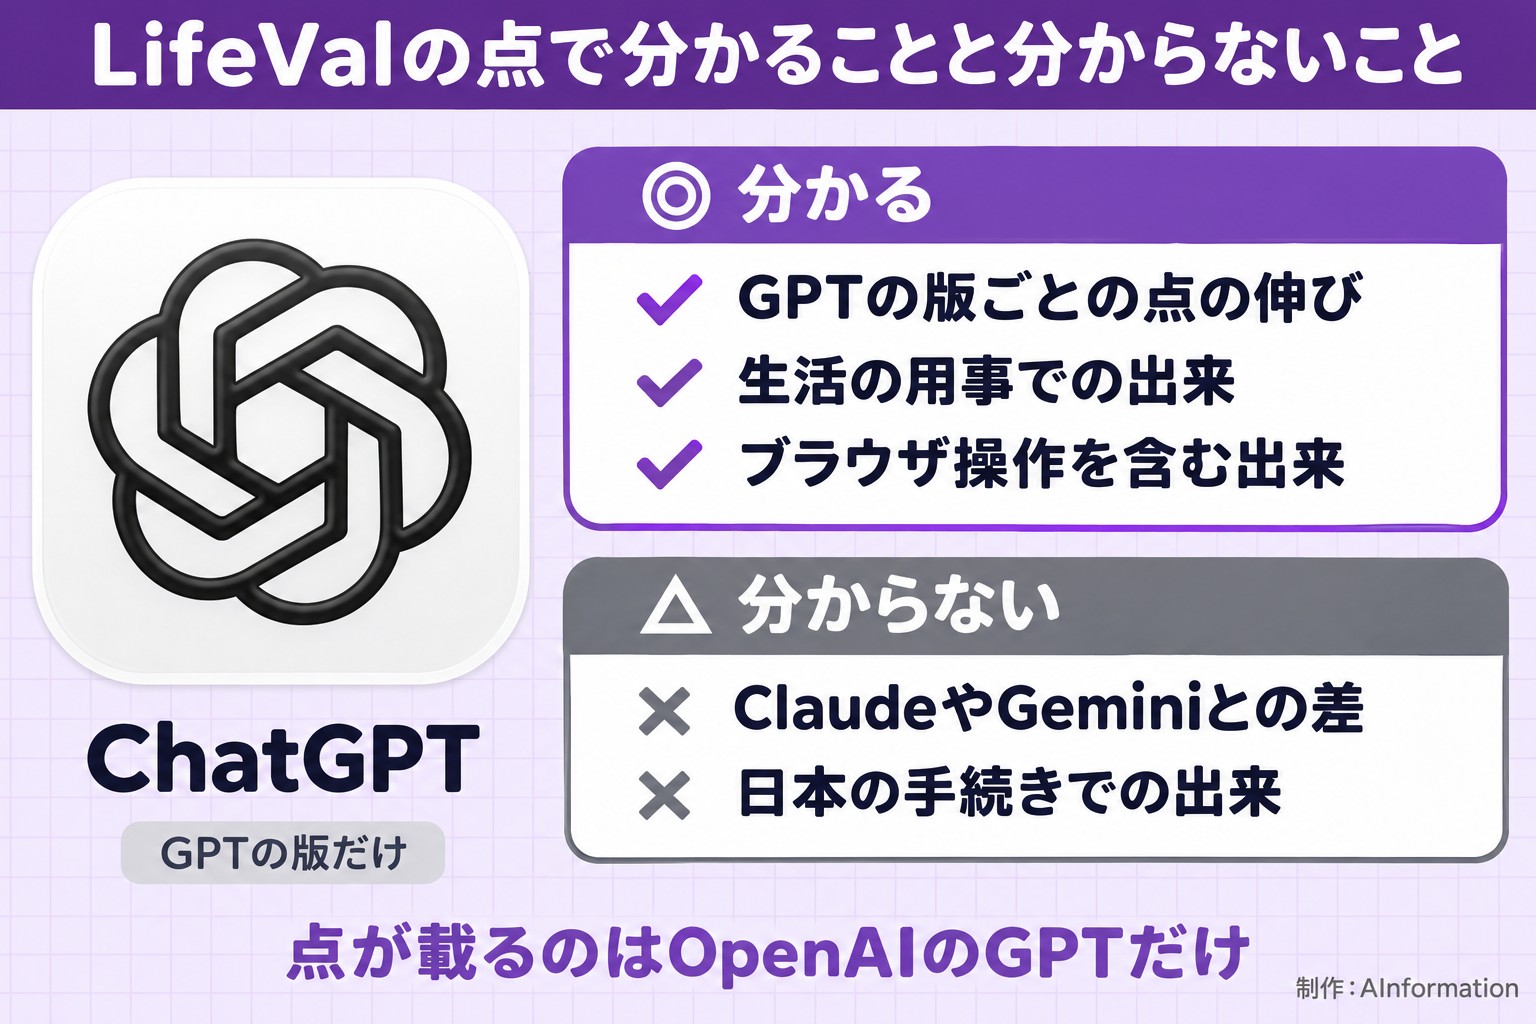
AInformationがOpenAIの報告書(PDF)を読んだところ、点が出ているのはOpenAIのGPTの版だけだった。ClaudeやGeminiは測っておらず、LifeValの点で他社のAIと比べることはできない。採点役のAIもOpenAIのモデルだ。
日本の暮らしに当てはまるかも分からない。報告書は限界として、アンケートが米国中心で英語で行われたため、米国の外でよくある用事が少なめに出ているかもしれないと書いている。日本の役所の手続きや日本語のサイトでどこまで動くかは、この点からは読み取れない。
報告書は失敗の中身も分けている。どの版でも多かったのは、個人の会話の中にある大事な情報を見落として、まちがった答えや薦めを返す失敗だった。GPT-6 Astraでは、頼まれた操作を最後までやらない失敗や、情報を確かめられないと報告して止まる失敗が増えたという。
OpenAIにはすでに、時間をかけて用事をこなしほかのアプリともつながる個人向けのAIアシスタント「Dots」がある。Business Insider Japanは、技術に詳しくない経営者がClaude Codeでは挫折したあと、Dotsにテニスの日程調整や買い物リストを任せている例を伝えた。LifeValはこうした使い方を測る物差しとして作られたとみてよさそうだ。
ChatGPTに用事を任せる前に 会話に残した条件を確かめる
生活や仕事の用事をChatGPTに任せるなら、条件を会話の中に書いたまま流さないほうがよい。LifeValでいちばん多かった失敗は、会話にある大事な情報の見落としだった。家族の人数や予算のような外せない条件は、頼むたびに指示の頭へ書き直しておくと取りこぼしが減りそうだ。
操作を伴う用事は、最後の一手を人が押す形にしておきたい。100%の例でも課題は権利書をカートに入れるところで止まっていて、支払いまでは任せていない。他社のAIと比べたいときは、OpenAIの外の物差しも見ておきたい。AndroidアプリづくりのAndroid Benchや、Microsoftが業務でAIを採点した調べでは、どのAIが上かの並びが変わる。
日本の手続きでどれだけ動くかは、日本の用事で測った物差しが出るまで自分で試して確かめるしかない。
- American Time Use Survey
- 米国の人々が1日の時間をどんな活動に使っているかを調べた調査。LifeValはこれを元に生活の課題を選んだ
企業でAIエージェントを入れる場面では、こうした点の高さがそのまま社内の説明に使われがちだ。ただLifeValは作った会社が自社のモデルだけを測り、採点もそのモデルが担っている。導入を決める担当者は、この80.6%を他社との比較の根拠にせず、自社の用事を10件ほど選んで同じ条件で投げる手間を先に取っておきたい。失敗のいちばん多い型が会話の中の条件の見落としだった点は、社内の手続きを任せるときも同じつまずきになる可能性がある。
- LifeValの点でChatGPTとClaudeやGeminiを比べられる?
- 比べられない。OpenAIが出した点はGPT-5.2の49.3%、GPT-5.4の73.0%、GPT-6 Astraの80.6%というGPTの版だけで、AnthropicのClaudeやGoogleのGeminiは載っていない。採点役もOpenAIのモデルだ。他社と比べたいときは、同じ課題を自分でそれぞれに投げて結果を見比べる必要がある。
- LifeValの課題に日本の暮らしや手続きは入っている?
- 入っているかは分からない。課題は米国の時間の使い方の調べAmerican Time Use Surveyと、国をまたいだMultinational Time Use Studyに3,995人のアンケートを足して選んだ。対象は子育てや介護・家計・役所の手続きなどだ。報告書はアンケートが米国中心で英語で行われたことを限界として挙げており、日本の役所や日本語のサイトでの出来はこの点からは読めない。
- 100%や98.0%はLifeVal全体の点なのか?
- 全体の点ではない。100%は家探しから譲渡税の計算と権利書をカートに入れるまでの課題、98.0%は水害対策のボランティアづくりなど、OpenAIが選んで見せた個別の例の点だ。全体の点はGPT-6 Astraで80.6%になる。うまくいった例だけを見て任せる範囲を広げないほうがよい。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年11月4日