| 思考トークンの中央値の減少 | 36% |
|---|---|
| highで直せなかった回数 | 160回 |
Opus 5.5の思考が11月3日に変化 1,400件の分析で判明
Claude Opus 5.5の推論が11月3日ごろから落ちた可能性があると、開発者のシェーン・メロー氏が指摘しました。Claude Codeの利用履歴約1,400件を、GoogleのGemini 4 Argonで分析した結果です。
モデル名は同じなのに、思考の文と作業の進め方が変わったといいます。分析した期間は10月9日から11月7日までで、変化は日本時間の11月4日3時ごろに出ました。作業中だった7件のセッションでも、同じ変化が見つかっています。
| 項目 | 11月3日より前 | 11月3日より後 |
|---|---|---|
| 「I’m」で始まる文の割合 | 20〜30% | 61.3% |
| 「I should」「I need to」の割合 | 約50% | 10.9% |
| ダッシュ記号の使用率 | 40〜55% | 6.5% |
| 最初の操作までの思考トークン(中央値) | 84 | 54 |
比べたのは、前の1万4,560回と後の1万4,871回のやり取りです。最初の操作までの思考トークンは約36%減り、スクリプトの実行や編集のエラーの指標は47%増えました。やり取りの40.5%では、思考トークンが出ていませんでした。
- 10/30ブラウン氏の調べで要約の切り替えが早い所で始まる
- 11/4日本時間3時ごろメロー氏の記録で思考の文が変化
highは160回でも直せずxhighは5回 費用は15分の1だった
推論の負荷を上げると、結果が大きく変わった例もあります。メロー氏は同じ音声再生の不具合を、推論の負荷「high」と「xhigh」の2つで直させました。highは約3時間かけても直せませんでした。
| 項目 | high | xhigh |
|---|---|---|
| 結果 | 直せなかった | 直った |
| やり取りの回数 | 160回 | 5回 |
| 費用 | 13ドル(約2,053円) | 0.85ドル(約134円) |
| 思考トークンの最大値 | 1,941 | 1万2,837 |
円はAInformationが11月9日の欧州中央銀行の値(1ドル157.95円)で直した値です。思考トークンの最大値は約6.6倍に増えますが、早く直ったぶん総額はhighの約15分の1で済みました。ただし不具合1件だけの比べです。
Claude Codeの思考は要約 見え方だけ変わった可能性もある
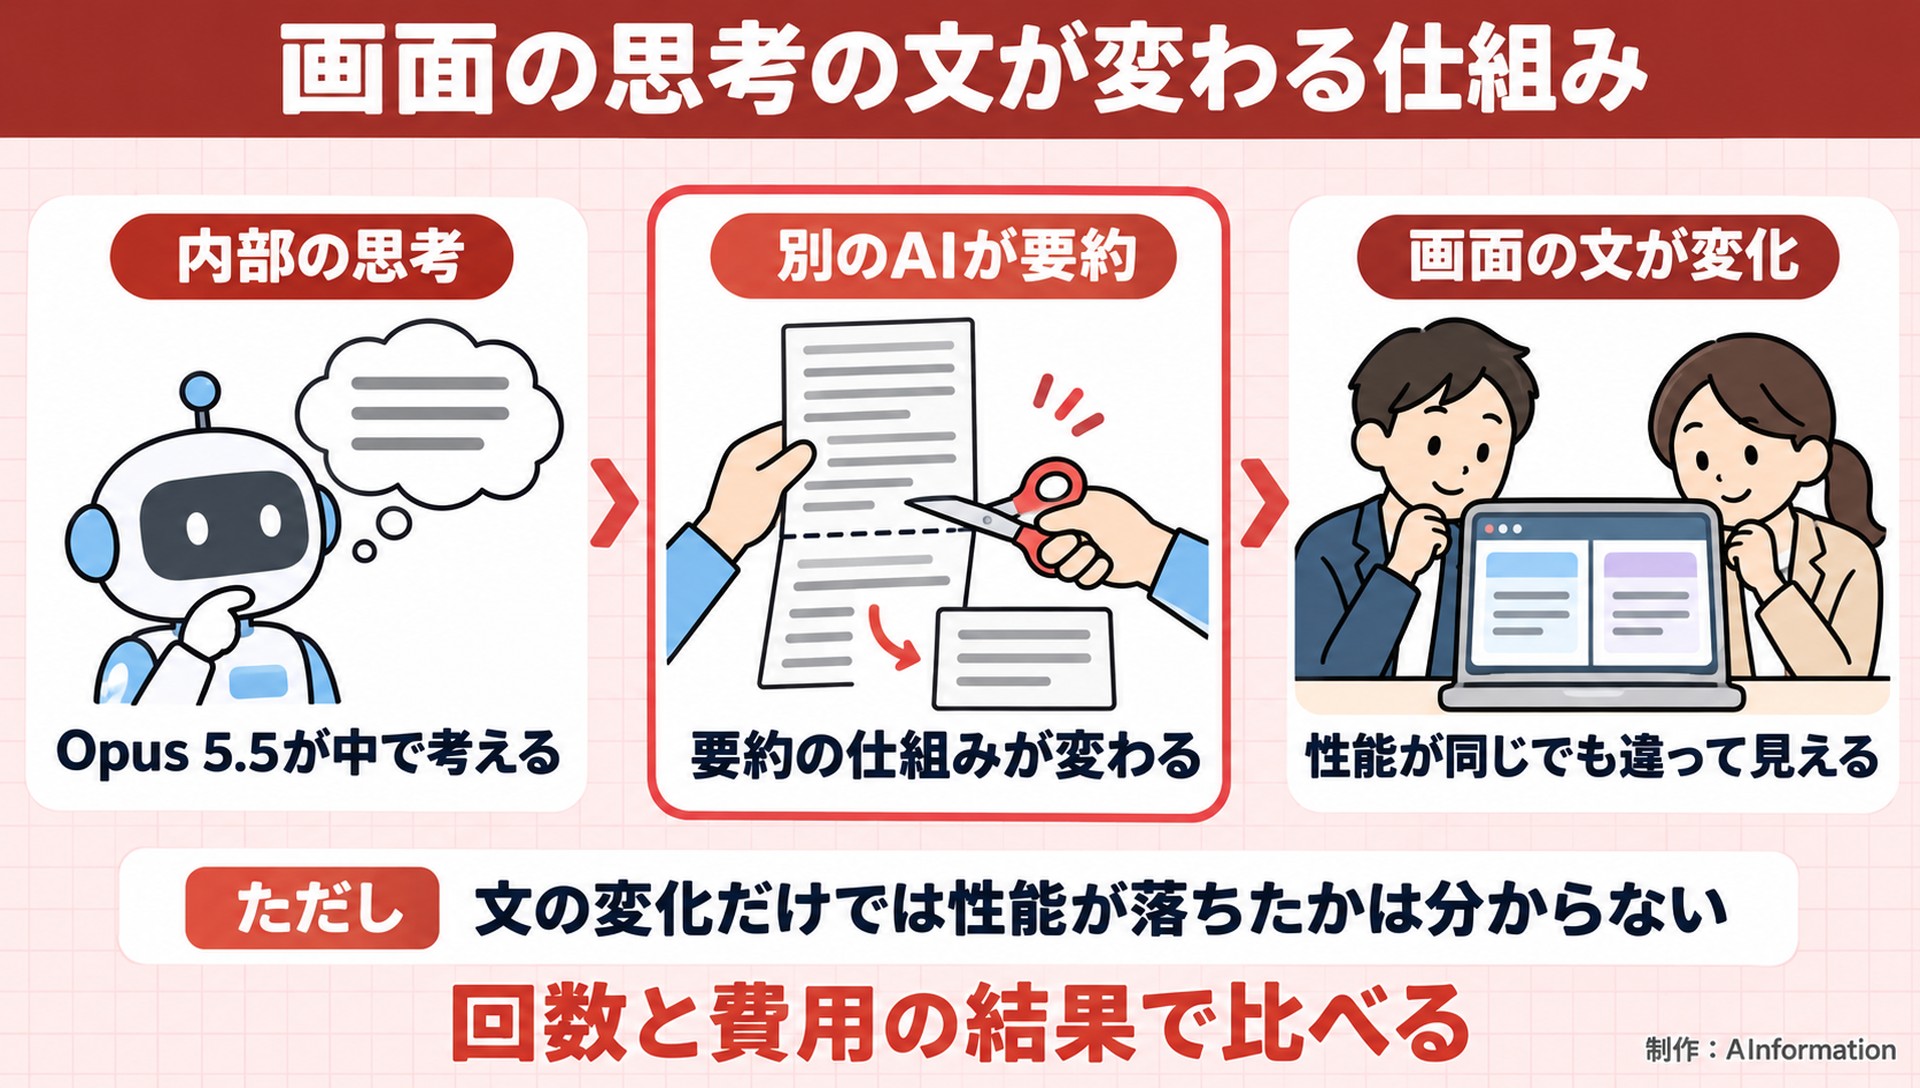
思考の文が変わっても、性能が落ちたとは言い切れません。Anthropicの公式資料では、Claude Codeなどに出る思考は内部の処理そのものではありません。別のAIモデルが作った要約です。
開発者のテオ・ブラウン氏は、Opus 5.5の応答約45万8,000件を調べました。要約の仕組みがアカウントごとに順に切り替わっている可能性があるといいます。切り替わった時期は、アカウントによって10月30日から11月4日まで違いました。
ブラウン氏の記録では、応答1回あたりの思考トークンの平均は369から413へ増えています。本人は「能力低下の兆候は見つからなかった」と述べました。Hacker Newsでも、性能が落ちたという声と要約が変わっただけという声が並んでいます。
AInformationの記録で試すと 日本語では数え方が使えない
手元のClaude Codeの記録で試すと、同じ数え方は使えませんでした。AInformationが数えると、Opus 5.5の思考ブロック174,075件のうち文が残るのは28,910件でした。
- 日本語の割合:11月4日より前の文は99.2%に日本語が入り、「I’m」で数える方法が当てはまらない
- 文の長さの中央値:11月4日3時の前後で89字と84字
- 文が空のブロック:前後で83.5%と82.2%で、大きな差は出ていない
数えたのはこのMacに残る10月9日から11月7日までの記録で、定時の自動の作業も混ざっています。厳密な比べ方ではない点は気をつけてください。
Opus 5.5で作業が進まないとき xhighと結果で比べる
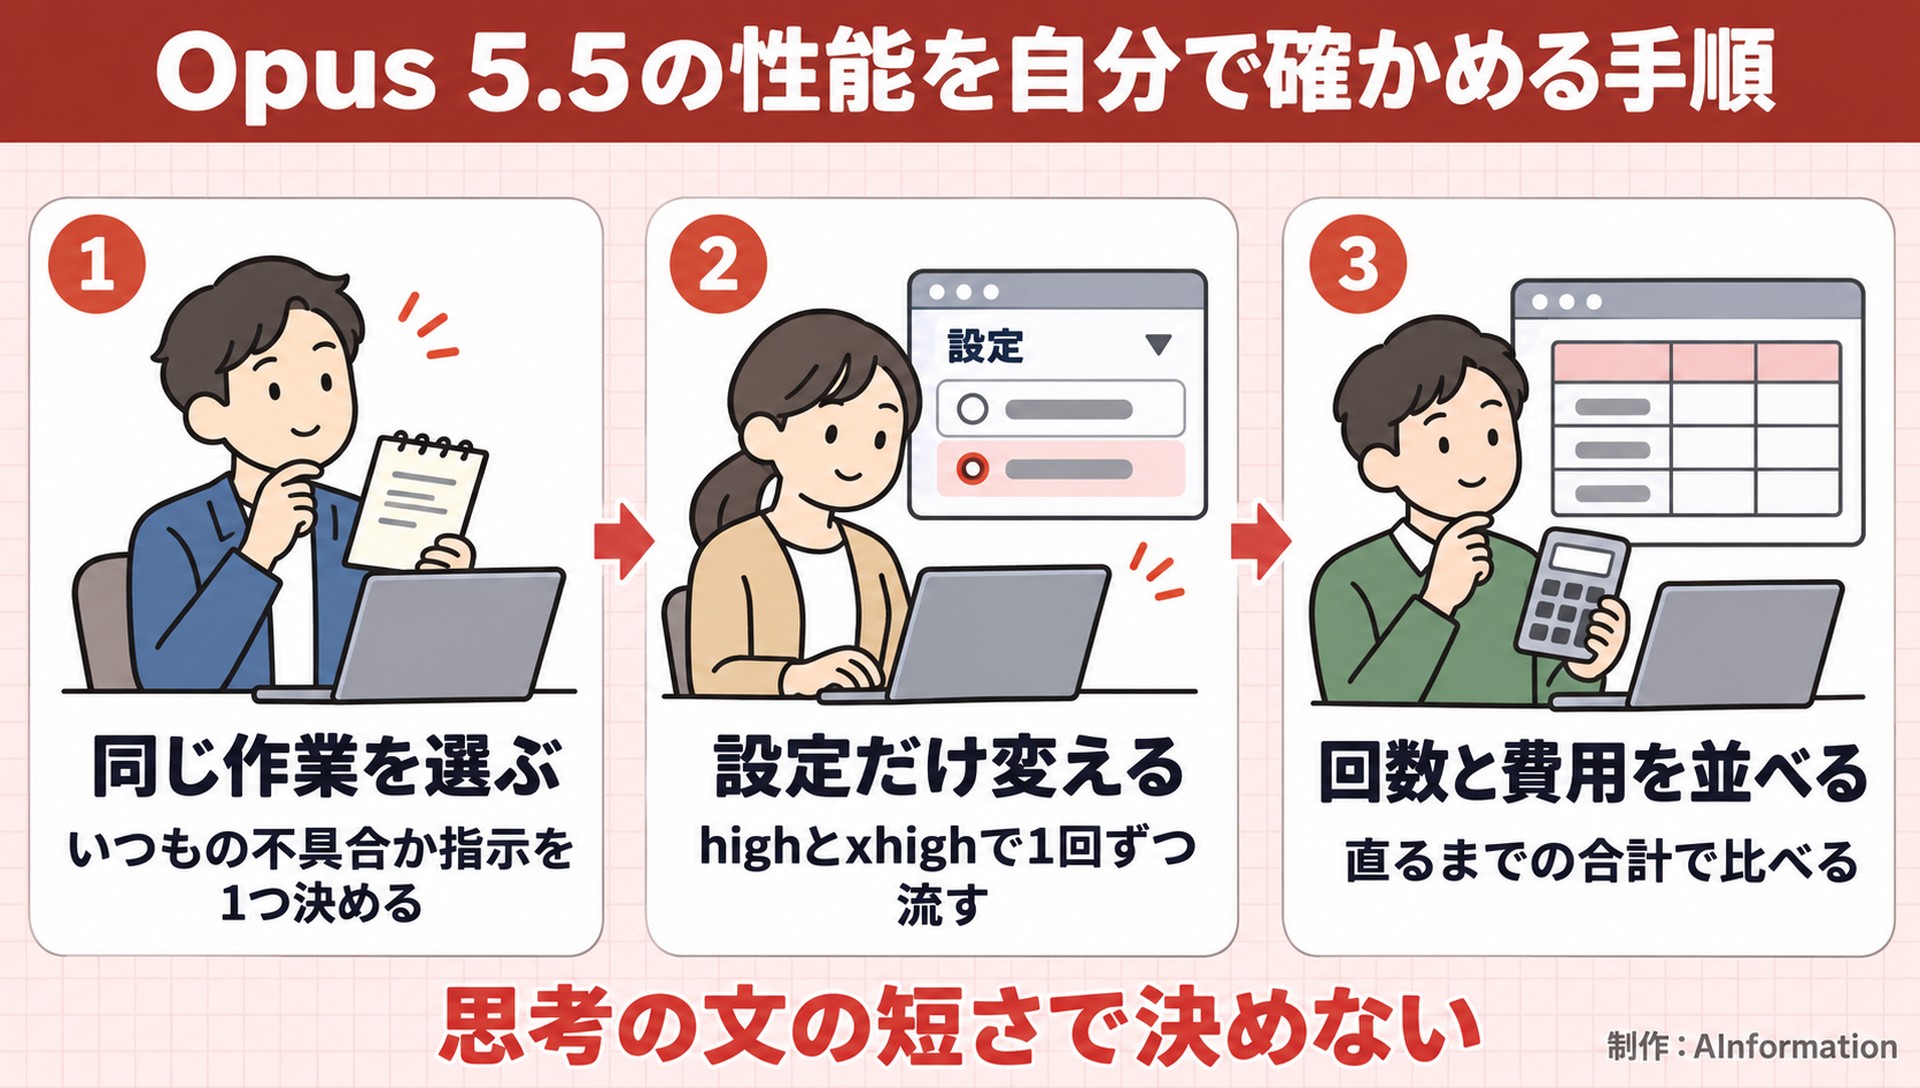
作業が進まないと感じたら、思考の文の見た目より作業の結果で比べるのが確実です。同じ不具合か同じ指示を、highとxhighで流してみてください。回数と費用を並べると、設定を上げる値打ちがあるか分かります。
- 同じ作業で比べる:推論の負荷だけを変え、やり取りの回数と費用を残す
- 文の短さで決めない:要約の仕組みが変わっただけでも見え方は変わる
- 何件かで見る:1件の比べで設定やモデルを決めない
- 新しいモデルとも比べる:Anthropicが発表したClaude Fable 5.2でも同じ作業を流す
Anthropicは2026年4月にも、Claude Codeの品質低下を調べた結果を公表しています。そのときは推論に使う処理量の設定の変更などが原因でした。今回はまだ公式の説明が無く、次の発表で何が変わったのかがはっきりしそうです。
Claude Codeを自分で使うなら使い方と入れ方/料金とProで使える回数/AIコーディング4本の比べ
- 推論の負荷
- Claude Opus 5.5が答える前に考える処理量を決める設定。highより上のxhighにすると、複雑な問題を解く力が上がるとされる
※記事の事実とは分けて、筆者の考えを書いています。
分析・考察会社でClaude Codeを配っている情報システム部門は、性能の噂が出たときに比べる物差しを持っていないことが多い。いつもの作業を3つほど決め、回数と費用を毎月残しておけば、今回のような話にもすぐ答えられそうだ。
今回の件は、画面の思考が要約だということも改めて見せた。画面の文を根拠に設定やモデルを変えるより、終わった作業の数で決めるほうが現場は混乱しにくいとみている。
- Claude Opus 5.5の性能は本当に落ちたの?
- 11月10日の時点では分かっていません。メロー氏は約1,400件の記録で、最初の操作までの思考トークンの中央値が84から54へ減ったと示しました。一方でブラウン氏は約45万8,000件を調べ、平均は369から413へ増えたとしています。メロー氏自身も科学的に厳密な評価ではないと断っていて、Anthropicの説明はまだ出ていません。
- xhighにすると費用は高くなる?
- 1回ごとの思考は増えますが、総額が下がった例があります。メロー氏が同じ不具合を直させた比べでは、highは160回のやり取りで13ドルかかっても直りませんでした。xhighは5回で直り、費用は0.85ドルです。円にすると約2,053円と約134円でした。ただし不具合1件だけの結果なので、自分の作業でも試して確かめるのが確実です。
- 日本語で使っていても同じ方法で確かめられる?
- 英語の言い回しを数える方法は、そのままでは使えません。AInformationが手元のClaude Codeの記録を数えると、11月4日より前のOpus 5.5の思考の文は99.2%に日本語が入っていました。「I'm」で始まる文の割合を見ても意味がありません。日本語で使う人は、同じ作業を推論の負荷だけ変えて流し、回数と費用で比べるほうが分かりやすいです。
【この記事の出典】
- GIGAZINE(この記事の元にした報道)補助資料・2026年11月10日に確認