| ChatGPTが正解した数(83.3%) | 15/18試行 |
|---|---|
| Geminiが正解した数(66.7%) | 12/18試行 |
| Claudeの所要時間の中央値 | 13.8秒 |
- 2026年11月13日に画像の数字を読む6課題を、ChatGPT・Gemini・Claudeへ3回ずつ投げて機械で採点した
- 正解率はChatGPTが18試行中15試行(83.3%)でいちばん高かった
- Geminiは18試行中12試行(66.7%)、Claudeは18試行中10試行(55.6%)だった
- 答えの全文を見ると、54試行すべてで数そのものは正解と同じだった。差は答えの書き方と採点の読み取りから出た
- Microsoft Copilotは人間確認の画面が出て、18試行とも測れていない
- 傾いた表・レシートのJSON・棒グラフを読ませるプロンプト3つを、そのままコピーして試せる
画像読み取りAIの正解率はChatGPTが83.3%だった
正解の基準は、課題ごとに決めた数を誤差0で全部そろえた回だけを○にすることです。この基準で数えると、ChatGPTは18試行中15試行(83.3%)が正解でした。2位はGeminiで18試行中12試行(66.7%)です。
Claudeは18試行中10試行(55.6%)でした。ChatGPTが落とした3試行は、レシートをJSONにする課題だけです。ほかの5課題は3回とも○でした。
いちばん差が出たのは、数を読む力よりも答えの書き方です。答えの全文を見ると、54試行すべてで数は正解と同じでした。×の回は、次の3つのどれかで落ちています。
- 傾いた表の月別合計:Geminiは3回、Claudeは2回が「2025-07」の書き方で×
- レシートのJSON:3つのAIとも英語のキーで返し、採点が数を拾えず3回とも×
- 棒グラフの一番高い値:Claudeは画面の答えが7800の1行なのに、読み取りで数が2回つながり×
なので正解率の差は、頼んだ書き方をどれだけ守ったかの差として読んでください。1回の測定なので、日や課題が変われば順位は変わります。
課題の全文・回答の全文・1行=1試行の採点表(CSV)・画面は、この回の採点表と回答の全文から落とせます。
測り方は72試行のうち54試行を機械で採点した
2026年11月13日に、ChatGPT・Gemini・Claude・Microsoft Copilotの4つへ同じ課題を投げました。課題は6つで、それぞれ3回ずつです。4つのAIを合わせると72試行になります。
使ったプランと画面に出ていたモデル名
- ChatGPT:ChatGPT Plus(画面の表示は思考量 Medium)
- Gemini:Google AI Pro(画面の表示はFlash-Lite)
- Claude:Claude Ultra(画面の表示はOpus 4.8 高)
- Microsoft Copilot:無料のMicrosoftアカウント(モデル名は読み取れなかった)
Microsoft Copilotだけは無料の枠です。ほかの3つとの差には、使えるモデルや回数の違いも入ります。ただしこの回は、Copilotの答えが1本も返っていません。
どれもブラウザの画面から使いました。APIではなく、読者がふだん触るのと同じ画面です。既定のモデルと既定のモードのままで、Deep Researchのような機能は使っていません。
材料は架空の会社の自作の画像3枚
材料は架空の株式会社サンプル商事のデータから作った画像です。正解の数は画像を作る時点で決めてあります。
- レシートの画像:品物の一覧と小計・消費税・合計・お預り・お釣りが並ぶ
- 棒グラフの画像:商品A(タンブラー)の1月から6月までの売上の棒が並ぶ
- 少し傾けた表の画像:2025-07〜2025-10の4か月分で、商品AからEまでの列がある
実在の企業のデータは使っていません。レシートの下には「この画像は検証用の架空のレシートです」の1行も入れてあります。
採点はAIに任せず機械だけで行った
採点はすべて機械で行い、AIには採点させていません。採点の型は6課題とも同じで、答えの数が正解とぴったり同じかを見ます。誤差は0です。
- 毎回あたらしい会話で投げる
- 投げる順番は回ごとに入れ替える(先頭は1回目がChatGPT・2回目がGemini・3回目がClaude)
- 1試行の制限時間は300秒(5分)
- 分母から外すのは上限の表示・編集部の操作の失敗・人間確認の画面だけ
機械は課題文で指定した語を目印に、答えの中から数を探します。目印が見つからないと、採点表の理由に「7月 の行が無い」のように出ます。数が合っていても、この場合は×です。
AIによっては、読み上げ用の1行や考えている途中の要約が答えと同じ枠に入ります。そこで採点の前に、答えの先頭で繰り返されている行を落としました。3つのAIとも同じ処理で、落とす前の答えもデータページに置いてあります。
6課題の結果は書き方の差で正解率が分かれた
課題ごとの合格は、正解の数を全部そろえた回だけです。6課題は易が2つ・中が2つ・難が2つの並びにしました。下の表は3回のうち何回が正解だったかです。
課題ごとの正解数(3回のうち)
| 課題 | ChatGPT | Gemini | Claude | Copilot |
|---|---|---|---|---|
| 1 棒グラフの一番高い値(易) | 3/3 | 3/3 | 0/3(読み取りのずれ) | 測れず |
| 2 レシートの合計(易) | 3/3 | 3/3 | 3/3 | 測れず |
| 3 傾いた表の月別合計(中) | 3/3 | 0/3 | 1/3 | 測れず |
| 4 棒グラフの合計(中) | 3/3 | 3/3 | 3/3 | 測れず |
| 5 レシートをJSONに(難) | 0/3(採点で拾えず) | 0/3(採点で拾えず) | 0/3(採点で拾えず) | 測れず |
| 6 傾いた表の全部の合計(難) | 3/3 | 3/3 | 3/3 | 測れず |
| 合計 | 15/18 | 12/18 | 10/18 | 0試行(人間確認) |
表と同じことを文でも書いておきます。
- 課題1(易・棒グラフの一番高い値):ChatGPTとGeminiが3回とも正解。Claudeは0回
- 課題2(易・レシートの合計):3つのAIとも3回とも正解
- 課題3(中・傾いた表の月別合計):ChatGPTが3回。Claudeは1回でGeminiは0回
- 課題4(中・棒グラフの合計):3つのAIとも3回とも正解
- 課題5(難・レシートをJSONに):3つのAIとも0回
- 課題6(難・傾いた表の全部の合計):3つのAIとも3回とも正解
易・中・難の順に正解が減ったわけではありません。難の課題6は3つのAIとも3回とも正解でした。反対に易の課題1で、Claudeは3回とも×になっています。
合計を出す課題は、どれも全員が正解しました。棒グラフの合計43300も、表の全部の合計232700も同じです。差がついたのは、答えの形に決まりがある課題でした。
傾いた表の月別合計はChatGPTだけ3回とも○
課題3は、4か月分の合計を月と一緒に全部合わせたら○です。正解は次の4つでした。
- 2025-07:61100
- 2025-08:63000
- 2025-09:57700
- 2025-10:50900
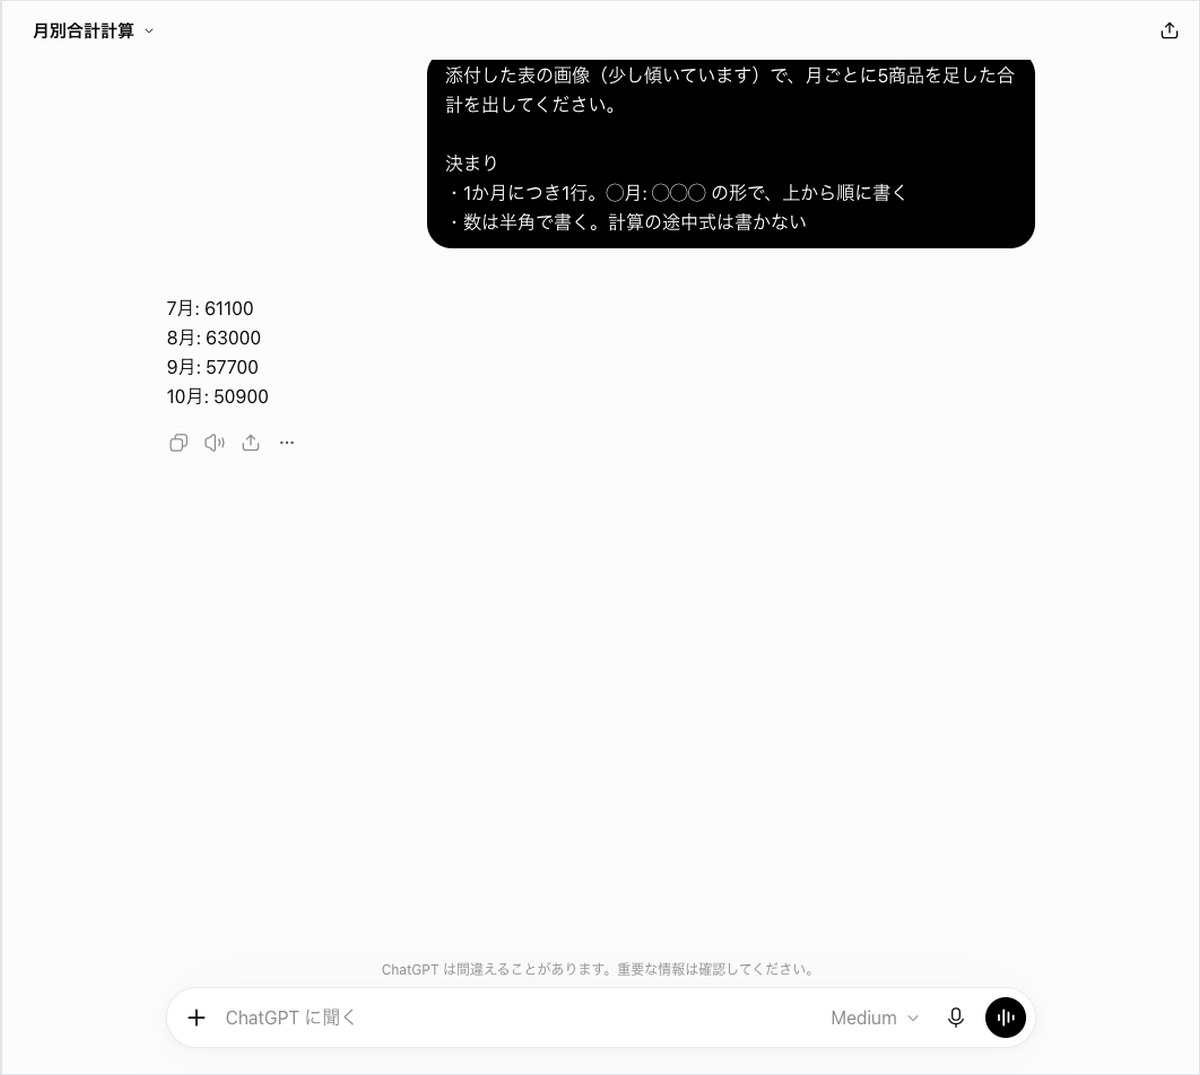
投げた文は次のとおりです。スマホで撮った書類のように、表の画像を少し傾けてあります。
添付した表の画像(少し傾いています)で、月ごとに5商品を足した合計を出してください。
決まり
・1か月につき1行。◯月: ◯◯◯ の形で、上から順に書く
・数は半角で書く。計算の途中式は書かない
ChatGPTは「7月: 61100」の形で3回とも○
ChatGPTは3回とも4つの数を正しく返しました。1回目の答えは「7月: 61100」から始まる4行で、20.1秒です。2回目は「2025-07月: 61100」の形で、これも○になっています。
Geminiは数が全部合っていたのに3回とも×
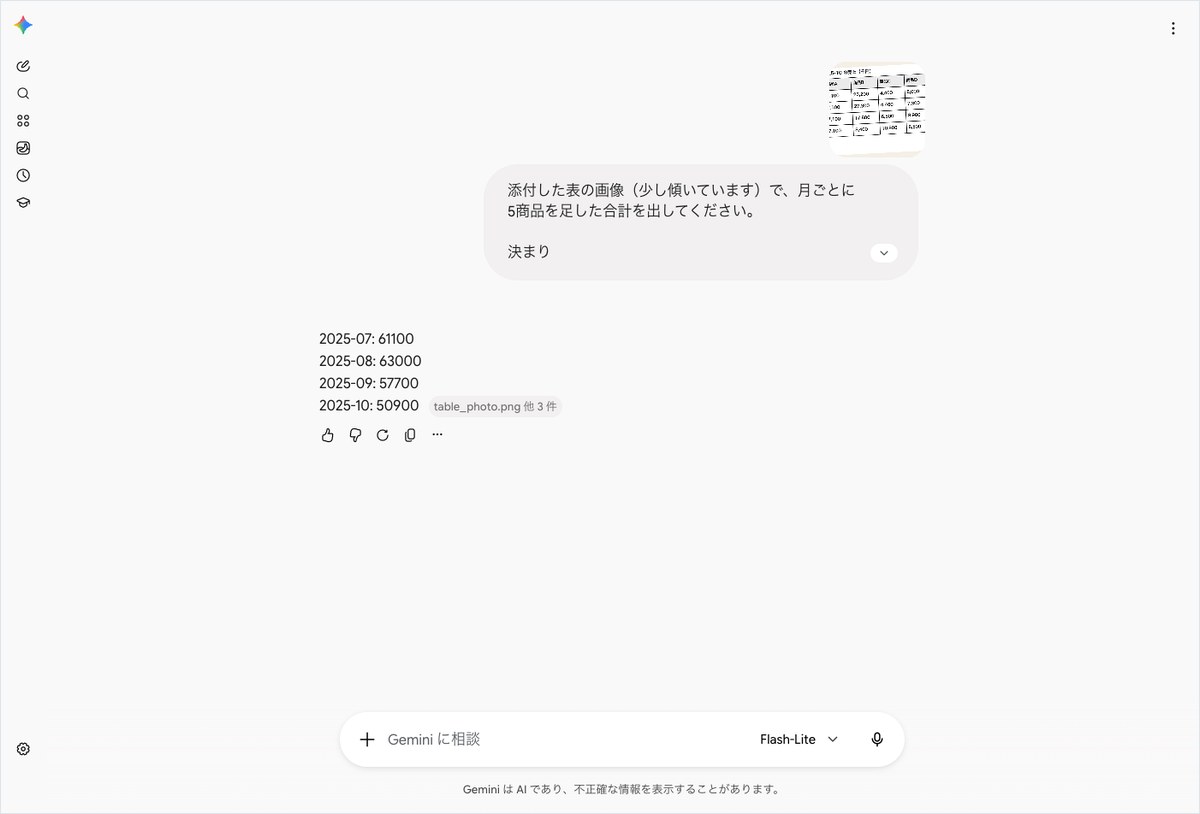
Geminiの3回の答えは、どれも「2025-07: 61100」から始まる4行でした。数は4つとも正解と同じです。ただ課題文は「◯月: ◯◯◯ の形で」と頼んでいて、行の頭に「7月」がありません。
採点表の理由は4行とも「7月 の行が無い」でした。目印の語が見つからず、数が合っていても×になっています。2回目は40.3秒かかり、この課題でいちばん長い時間でした。
Claudeは3回のうち2回が同じ書き方で×
Claudeは2回目だけが「7月: 61100」の形で○でした。1回目と3回目は「2025-07: 61100」の形で、Geminiと同じ理由で×です。3回とも16.9秒で返しています。
Claudeの再現率が88.9%なのは、この課題で3回の結論がそろわなかったためです。表の月の列は「2025-07」と書かれていて、そのまま写した回と月の名前に直した回に分かれました。
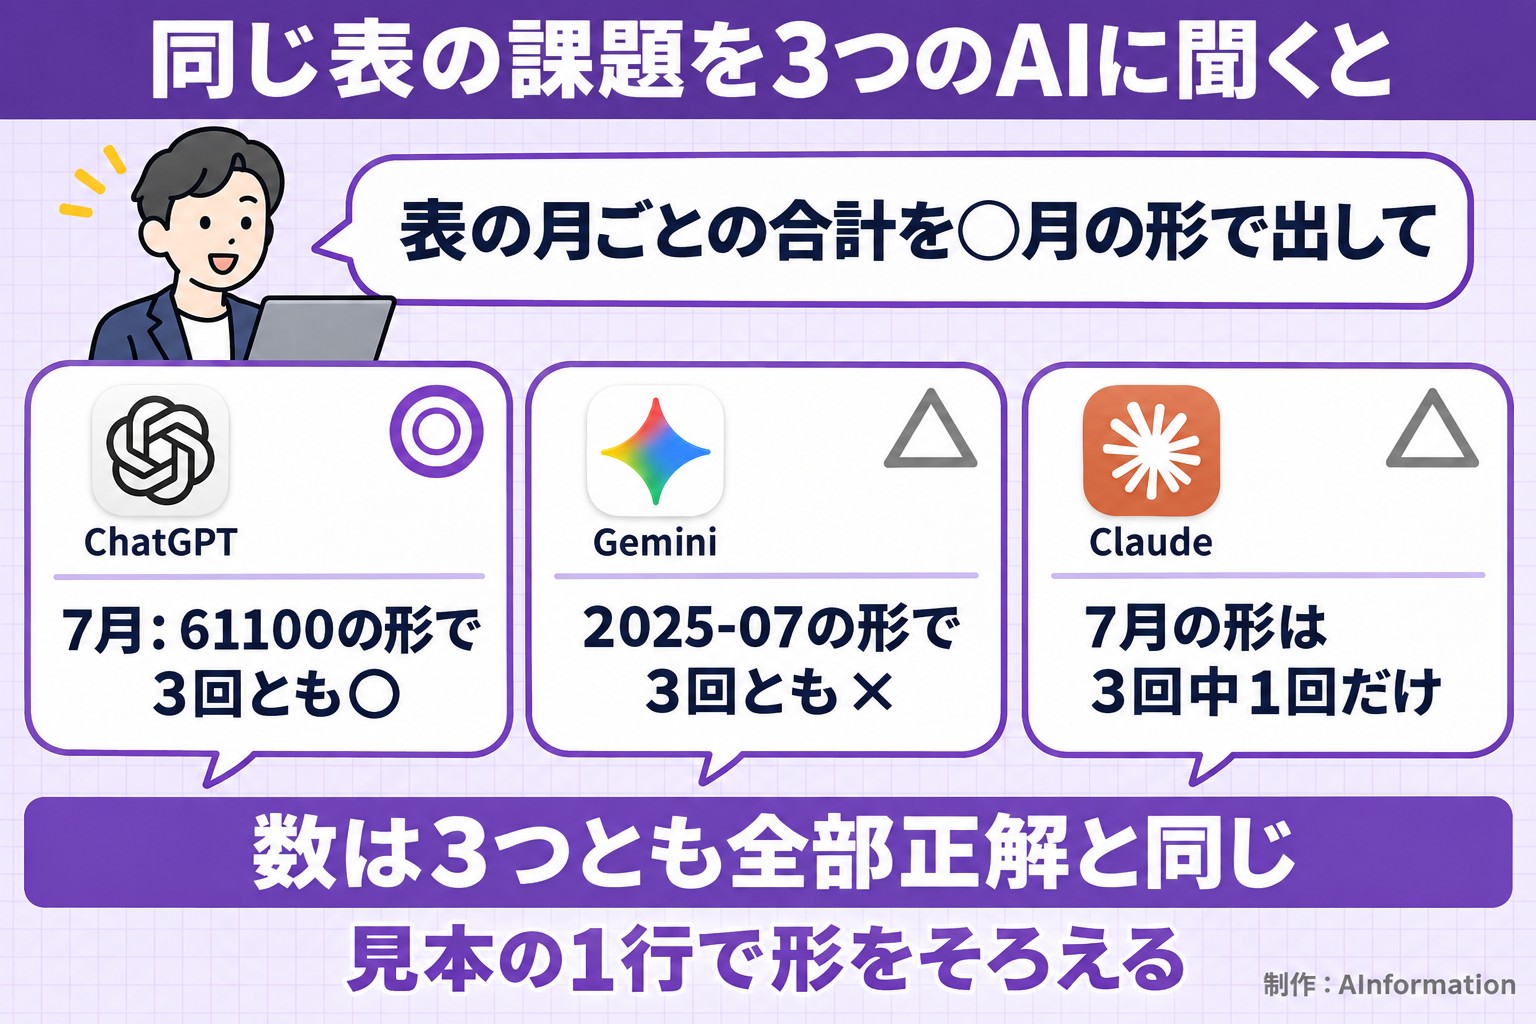
前回の画像読み取りの測定では反対に、目印が「2025-07」の課題でChatGPTが「7月」と書いて落としています。月の書き方は、AIに任せると回ごとに揺れます。欲しい形があるなら、課題文に見本の1行をそのまま入れるのが確実です。
レシートのJSONは3つのAIとも採点で数を拾えず
課題5は、レシートを読んでJSONで返す課題です。会計ソフトや表計算へ取り込む前の形として、品名と金額の一覧も頼みました。
- 小計(subtotal):1906
- 消費税(tax):152
- 合計(total):2058
この3つの数がそろえば○です。投げた文は次のとおりです。
添付したレシートの画像を読み取り、JSON だけを出力してください。
決まり
・出力は JSON だけ。前後に説明文を書かない
・形は {"items": [{"name": "品名", "price": 金額}], "subtotal": 小計, "tax": 消費税, "total": 合計} にする
・数は数値で入れる(文字列にしない・円記号とカンマを入れない)
3つのAIとも答えの数は全部合っていた
3つのAIの答えには、どれも課題文どおりの英語のキーが入っていました。subtotalは1906でtaxは152、totalは2058です。レシートの小計・消費税・合計と同じ数でした。
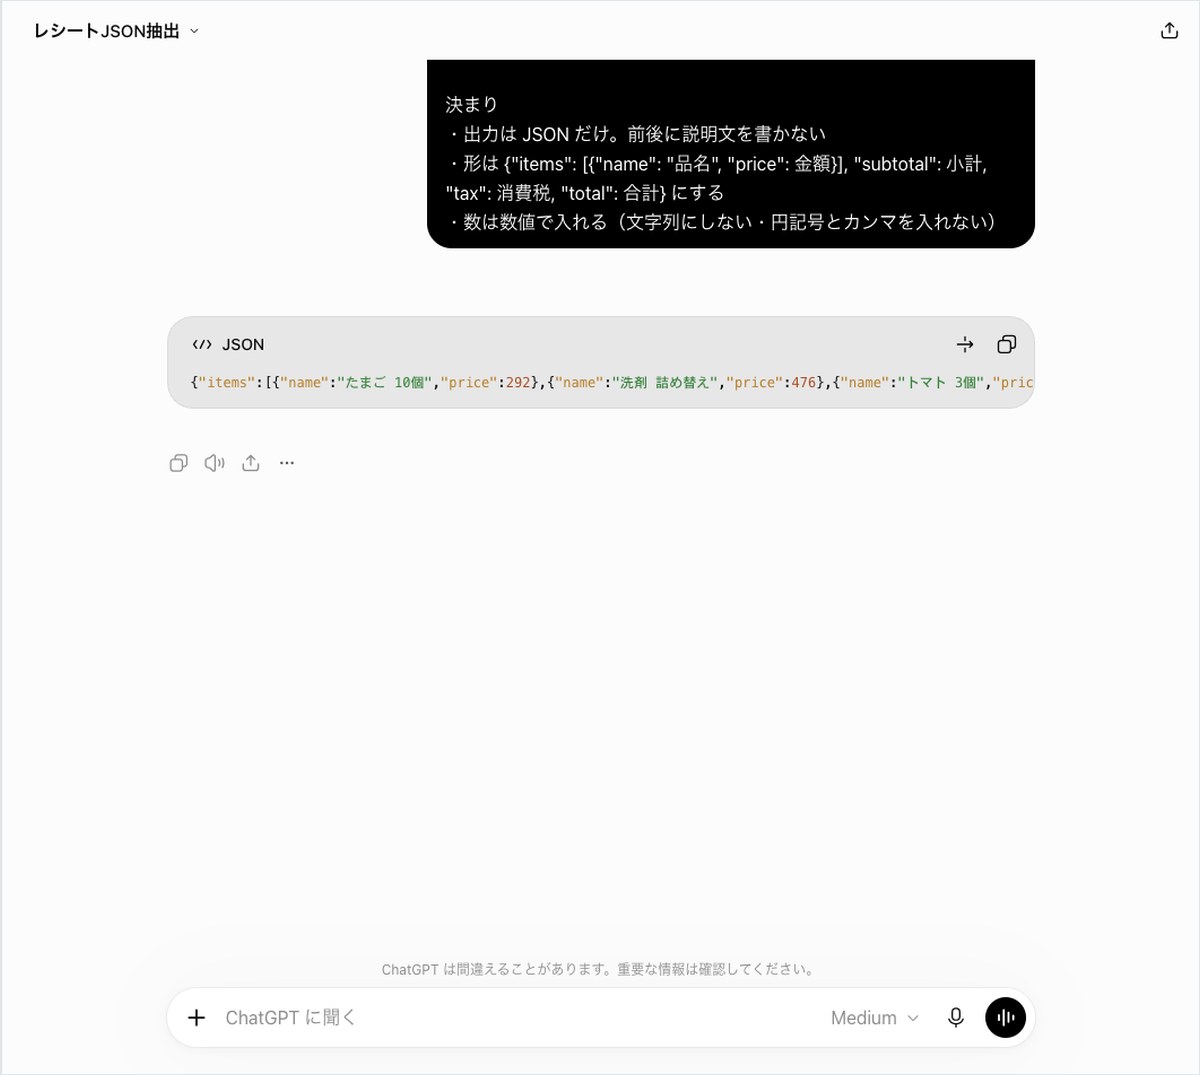
一方で採点表の理由は、どの回も「小計 の行が無い」「税 の行が無い」「合計 の行が無い」でした。機械が日本語の目印を探したので、英語のキーの数を拾えていません。この課題は、AIの差を測れなかった課題として読んでください。
ChatGPTは1行のJSONをコードの枠で返した
ChatGPTの答えは、改行のない1行のJSONでした。画面ではコードの枠に入り、前後に説明の文はありません。3回とも17.2〜17.3秒で返しています。
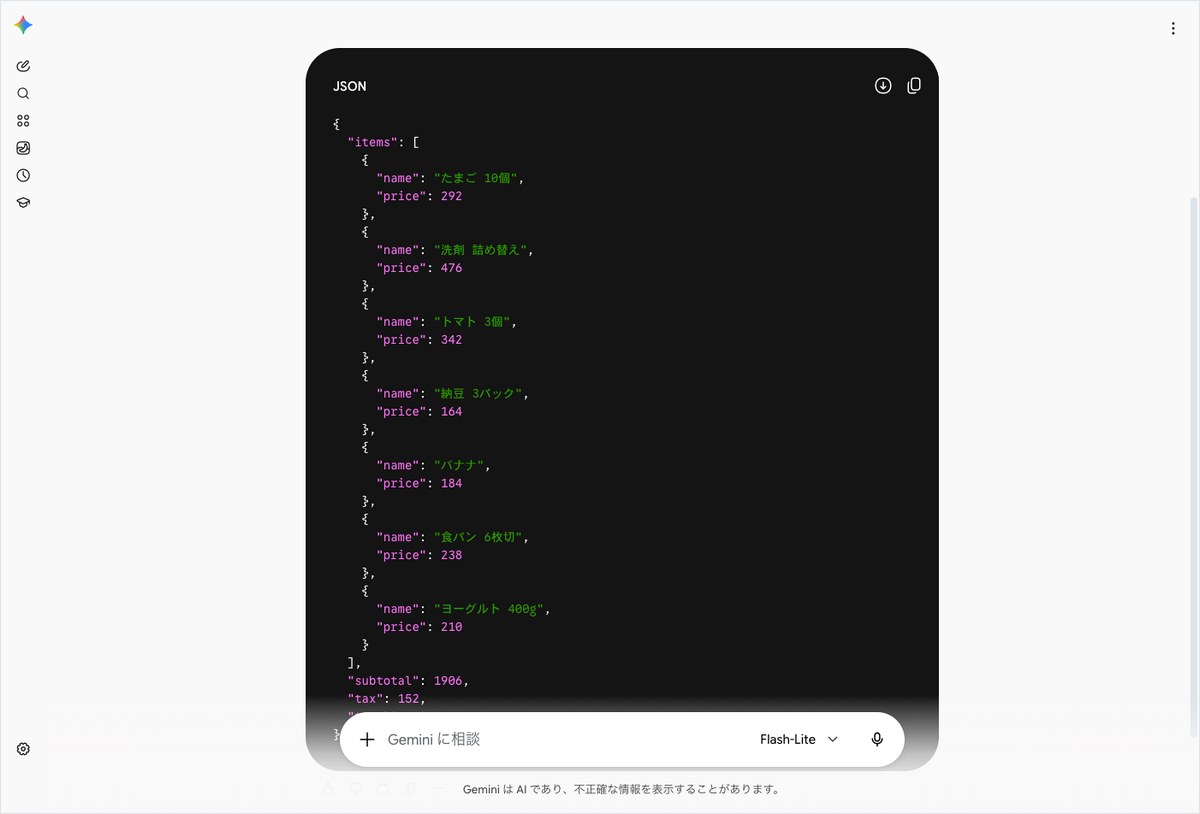
Geminiは品物ごとに改行したJSONを返した
Geminiは品物ごとに改行を入れたJSONで返しました。1回目と2回目は473文字で、字下げの空白が入っています。3回目は字下げのない形で、317文字でした。
所要時間は1回目と2回目が19秒、3回目が22.1秒です。指示の遵守は3回とも○でした。
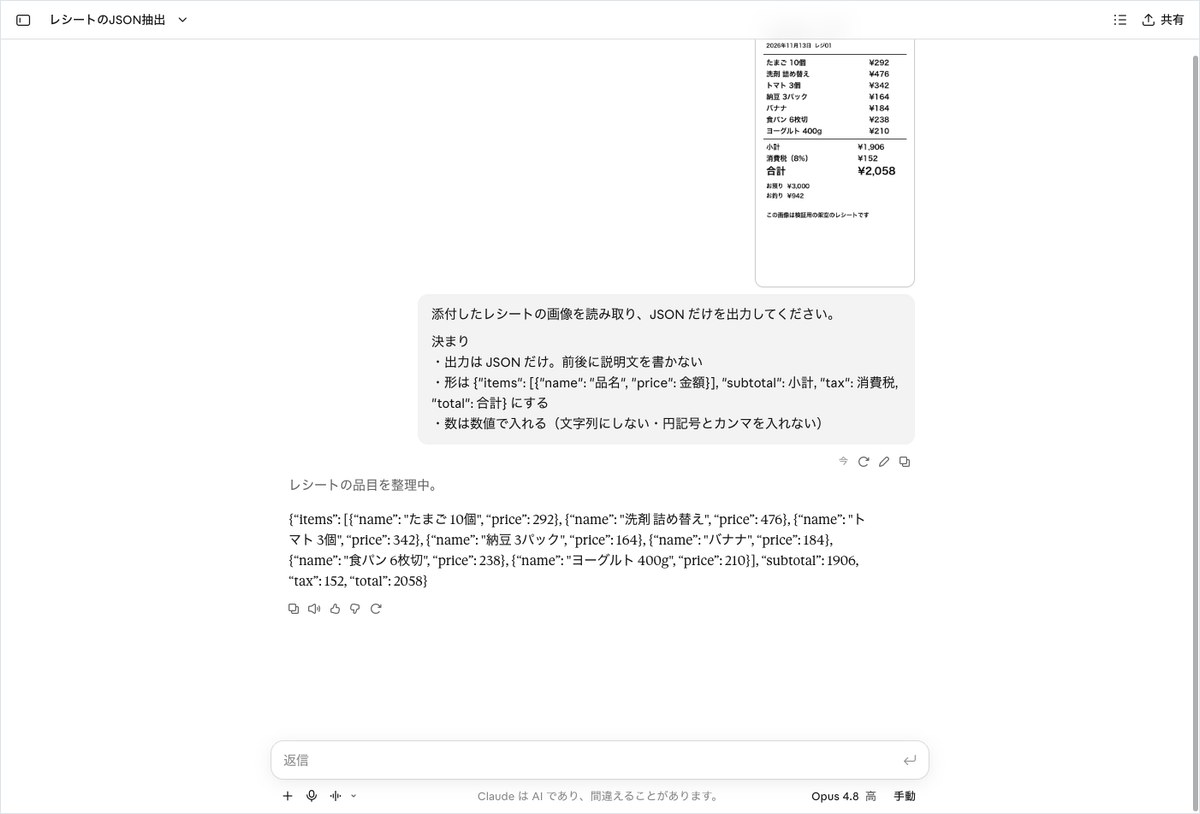
Claudeは画面でキーの引用符が丸い形だった
Claudeの答えも数は全部合っていました。ただ画面では、キーを囲む引用符が丸みのある形で出ています。値を囲む引用符はまっすぐな形でした。
AIが書いた文字か画面の表示かは、この測定では分かりません。読み取った答えには、本文の前に「レシートの品目を整理中」という途中経過の行も入っています。JSONだけを返す決まりは、3回とも×でした。
- 会計ソフトへ貼る前に、引用符がまっすぐな形かを見る
- JSONの前後に説明や途中経過の行が混ざっていないかを見る
- 小計・消費税・合計の3つだけは、レシートと見比べる
この3点を見てから貼れば、取り込みでつまずく所はほぼ消せます。どのAIでも数は合っていたので、気をつけるのは形のほうです。
棒グラフとレシートの合計は3つのAIが全部読めた
課題1・2・4・6は、答えの数が1つだけの課題です。正解は次のとおりでした。
- 課題1(棒グラフの一番高い値):7800
- 課題2(レシートの合計):2058
- 課題4(棒グラフの6か月の合計):43300
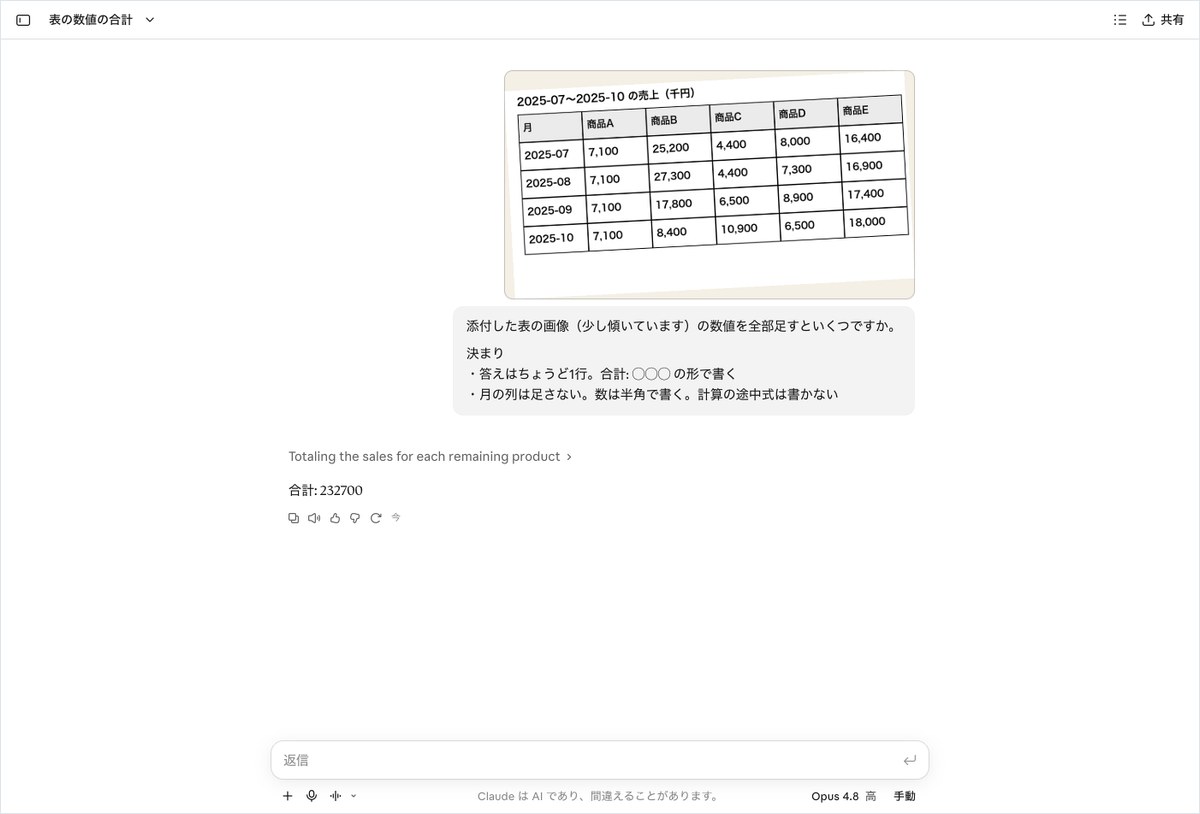
- 課題6(傾いた表の全部の合計):232700
課題1で投げた文です。答えを1行に絞り、月名と説明を書かないように頼みました。
添付した棒グラフの画像で、一番高い棒の数値はいくつですか。
決まり
・答えはちょうど1行。数だけを半角で書く
・月名と説明は書かない
Claudeの課題1は画面では7800の1行だった
Claudeは課題1を3回とも×になっています。採点表の理由を見ると、答えの数が「7800」を2回つなげた形で読まれていました。ただし画面に出た答えは「7800」の1行です。
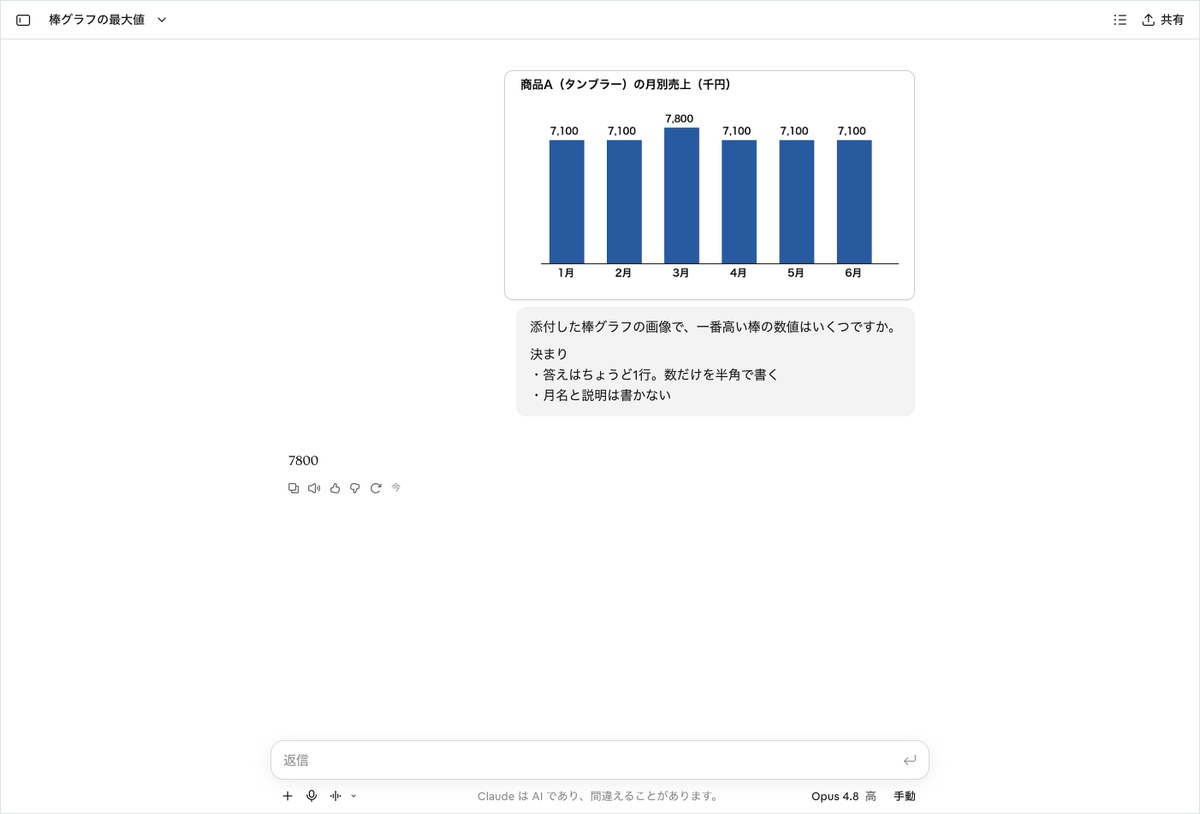
読み取った文字には、読み上げ用の「Claude の応答:7800」の行と本文の「7800」が並んでいました。この2つがつながって1つの数になっています。編集部の読み取りのずれで、Claudeの答えの誤りではありません。
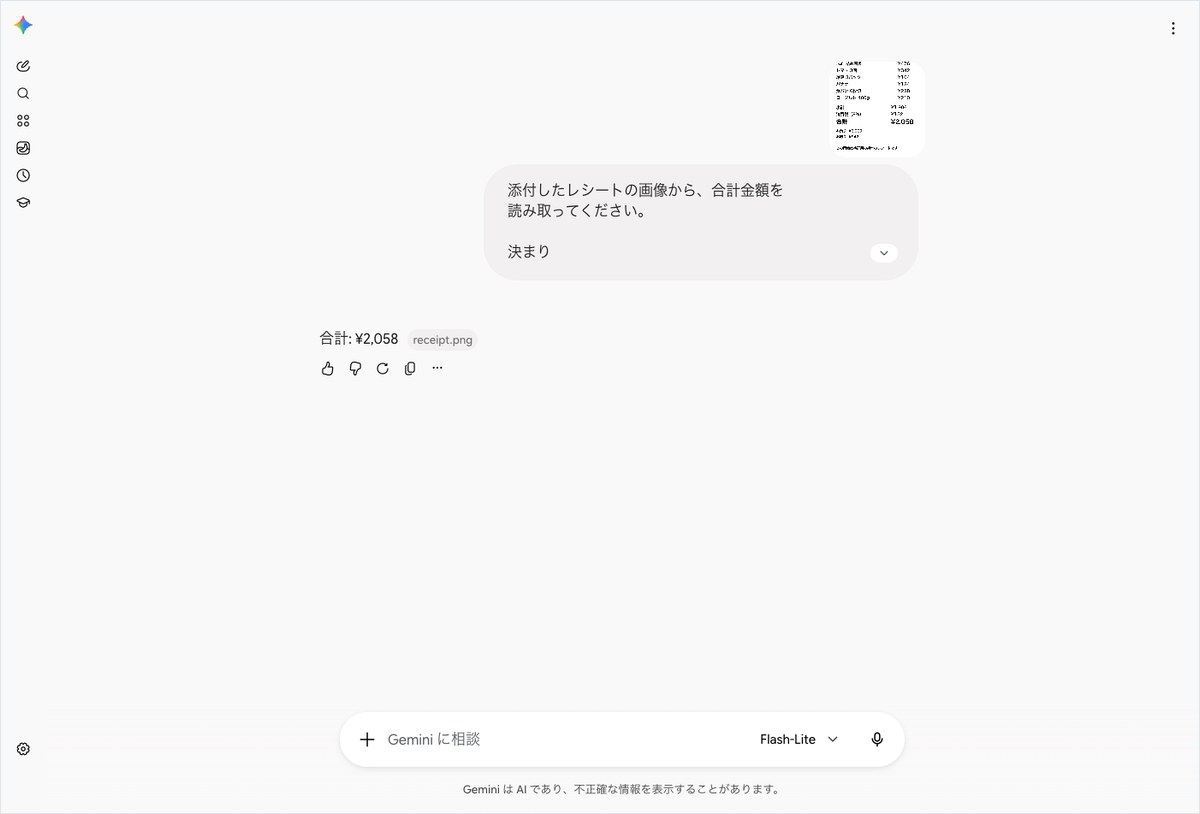
Geminiは合計に円記号とカンマを付けた
課題2でGeminiは3回とも「合計: ¥2,058」と返しました。数は正解なので、正解率では○です。
画面では答えの横に「receipt.png」の札が出ていて、読み取った答えにもその名前が入りました。課題文では、数を半角で書いて説明は書かないように頼んでいます。指示の遵守は3回とも×でした。
表の全部の合計はChatGPTが26.2秒かかった
課題6は3つのAIとも3回とも232700でした。ChatGPTの1回目は26.2秒で、ChatGPTの18試行でいちばん長い時間です。答えは「合計: 232700」の1行だけでした。
Claudeは答えの上に英語の途中経過を1行出してから、「合計: 232700」と返しました。課題6の3回は16.9秒・16.9秒・13.8秒です。傾いた表でも、数を足すだけなら3つのAIの差は出ていません。
5つの指標で見ると遵守率の差がいちばん大きい
5つの指標は毎回同じ物差しです。下の横棒は、測れた3つの指標を%で並べました。
正解率:ChatGPTが18試行中15試行
正解率は、課題ごとに決めた数を誤差0で全部そろえた回だけを数えました。ChatGPTは18試行中15試行(83.3%)、Geminiは18試行中12試行(66.7%)です。Claudeは18試行中10試行(55.6%)でした。
所要時間:Claudeの中央値が13.8秒
所要時間は、300秒の制限時間に収まった回の秒数の中央値です。この回は3つのAIとも時間切れが0回でした。中央値と最短〜最長は次のとおりです。
- Claude:中央値13.8秒(13.8〜16.9秒)
- ChatGPT:中央値17.1秒(13.9〜26.2秒)
- Gemini:中央値19秒(18.9〜43.3秒)
Geminiの最長は課題4の2回目で、43.3秒でした。答えは「合計: 43300」で正解です。
再現率:Claudeだけ課題3で結論が分かれた
再現率は、同じ課題を3回投げて○か×かの結論がそろった割合です。3回とも同じなら、その課題はそろったと数えます。
- ChatGPT:100%
- Gemini:100%
- Claude:88.9%(課題3で3回の結論が分かれた)
Geminiは課題3を3回とも×で、結論としてはそろっています。再現率が高いことは、正解が多いこととは別の話です。
出典の実在率:この分野では測っていない
出典の実在率は、答えに書かれたURLが実際に開けるかを見る指標です。この分野ではURLを見る課題が無いので測っていません。0%ではなく、測っていないという意味です。
指示の遵守率:ChatGPTが100%でClaudeが16.7%
指示の遵守は、頼んだ形(1行だけ・決めた書き出し・JSONだけ)を全部守った回だけを数えました。ChatGPTは18試行とも守り、100%です。Geminiは66.7%で、Claudeは16.7%でした。
- Gemini:答えの横の添付ファイルの名前が、読み取った答えに入った回があった
- Gemini:課題2は円記号とカンマ入りの「合計: ¥2,058」だった
- Claude:読み取った答えの先頭に読み上げ用の「Claude の応答:」の行が入っていた
- Claude:読み取った答えの末尾に、画面のボタンの横にある「今」の1字も付いていた
Claudeは画面で見るかぎり、課題1も課題6も答えは決まりどおり1行でした。16.7%という数字は、読み取った文字の行数を数えた結果です。画面の見た目とは分けて読んでください。
画像読み取りに強いAIは用途で選ぶ
この回の結果を仕事に置き換えると、選び方は次のようになります。どれも1回の測定の数字なので、最後は自分の材料で試してください。
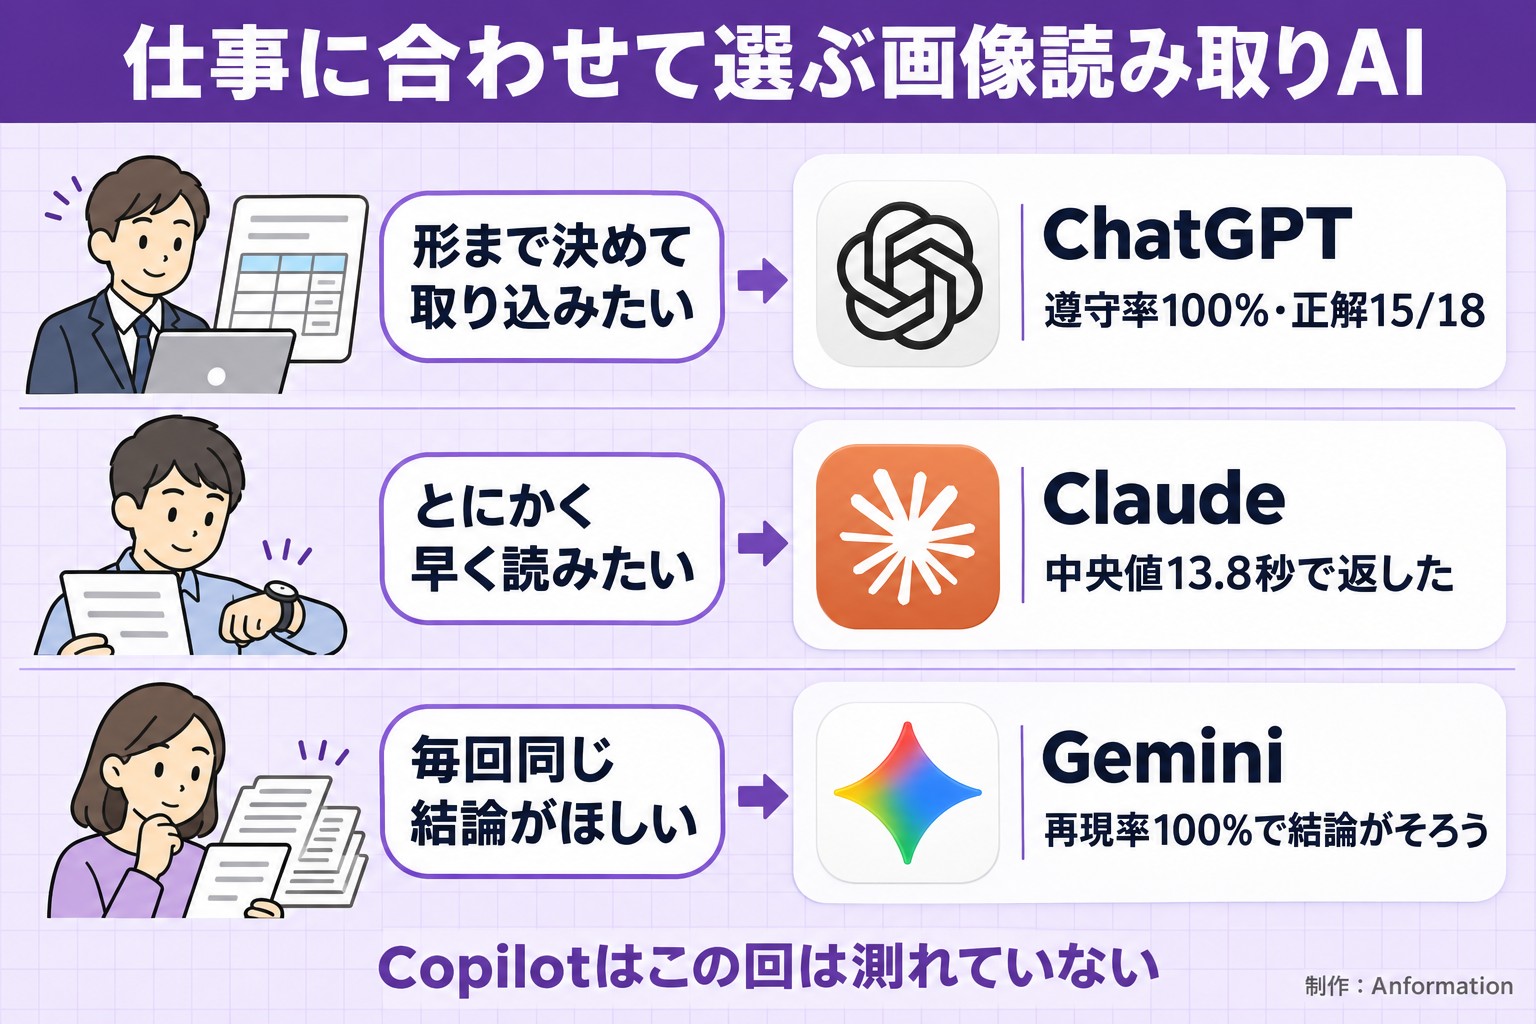
書き方まで決めて取り込むならChatGPT
月の書き方や1行だけの答えなど、形まで決めて頼む仕事はChatGPTが合っていました。指示の遵守は18試行とも守り、正解率も18試行中15試行(83.3%)です。経費の一覧を表計算へ貼る前の下ごしらえに向きます。
速さを重視するならClaude
答えが返るまでの速さは、Claudeが3つの中でいちばんでした。所要時間の中央値は13.8秒で、最長でも16.9秒です。数そのものは全部合っていたので、読んだあとに形を整える前提なら使いやすい結果でした。
やり直しの少なさで選ぶならChatGPTかGemini
同じ課題を3回投げて結論がそろったのは、ChatGPTとGeminiの2つです。再現率はどちらも100%でした。Claudeは課題3で書き方が回ごとに変わり、88.9%になっています。
- 形をそろえたい:ChatGPT(遵守率100%)
- 早く返してほしい:Claude(中央値13.8秒)
- 毎回同じ結論がほしい:ChatGPTかGemini(再現率100%)
- 合計の計算だけ:3つのAIとも全部正解
レシートをJSONにする仕事は、3つのAIとも数は合っていました。ただ採点では差を測れていません。どれを使う場合も、貼る前に引用符の形と余分な行だけは目で確かめると安心です。
Microsoft Copilotは18試行とも人間確認で止めた
Microsoft Copilotは、この回は1本も答えが返っていません。どの試行でも「セキュリティ チェック」の確認画面が出て、編集部はボタンを押さずに止めました。
この18試行は分母から外しています。正解率も順位も出せないので、ほかの3つと比べられる数字はありません。Copilotの画像の読み取りは、この測定では確かめていません。
- 止まった試行:18試行(6課題の3回すべて)
- 止まった理由:人間確認の画面が出た
- 使ったプラン:無料のMicrosoftアカウント(有料プランの結果ではない)
- 扱い:分母から外し、正解率と順位は出していない
Copilotが答えた回の結果は、前回までの記事で読めます。同じ連載の記事は、下の関連の章にまとめました。
この測定の限界は1日1回の54試行
この記事の数字は、2026年11月13日の1回の測定です。日や課題が変われば順位は変わります。次の限界も踏まえて読んでください。
- 既定のモデル・既定のモードだけで測った。Deep Researchなどは使っていない
- 課題は架空の株式会社サンプル商事の自作データで、実在の企業のデータでの結果ではない
- 機械で採点できる課題だけを扱った。文章のうまさや読みやすさは測っていない
- ブラウザで人が使うのと同じ画面から測った。APIの結果ではない
- Copilotは無料の枠で測っていて、この回は人間確認の画面で測れていない
この回は採点の仕組みにも限界が出ました。課題5は英語のキーの数を拾えず、課題1のClaudeは読み取りで数がつながっています。正解率の差は、この2点を含んだ数字です。
数え直したい人のために、材料は全部公開しています。課題の全文・答えが返った54本の回答・1行=1試行の採点表(CSV)・画面は、この回の採点表と回答の全文から落とせます。
引用するときは、出典として「AInformation調べ」とデータページのURLを書いてください。測定日の2026年11月13日も添えてもらえると助かります。
関連する記事とツール
- AI実務ベンチ:画像・写真の読み取り(2026年11月13日のデータページ)
- ChatGPT
- Gemini
- Claude
- Microsoft Copilot
- 議事録AIのおすすめ比較!決定とやることを抜くプロンプト3つ
- 画像読み取りAIのおすすめを比較!レシートを読むプロンプト3つ
- 議事録要約AIの精度を4つ比較!そのまま使えるプロンプト3つ
- 画像読み取りAIを4つ比較!数字を読むプロンプト3つと選び方
※記事の事実とは分けて、筆者の考えを書いています。
分析・考察画像の数字を読ませる仕事では、3つのAIとも数そのものは54試行すべて合っていました。差がついたのは、月の書き方やJSONの形といった答えの形です。
ChatGPTは頼んだ形を18試行とも守り、正解率でも上に立ちました。社内で使うなら、欲しい形を見本の1行で見せるのが近道です。取り込む前に合計の1か所だけ人が確かめると、さらに安心です。
- 画像の数字をいちばん正確に読めたAIはどれですか?
- 採点表ではChatGPTです。2026年11月13日に6課題を3回ずつ投げ、18試行中15試行(83.3%)が正解でした。Geminiは18試行中12試行(66.7%)、Claudeは18試行中10試行(55.6%)です。ただし答えの全文では54試行すべてで数は正解と同じで、差は書き方から出ています。1日1回の測定なので、日や課題が変われば順位は変わります。
- Claudeの正解率が低いのはなぜですか?
- 数の読み違いではなく、書き方と採点の読み取りで落ちたためです。課題1は画面の答えが7800の1行なのに、読み取った文字で数が2回つながりました。課題3は2回が「2025-07」の形で、目印の「7月」がありませんでした。課題5は英語のキーの数を採点が拾えず、3つのAIとも×です。
- レシートをJSONにする課題が全員×なのはなぜですか?
- 採点の目印が日本語の「小計」「税」「合計」で、英語のキーの数を拾えなかったためです。3つのAIの答えには、課題文どおりのキーで小計1906・消費税152・合計2058が入っていました。この課題はAIの差を測れなかった課題として扱ってください。
- Microsoft Copilotの結果はどうでしたか?
- この回は測れていません。18試行とも「セキュリティ チェック」の人間確認の画面が出て、ボタンを押さずに止めました。分母から外しているので、正解率も順位も出していません。使ったのは無料のMicrosoftアカウントで、有料プランの結果でもありません。
- 記事と同じプロンプトで自分でも試せますか?
- 試せます。本文に載せた3つの課題文は、そのままコピーして使えます。材料のレシート・棒グラフ・傾いた表の画像と、答えが返った54本の回答・採点表(CSV)はデータページから落とせます。数は誤差0で採点しているので、自分の答えと正解をそのまま見比べられます。