LFM3-1.7Bは17億パラメータ 4bitなら約1GBに収まる
Liquid AIは10月27日に新しいモデル群「LFM3」を公開した。中心になるのは日本語に対応したテキストモデル「LFM3-1.7B」だ。PCやスマートフォンで動くAIエージェントと、特定の用途に合わせた調整を想定している。
総パラメータ数は17億で、扱える文脈は入出力を合わせて最大256Kトークンある。4bit精度ならモデルは約1GBに収まり、GPU1枚で追加の学習ができる。重みはHugging Faceで公開され、同社のPlaygroundとLiquid AI APIからも使える。
同じ日に画像と動画を読む「LFM3-VL-2B」と、18言語の音声認識・合成・翻訳を扱う「LFM3-Audio-2B」も出た。画像と音声と言葉をまとめて扱う初のオムニモデル「LFM3-Omni-2B」と、判断を決まった形で返す「d1-2B」「d1-Omni-2B」も並ぶ。
- 10/27Liquid AIがLFM3シリーズを公開
- 10/28編集部がM4 ProのMacで日本語8問を試す
公表値はQwen3.5-9Bを上回る 指示追従は96.66だ
Liquid AIの公表したベンチマークでは、LFM3-1.7Bは自分より大きいQwen3.5の2つを上回った。指示に従う力を測るIFEvalは96.66だった。Qwen3.5-4Bは92.52で、Qwen3.5-9Bは92.08にとどまる。ツール呼び出しを測るBFCL V4は71.39で、4Bの55.12と9Bの62.83より高い。
端末で動かしたときの速さは、AMD Ryzen AI Max+ 395とApple M5 MaxとiPhone 17 Proの3つで測っている。MiniCPM5-2BやGemma 4 E4Bなどと比べ、入力の処理は2.5倍以上速かったという。文章の生成も1.8倍以上速い。測定はllama.cppでQ4_0の量子化を使い、文脈32,768トークン・100トークン生成の条件だ。
LFM3-1.7Bと大きいモデルの公表値
| ベンチマーク | LFM3-1.7B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|
| IFEval(指示追従) | 96.66 | 92.52 | 92.08 |
| BFCL V4(ツール呼び出し) | 71.39 | 55.12 | 62.83 |
M4 ProのMacで8問を試した 思考なしは令和7年を3回誤る
編集部が手元のMacで試すと、形の決まった仕事は安定した。年号と字数の指示は外れた。使ったのはApple M4 Pro(メモリ24GB)のMacで、仕事で使う日本語の問題を8つ投げた。思考を切った設定で3回、思考を入れた既定の設定で1回答えさせている。
最初につまずいたのはMac向けの軽い版だ。4bitのMLX版は10月28日時点のmlx-lmでは読み込めず、モデルのページにも対応は作業中と書かれていた。そこで元の重み(3.46GB)をダウンロードし、transformersで動かした。
| 問題(AInformation独自検証) | 思考なし(3回) | 思考あり(1回) |
|---|---|---|
| 文から会社名・期限・金額をJSONで抜く | 3回とも正しい | 正しい |
| 英文の依頼メールを日本語に訳す | 3回とも自然 | 自然 |
| 3つの道具から予定の検索を選ぶ | 3回とも正しい(年は2025年と書いた) | 同じ |
| 1,200円×35個に消費税10%を足す | 3回とも46,200円(式も書いた) | 46,200円だけを答えた |
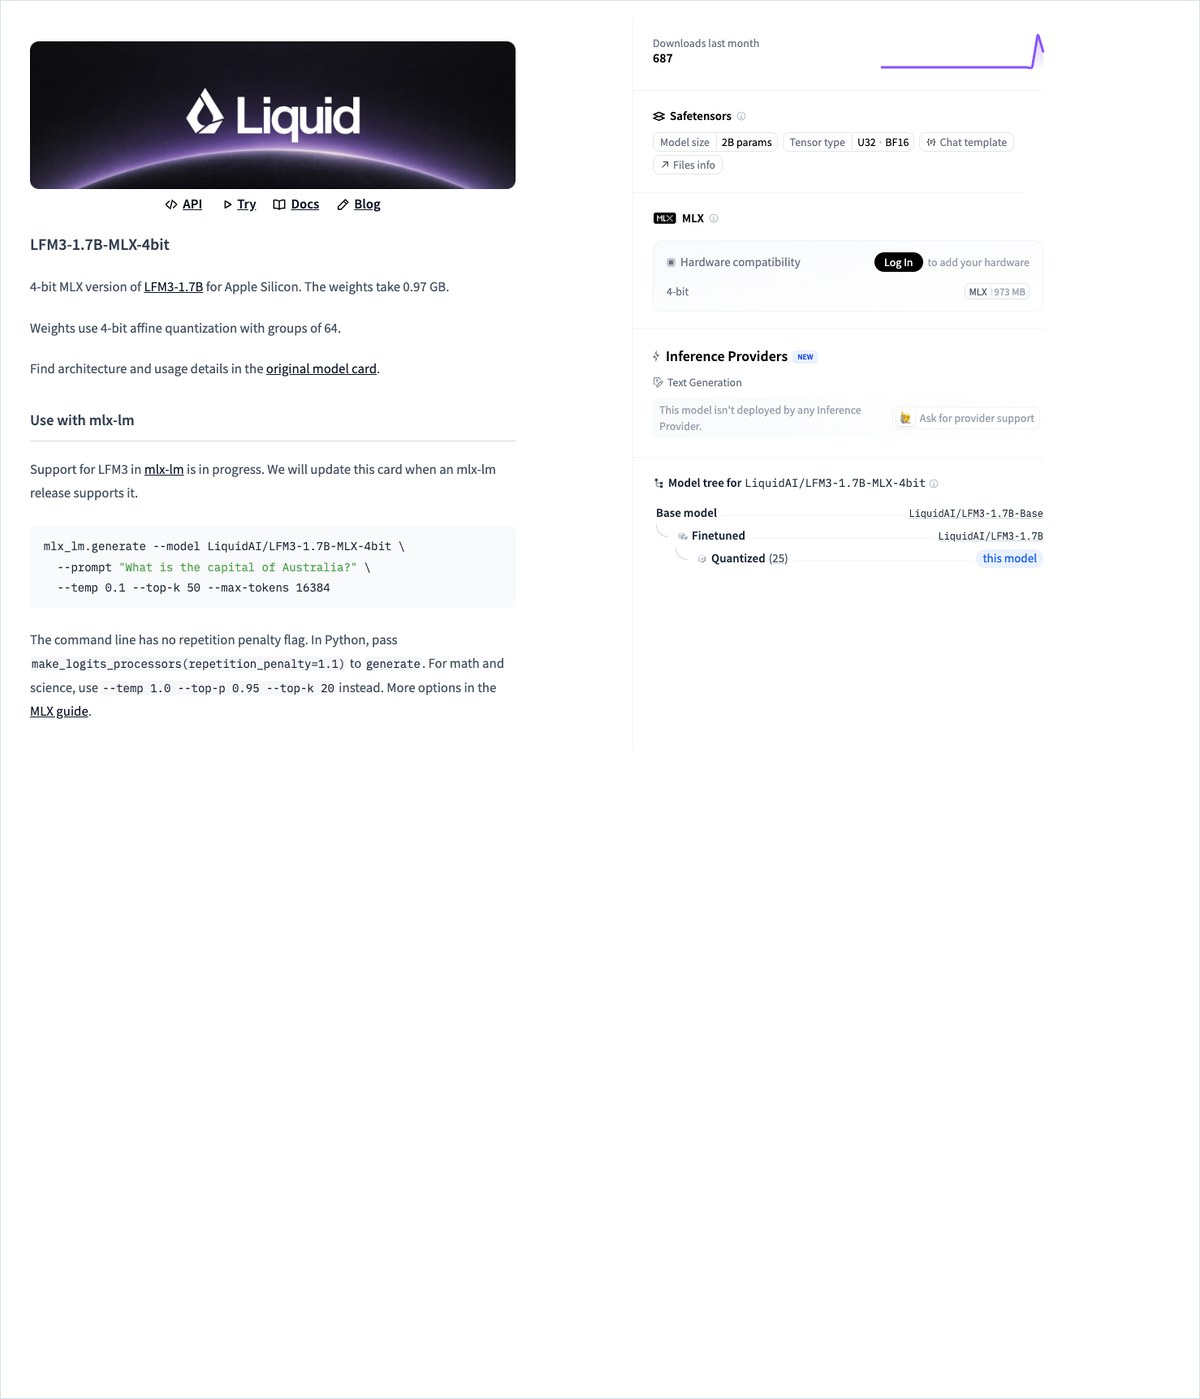
| 令和7年は西暦何年か | 3回とも2024と誤答 | 2025と正答 |
| 会議のコツを20字以内で3つ | 3回中1回だけ守れた | 守れた |
| 説明文を40字以内に要約 | 3回とも60字で超えた | 48字で超えた |
| 納品遅れのおわびメールを150字以内 | 字数は守ったが[理由]の空欄が残った | 書いていない「物流の遅れ」を理由に足した |
検証日は2026年10月28日。Apple M4 Pro(24GB)でtransformers 5.21を使い、bf16の重みをGPUで動かした。温度は0.1。
差が大きかったのは待ち時間だ。思考なしは1問の中央値が0.75秒で、長くても1.84秒で返った。思考ありは英語で長く考えてから日本語で答えるため、中央値は15.9秒になった。8問では131.7秒かかった。
LFM3-1.7Bを社内で試すなら JSON化と翻訳から始める
試すならまず、正解の形が決まっている仕事から手を付けたい。文書から項目を抜いてJSONにする仕事と、短い英文の翻訳は3回とも崩れなかった。社外に出せない書類を手元のPCだけで整える使い方なら、思考なしの速さが生きる。
年号の換算や字数の上限のように、正解が1つに決まる仕事は任せきりにしないほうがいい。思考を入れると令和7年は直ったが、40字の要約は思考ありでも超えた。出力の字数や日付をプログラムで確かめる仕組みと組み合わせるのが前提になる。
メールの下書きでは、指示に無い理由を作る場面があった。取引先へ出す文は、人が中身を読んでから送る流れを残しておきたい。mlx-lmが対応すれば約1GBの4bit版がMacで動くので、そのときは速さをもう一度測り直す。
- BFCL V4
- AIが指示に合わせて正しい道具(関数)を選び、正しい引数で呼び出せるかを測るベンチマーク
企業でこのサイズのモデルを使うなら、相談相手ではなく決まった形に整える係として置くのがよさそうだ。請求書や申込書から項目を抜き、社内の表へ流す作業なら外部のAIにデータを渡さずに済む。ただ思考を入れると1問に十数秒かかり、何百件も回すと待ち時間が業務の流れを止める。思考なしで回して年号や金額だけ別の検査にかける組み方を先に決めておけば、情報システム部門は現場に配る段階で迷わないとみている。
- LFM3-1.7Bは日本語の仕事に使える?
- 形の決まった仕事なら使えるが、年号や字数の指示は外れることがある。編集部が10月28日にM4 ProのMacで試すと、文から会社名と金額をJSONで抜く問題と英文の翻訳は思考なしで3回とも正しかった。一方で令和7年を3回とも2024年と答え、40字以内の要約は思考ありでも48字になった。
- LFM3-1.7BはMacで動かせる?
- 元の重みをtransformersで読み込めば、M4 Proのメモリ24GBのMacで動いた。重みのファイルは3.46GBある。一方で約1GBに収まる4bitのMLX版は、10月28日時点のmlx-lmでは読み込めなかった。モデルのページにも対応は作業中と書かれており、Macで軽く動かすには対応を待つことになる。
- LFM3-1.7Bの思考を切るとどう変わる?
- 答えは速くなるが、間違いが増える。編集部の試験では思考なしの1問の中央値が0.75秒で、思考ありは15.9秒だった。思考ありは英語で長く考えてから日本語で答える。令和7年の換算は思考ありで正しくなったが、思考なしでは3回とも誤った。
この記事の出典
補助資料
- [1]PC Watchこの記事の元にした報道
出典の最終確認日:2026年10月28日