Nerf Benchは発売日を100%とする 今の性能を百分率で示す
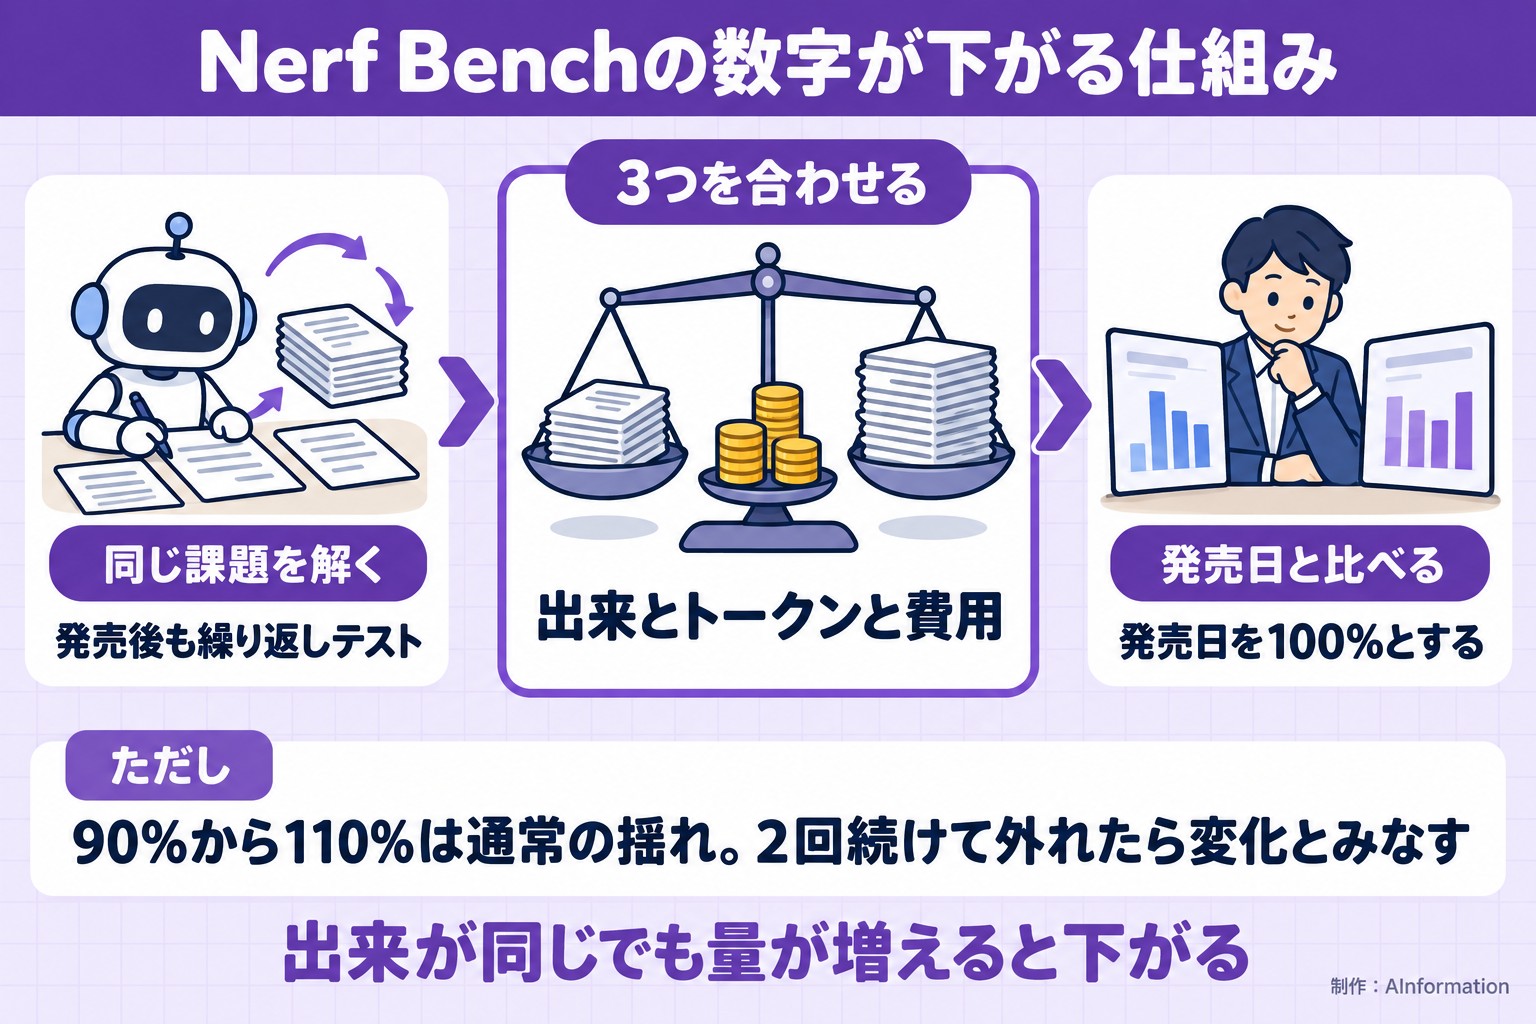
Nerf Benchは、AIモデルが発売日の性能をどこまで保っているかを1つの数字で示すベンチマークだ。コーディング向けAIの独立した評価サイトBridgeBenchが運営している。発売日に測った値を100%とし、その後に同じモデルへ何度もテストを当てて比べる。
数字は課題の出来だけで決まらない。Nerf Benchは「パワー」という指標を使い、課題の出来・使ったトークン数・かかった費用の3つを合わせて出す。出来が同じでも、トークンを多く使えばパワーは下がる。
90%から110%の間は通常の揺れとして扱う。この範囲を2回続けて外れたときに初めて性能が変わったと判断する。1つの課題だけ悪くても劣化とはみなさない。
- 9/22Claude Opus 5.5の基準となる初回テスト
- 10/2Opus 5.5が94.2%まで下がる
- 10/9最新のテストで4モデルとも通常の範囲
- 10/13AInformationがNerf Benchの画面を確認
Opus 5.5は95.7%で最下位 4モデルとも正常の範囲
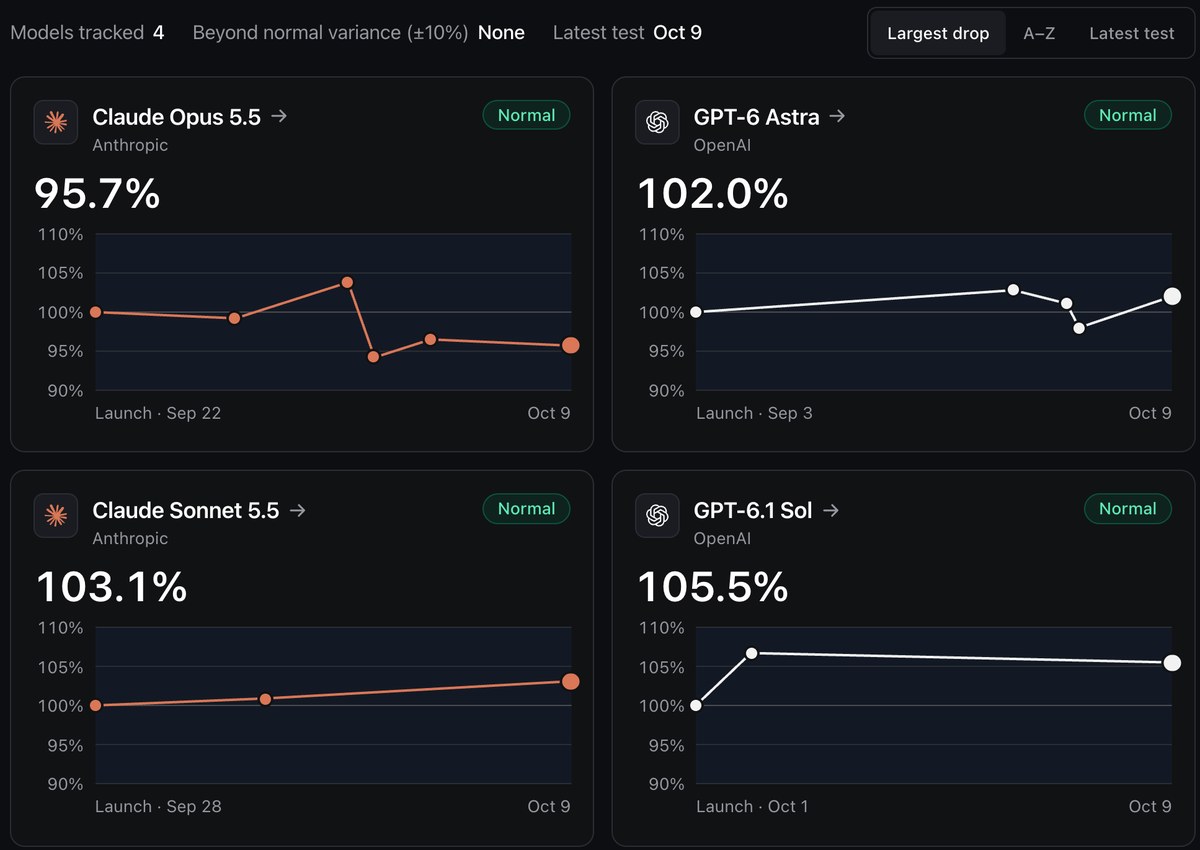
AInformationが10月13日にNerf Benchのページを開いたところ、追跡しているモデルは4つだった。最新のテストは10月9日で、4つとも「Normal(通常の揺れ)」と判定されていた。
| モデル | 基準の日 | 10月9日の値 | 発売後でいちばん低い値 |
|---|---|---|---|
| Claude Opus 5.5 | 9月22日 | 95.7% | 94.2%(10月2日) |
| GPT-6 Astra | 9月3日 | 102.0% | 98.0%(10月2日) |
| Claude Sonnet 5.5 | 9月28日 | 103.1% | 100.9%(10月2日) |
| GPT-6.1 Sol | 10月1日 | 105.5% | 105.5%(10月9日) |
4モデルの中で発売時の値を下回ったのはClaude Opus 5.5だけだ。10月1日に103.8%まで上がったあと、翌10月2日に94.2%へ落ちた。1日で大きく動いたが、90%の線は一度も割っていない。
いちばん上はGPT-6.1 Solの105.5%で、今の数字ではClaude Opus 5.5よりGPT-6.1 Solのほうが発売時の力を保っている。Solは発売翌日の10月2日に106.7%を出した。同じAnthropicでもClaude Sonnet 5.5は103.1%で、発売時を上回っている。
Geminiは対象外 テストの中身も公開されていない
このベンチマークで分かるのは、いまのところAnthropicとOpenAIの4モデルだけだ。ページを開いても、GeminiやGrokのモデルは一覧に出てこなかった。日本で使う人が多いGeminiの劣化を確かめる用途には、まだ使えない。
もう1つの制約は、テストの中身が見られないことだ。どんな課題を出したかも個々の結果も非公開とされている。運営側は、結果の信頼性を保ちベンチマーク向けの不正を防ぐためだと説明している。
そのため、95.7%という数字がどの作業の出来から来ているのかは外から追えない。パワーにはトークン数と費用も入っている。答えの質は同じまま、答えるのに使う量が増えただけでも数字は下がる。
「最近Claudeが鈍い」と感じたら まず同じ指示で比べ直す
AIが発売後にこっそり弱くなったという声は、新しいモデルが出るたびに上がる。Nerf Benchはそれを外から数える試みの1つで、Claude Opus 5.5については10月9日の時点で劣化と呼べる差は出ていない。
手元で鈍くなったと感じたときは、印象で決めないほうがよい。同じ指示文を残しておき、答えの質・かかった時間・使ったトークン数を並べて記録するとよさそうだ。APIで使っているなら、請求額の推移も合わせて見られる。
4モデルとも、次に90%か110%の線を2回続けて越えたときに判定が変わる。Claude Opus 5.5がこのまま95%前後で止まるのか、もう一段下がるのかが次の見どころだ。
- パワー
- Nerf Benchが使う指標。課題の出来に加えて、使ったトークン数と費用を合わせて1つの数字にしたもの。発売日を100%として示す
社内でClaudeを配っている会社では「最近答えが雑になった」という声が必ず出る。そのたびに契約やモデルの切り替えを検討するのは手間が大きい。Opus 5.5の95.7%は、発売時より少し下がったが劣化とは言えない位置だとみている。ただしNerf Benchは課題がコーディング寄りで中身も非公開だ。自社の業務で同じことが起きているかは別の話になる。よく使う指示を5本ほど決めておき、月に1回同じ条件で投げて残しておくと、声が上がったときに数字で答えられる。
- Claude Opus 5.5は劣化した?
- Nerf Benchの判定では劣化していない。10月9日の値は発売時の95.7%で、追跡している4モデルの中で唯一100%を下回った。ただし90%から110%は通常の揺れとされ、この範囲を2回続けて外れない限り性能が変わったとはみなされない。いちばん低かったのは10月2日の94.2%だった。
- Nerf BenchでGeminiの劣化は確かめられる?
- 10月13日時点では確かめられない。追跡しているのはClaude Opus 5.5とClaude Sonnet 5.5、GPT-6 Astra、GPT-6.1 Solの4モデルだけで、GeminiとGrokのモデルは入っていなかった。日本で使う人が多いAIでも対象外のものがある点に気をつけたい。
- Nerf Benchの値が下がったら答えの質が落ちたということ?
- そうとは限らない。Nerf Benchのパワーは課題の出来に加えて、使ったトークン数とかかった費用を合わせて出す。答えの質が同じでも、答えるのに多くのトークンを使えば値は下がる。テストの課題と個々の結果は非公開なので、どの要素で下がったかは外から分からない。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年10月13日