Super VLは1200億パラメータ 画像と動画も1つで読む
NVIDIAは10月15日、文章と画像と動画をまとめて扱えるオープンウェイトのAIモデル「Nemotron 3.5 Super VL」を公開した。AIエージェントの仕事に向けたモデルで、推論と画像・動画の読み取りと外部ツールの操作を1つでこなす。前の「Nemotron 3 Super」に画像と動画を扱う力を足した版だ。
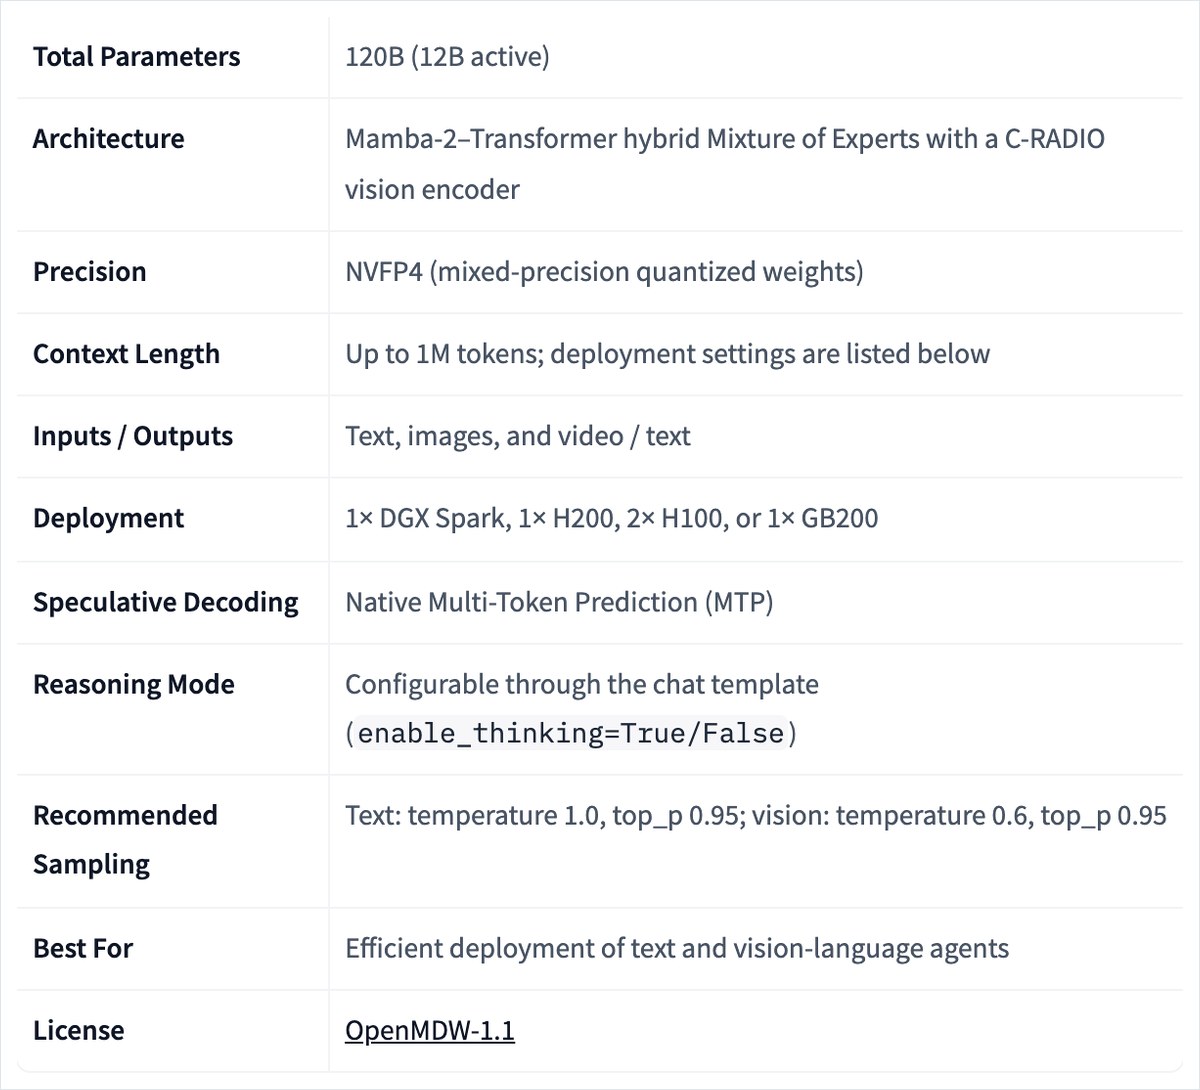
全体は1200億パラメータだが、1トークンを処理するときに動くのは120億パラメータだけだ。必要な部分だけを動かすMixture of Experts(MoE)という作りを使っている。NVIDIAは1台のGPUでの処理量が同じ規模のオープンモデルの最大5倍になるとし、グラフを読み取る力を測るCharXivでは80.8%を記録した。
モデルの重みはHugging Faceで公開され、商用利用と追加学習にも対応している。使う条件はOpenMDW-1.1という利用許諾で決まる。
日本語は学習の対象 日本語だけの成績は載っていない
AInformationがHugging Faceの説明書を開くと、対応言語の欄に日本語が入っていた。仕上げの学習でも英語のほかに日本語など6言語に力を入れたと書いてある。
一方で、ベンチマークの表に日本語だけの成績は出てこなかった。多言語の問題集MMLU-ProXの点は元の版が76.91で、メモリを減らすために軽くした版(NVFP4)は73.76に下がる。
OpenRouterに提供元が6つ 有料の最安は出力0.40ドル
自前のGPUが無くても、APIで呼び出せば試せる。AInformationが10月16日にAPIの仲介サービスOpenRouterの登録情報を調べると、このモデルの提供元は6つあった。料金は次のとおりだ。
| 提供元 | 入力100万トークン | 出力100万トークン | 1回に渡せる長さ |
|---|---|---|---|
| Nvidia(無料版) | 0ドル | 0ドル | 1,000,000トークン |
| Crusoe | 0.10ドル | 0.40ドル | 262,144トークン |
| Together | 0.15ドル | 0.50ドル | 262,144トークン |
| CoreWeave | 0.15ドル | 0.75ドル | 1,048,576トークン |
| DeepInfra | 0.20ドル | 1.00ドル | 262,144トークン |
| Venice | 0.25ドル | 1.25ドル | 262,144トークン |
AInformation調べ(10月16日・OpenRouterの公開API)。料金は100万トークンあたりの値段。
有料でいちばん安いCrusoeを1ドル157.98円(10月15日の欧州中央銀行の値)で直すと、100万トークンあたり入力15.8円・出力63.2円になる。AnthropicのClaude Haiku 5.5は10万トークン以下で入力0.10ドル・出力0.50ドルなので、出力はCrusoeのほうが安い。
ただし説明書にある100万トークンをそのまま渡せるのは、有料ではCoreWeaveだけだった。長い契約書や動画をまとめて読ませるなら、提供元の選び方で上限が262,144トークンか1,048,576トークンかに分かれる。
0円のAPIは利用が記録される 社外秘は入れられない
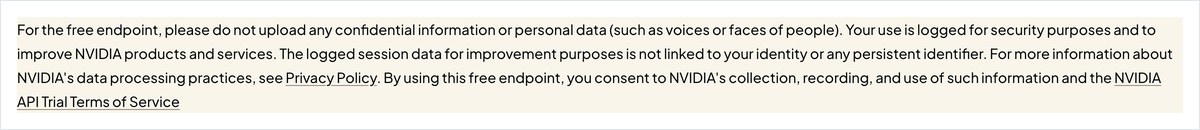
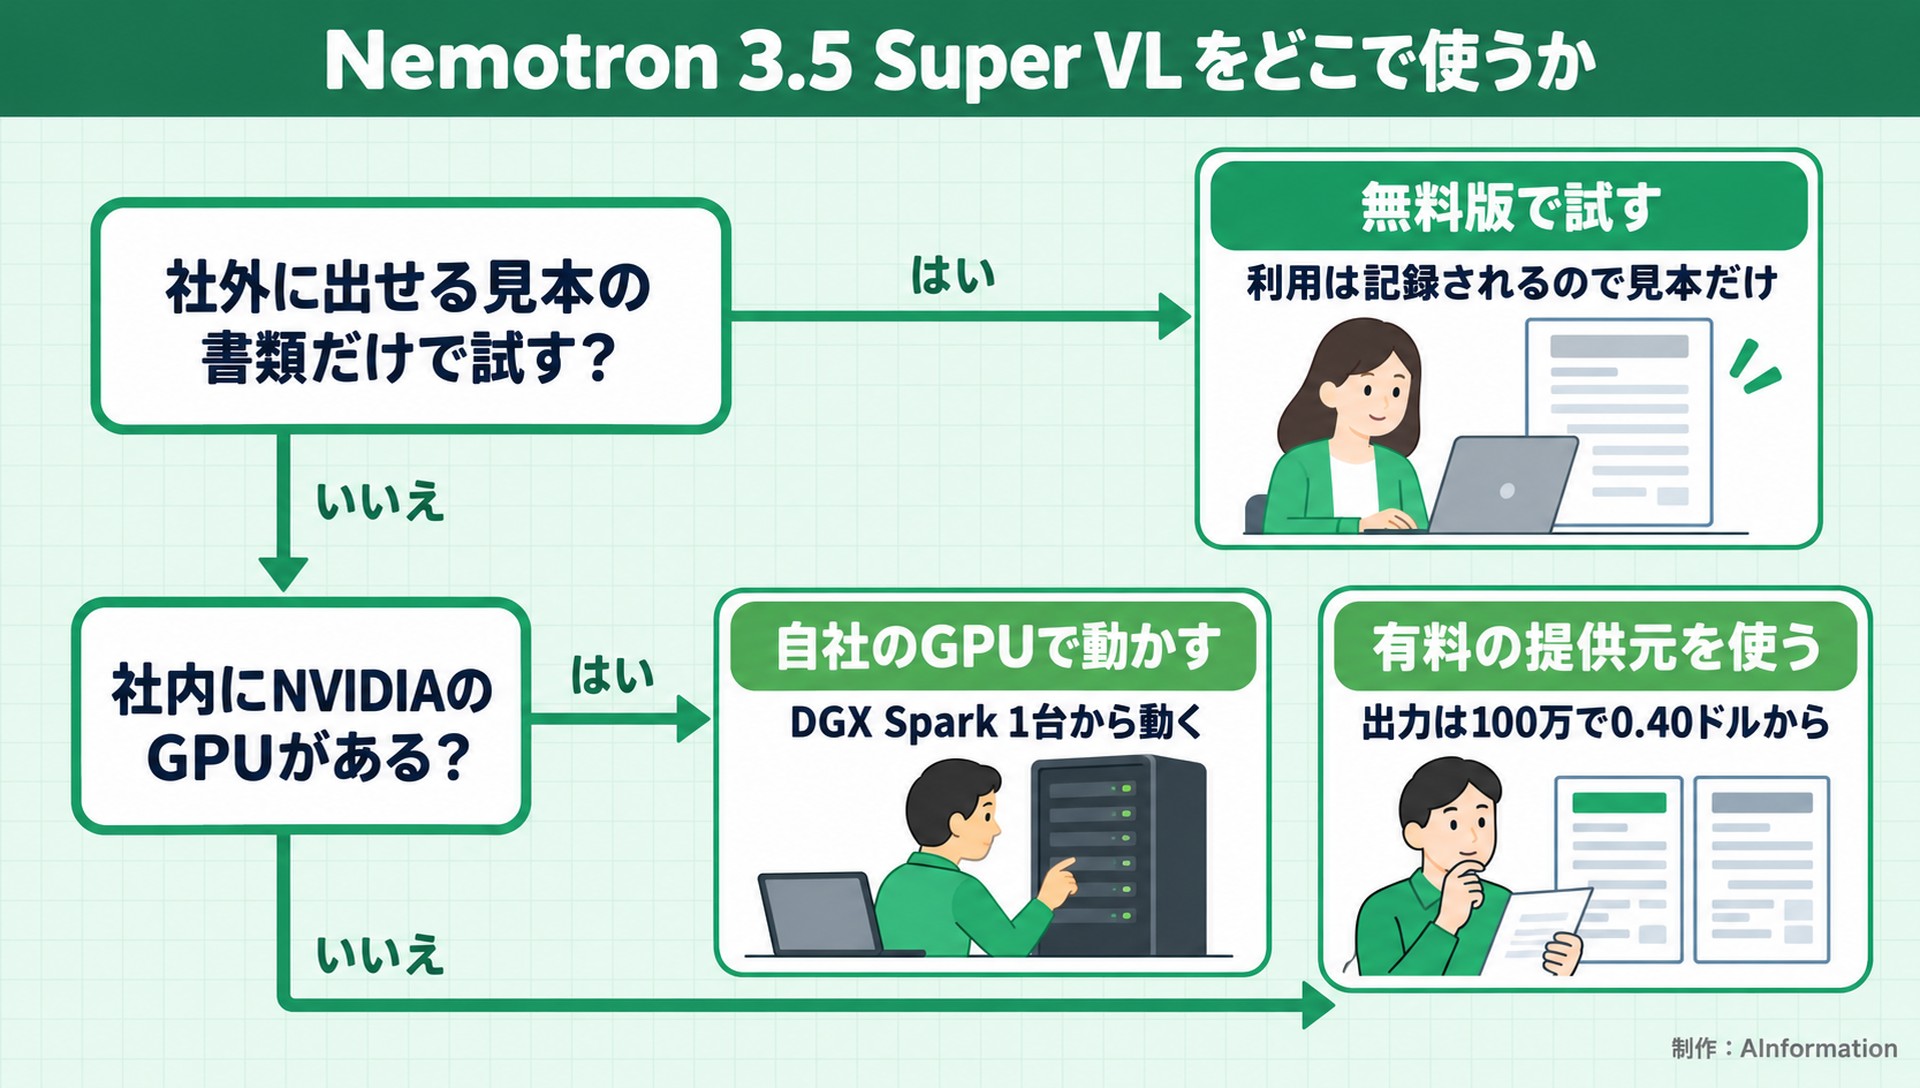
OpenRouterで0円で呼べるのは、NVIDIA自身が出している無料版だけだ。OpenRouterの無料版のページには、社外秘の情報や個人のデータ(人の声や顔など)を入れないよう求める注意書きがあった。利用はセキュリティとNVIDIAの製品改善のために記録され、使った時点でその記録に同意したことになる。
改善用の記録は本人や固定のIDとは結び付けないとも書いてある。それでも見積書や顧客名の入った資料を無料版で読ませるのは避けたほうがよい。社内の書類で試すなら、有料の提供元を選ぶか自社のGPUで動かすことになる。
自社で動かすならDGX Spark 1台から Macの手順は無い
説明書が挙げる構成は、DGX Spark 1台・H200 1台・H100 2台・GB200 1台のどれかだ。手元のパソコンではDGX SparkとRTX SparkとRTX Pro 6000に向けて、llama.cppとUnslothで動かす手順が案内されている。Macで動かす手順は載っていなかった。
Metaが同じ時期に公開したMuse Spark Openは、M5 Ultraを積んだMac Studioを2台つないで動かす作りだった。同じ公開モデルでも、社内にどちらの会社の機械があるかで選ぶものが変わる。
40分の1は追加学習のあと まず見本の書類で比べる
処理コストを40分の1にした事例は、そのまま使った結果ではない。Scale AIがエンターテインメント企業のSkydance向けに、請求書や返金・値引きの書類から未回収の金額を調べるよう追加学習したモデルの数字だ。Skydanceが使っているAIと同じくらいの正確さのまま、費用は約40分の1に下がった。応答時間は約5分の1になった。
経費管理のRampは、レシートの画像から店名や日付と支払いの情報を抜き出す仕事に使っている。処理の待ち時間は10分の1になると見込む。どちらも決まった形の書類を大量にさばく仕事だ。
試すなら、社外に出してよい見本の請求書やレシートを数枚そろえて有料の提供元で今のAIと読み取りを比べるのが早い。差が小さければ、NVIDIAのNeMoで自社の書類に合わせて追加学習する段階に進める。
- Mixture of Experts
- モデルの中の専門の部分のうち、必要なものだけを動かして処理する作り。今回は1200億のうち120億だけが動く
企業でオープンモデルを試すとき、最初につまずくのは性能より動かす場所だ。無料のAPIで手軽に試した担当者が、そのまま本番の請求書を流してしまうことは起こりそうだ。情報システム部門は、無料版に入れてよいのは見本の書類だけと先に決めて試す人に伝えておきたい。40分の1という数字も追加学習を経た1社の事例なので、同じ効果を見込むなら学習に使える自社の書類を何枚そろえられるかを先に見積もる必要がありそうだ。
- Nemotron 3.5 Super VLは商用利用できる?
- 商用利用できる。NVIDIAはモデルの重みをHugging Faceで公開しており、商用利用と追加学習に対応している。使う条件はOpenMDW-1.1という利用許諾で決まる。ただしOpenRouterの無料版を通して使うと、入れた内容はセキュリティとNVIDIAの製品改善のために記録される。社外秘の書類は有料の提供元か自社のGPUで扱うほうが安全だ。
- Nemotron 3.5 Super VLは無料で使える?
- モデル代を0円で済ませる道は2つある。1つはHugging Faceから重みを落として自社のGPUで動かす方法で、説明書はDGX Spark 1台やH100 2台などの構成を挙げている。もう1つはOpenRouterでNVIDIAが出している無料版を呼ぶ方法だ。無料版は1回に1,000,000トークンまで渡せるが、利用は記録されるので社外秘や個人のデータは入れないよう求められている。
- Nemotron 3.5 Super VLは日本語で使える?
- Hugging Faceの説明書では対応言語に日本語が入っている。仕上げの学習でも英語のほかに日本語など6言語に力を入れたと書かれている。ただしベンチマークの表に日本語だけの成績は無い。多言語の問題集MMLU-ProXの点は軽くした版で76.91から73.76に下がるので、自社の書類で読み取りを試してから決めたい。
この記事の出典
補助資料
- [1]GIGAZINEこの記事の元にした報道
出典の最終確認日:2026年10月16日