OpenAIがtextGrainを発表 ChatGPTとCodexはEUだけ
OpenAIは10月5日にChatGPTとCodexが出す文章へ見えない透かしを入れると発表した。数週間かけてEU域内の対象ユーザーに全プランで広げる。世界共通の初期設定にはしないと明言している。
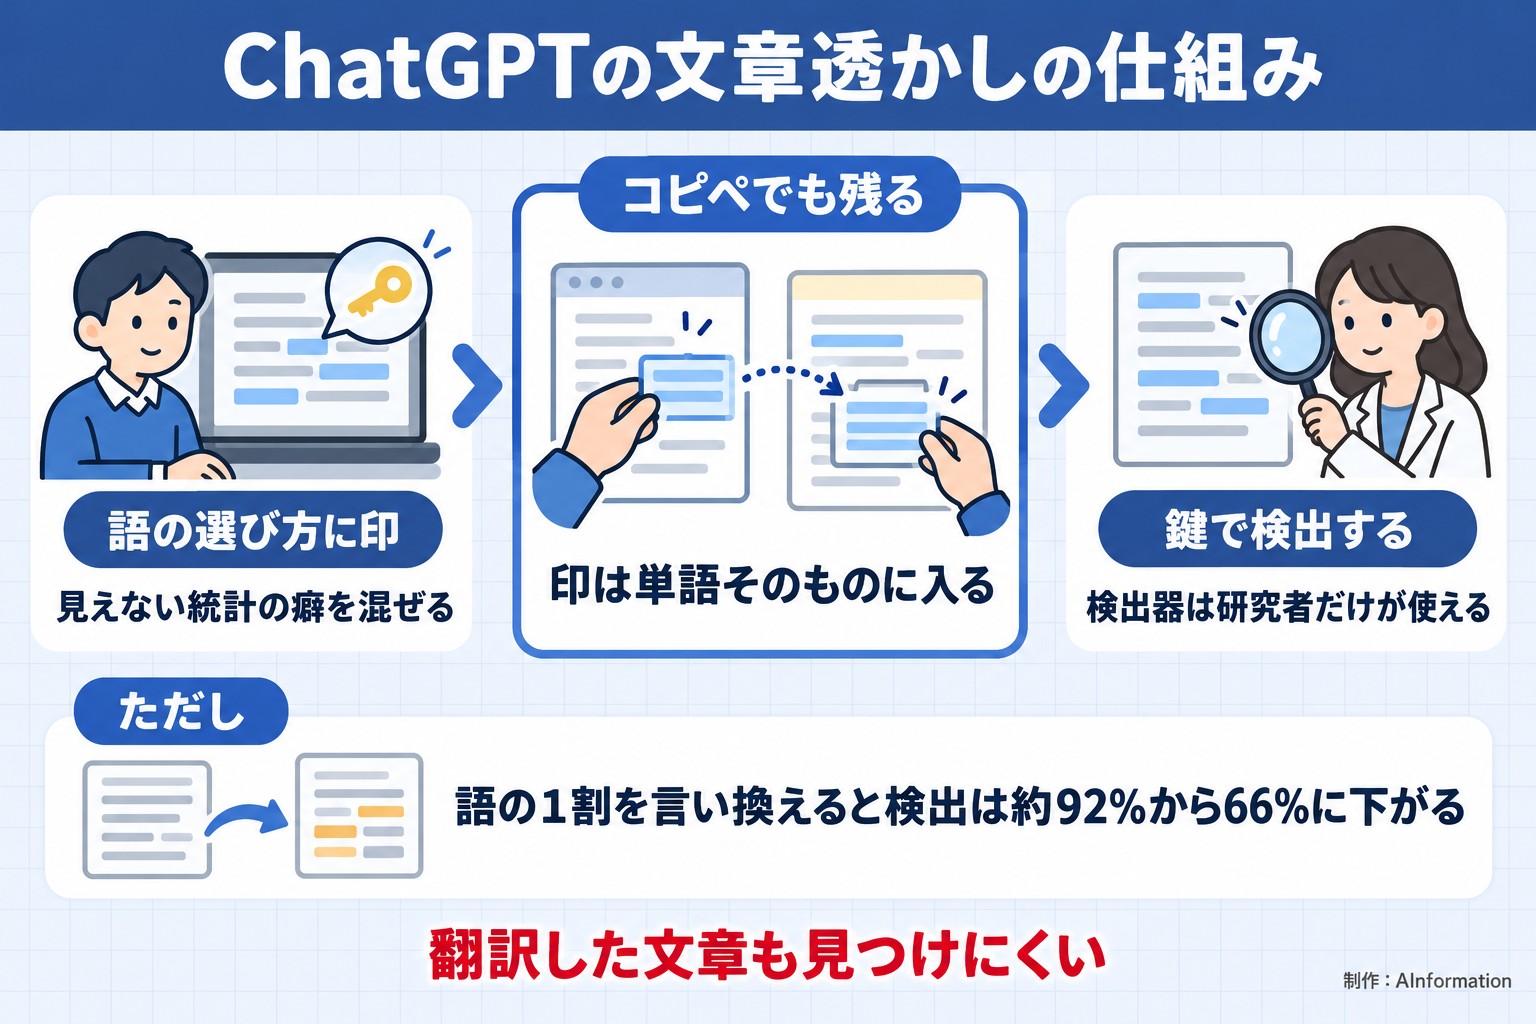
透かしの技術はtextGrainと呼ぶ。記号を足すのではなくモデルの単語の選び方に統計的な癖を混ぜる。人の目では分からないが検出器は拾える仕組みだ。
印が単語そのものに入るのでコピーして貼り付けても残る。OpenAIは透かしで利用者は特定されないと説明している。透かしを入れても性能に目立った差は出なかったという。
きっかけは8月2日に発効したEU AI法の透明性ルールだ。生成した文章を機械で見分けられる形にするよう求めている。OpenAIは画像と音声については判定ツールをすでに一般公開しており、そちらはこれまでどおり使える。
- 2024OpenAIが透かしを作るも公開を見送ったとWSJが報道
- 8/2EU AI法の透明性ルールが発効
- 8月AnthropicがClaudeの文章に世界で透かしと発表
- 10/5OpenAIがEUのChatGPTに透かしを入れると発表
APIは世界で選べる 既定はオフで検出器は非公開
日本から使う人に直接関わるのはAPIのほうだ。10月5日から世界中のAPI利用者が一部のモデルで透かしを選んでオンにできる。初期設定はオフのままだ。
| 対象 | 透かしの扱い | いつから |
|---|---|---|
| EUのChatGPT・Codex | 全プランで自動で入る | 数週間かけて順次 |
| 日本などEU以外のChatGPT | 入らない(世界共通にはしない) | 未定 |
| 世界のAPI利用者 | 一部モデルで選んでオン | 10月5日から |
| 検出器 | 承認された研究者と専門機関だけ | 10月5日から申請受付 |
透かしがあるかを調べる検出器は一般には公開しない。見逃しと誤検出のおそれがあるためだ。検出器が返すのはOpenAIの透かしがあるかどうかだけで、利用者や会話の中身は明かさないとしている。
技術はオープンソースで公開する予定だ。クラウドの提携先を通したOpenAIのモデルにも数週間で広げる。
ChatGPTとClaudeの文章透かし
| 項目 | ChatGPT・Codex | Claude |
|---|---|---|
| 対象の地域 | EUだけ | 世界全体 |
| 発表した時期 | 10月5日 | 8月 |
| 方式 | 自社のtextGrain | SynthIDがもと |
| APIでの扱い | 世界で選んでオン(既定オフ) | 記載なし |
| 日本のChatGPT・Claude | 入らない | 対象に入る |
言い換え1割で検出は66% 翻訳や数式も見つけにくい
OpenAIは自社の技術報告書で弱点も数字で出している。400トークンの文章で語の10%を同じ意味の別の語に置き換えると、検出率は約92%から66%に落ちた。
短い文章ほど見つけにくい。誤検出を1%に抑えた条件で、心理学のような文章なら400トークンで約95%を見つけたが200トークンでは約80%だった。数学の答えは語の選び方の幅が狭く検出率がかなり下がる。
翻訳した文章も見つけにくいと書いている。日本語で使う人にとってはここが大きい。英語で書かせて日本語に訳した文章は、印が薄まる側に入る。
OpenAIは「透かしが無いことは人が書いた証明にならない」とも断っている。短すぎる文や手を入れた文、他社のAIの文は検出されないからだ。透かしがあっても人がどれだけ手を加えたかまでは分からない。
Claudeは世界で透かし 日本の会社が確かめておく所
同じ動きを先にしたのはAnthropicだ。2か月前にClaudeの文章へ透かしを入れると発表し、こちらは世界全体に適用している。範囲で比べるとClaudeのほうが広く、日本で使う分も対象になる。
Anthropicの発表には一部の利用者が反発した。指示や文脈や判断を出したのは自分でClaudeは道具にすぎない、という声だ。OpenAIは2024年に透かしを作りながら公開を見送ったとWSJが報じており、利用者が他社へ移ることを気にしたと伝えられている。
日本の会社が先に確かめておきたいのは2点だ。1つはEUの拠点や社員がChatGPTやCodexで作った文書に透かしが入ること。もう1つはAPIで顧客向けに文章を出しているなら、透かしを選ぶかどうかを決めておくことだ。ChatGPT側で利用者が切り替えられるとは書かれておらず、学習させない設定のように自分で外せるものとして説明されていない。
透かしは見分けるための材料の1つで、AIが書いたかどうかの判定には使えない。社内のルールで「透かしの有無で判断する」と決めるのはまだ早い。
- textGrain
- OpenAIの文章用の透かし技術。モデルの単語の選び方に見えない統計の癖を混ぜ、秘密の鍵を持つ検出器だけがそれを見つける
- 誤検出
- 透かしが無い文章を、透かしがあると判定してしまう誤り。OpenAIはこのおそれを理由に検出器を一般公開していない
企業の導入支援で気になるのは、透かしを不正の証拠に使おうとする動きが出ることだ。今回の数字だと語の1割を変えるだけで検出は3分の2まで落ち、日本語へ訳した文は印が薄まる側に入る。人事や学校が「透かしが出なかったから本人が書いた」と判断すると誤りになる可能性がある。一方でEUに拠点がある会社は、現地の社員がChatGPTで書いた提案書に透かしが入る前提で、顧客への説明を用意しておくとよさそうだ。
- 日本で使うChatGPTの文章にも透かしは入る?
- 入らない。OpenAIが透かしを入れるのはEU域内の対象ユーザーのChatGPTとCodexだけで、数週間かけて全プランに広げる。世界共通の初期設定にはしないと明言しており、日本など他の地域へ広げる時期は示していない。一方でClaudeは8月の発表で世界全体に透かしを入れており、日本の利用分も対象になる。
- OpenAIのAPIで透かしは付けられる?
- 付けられる。10月5日から世界中のAPI利用者が一部のモデルで透かしを選んでオンにできる。初期設定はオフなので何もしなければ入らない。顧客へ出す文章に透明性の義務があるかどうかを見て、会社ごとに決める形だ。クラウドの提携先を通したOpenAIのモデルにも数週間で広げる予定になっている。
- 透かしで誰が書いたか特定される?
- 特定されないとOpenAIは説明している。検出器が返すのはOpenAIの透かしがあるかどうかだけで、利用者や指示文、会話の中身は明かさない。検出器そのものも一般には公開せず、承認された研究者と専門機関だけに申請制で開く。見逃しと誤検出のおそれがあるためだ。
- 透かしが出なければ人が書いた証明になる?
- ならない。OpenAI自身が「透かしが無いことは人が書いた証明にならない」と書いている。400トークンの文章で語の1割を言い換えると検出率は約92%から66%に落ち、200トークンの短い文では約80%にとどまる。翻訳文や数学の答え、他社のAIが書いた文も検出されにくい。
この記事の出典
補助資料
- [1]TechCrunchこの記事の元にした報道
出典の最終確認日:2026年10月6日