EmbeddingGemma 2が0円公開 写真も声も1つで探す
Googleは10月6日(現地時間)、検索用のAIモデル「EmbeddingGemma 2」を無償で公開しました。写真・動画・音声・文字・コードの5種類を1つのモデルで扱えます。重みはHugging FaceとKaggleで配られ、ライセンスは商用利用もできるApache 2.0です。
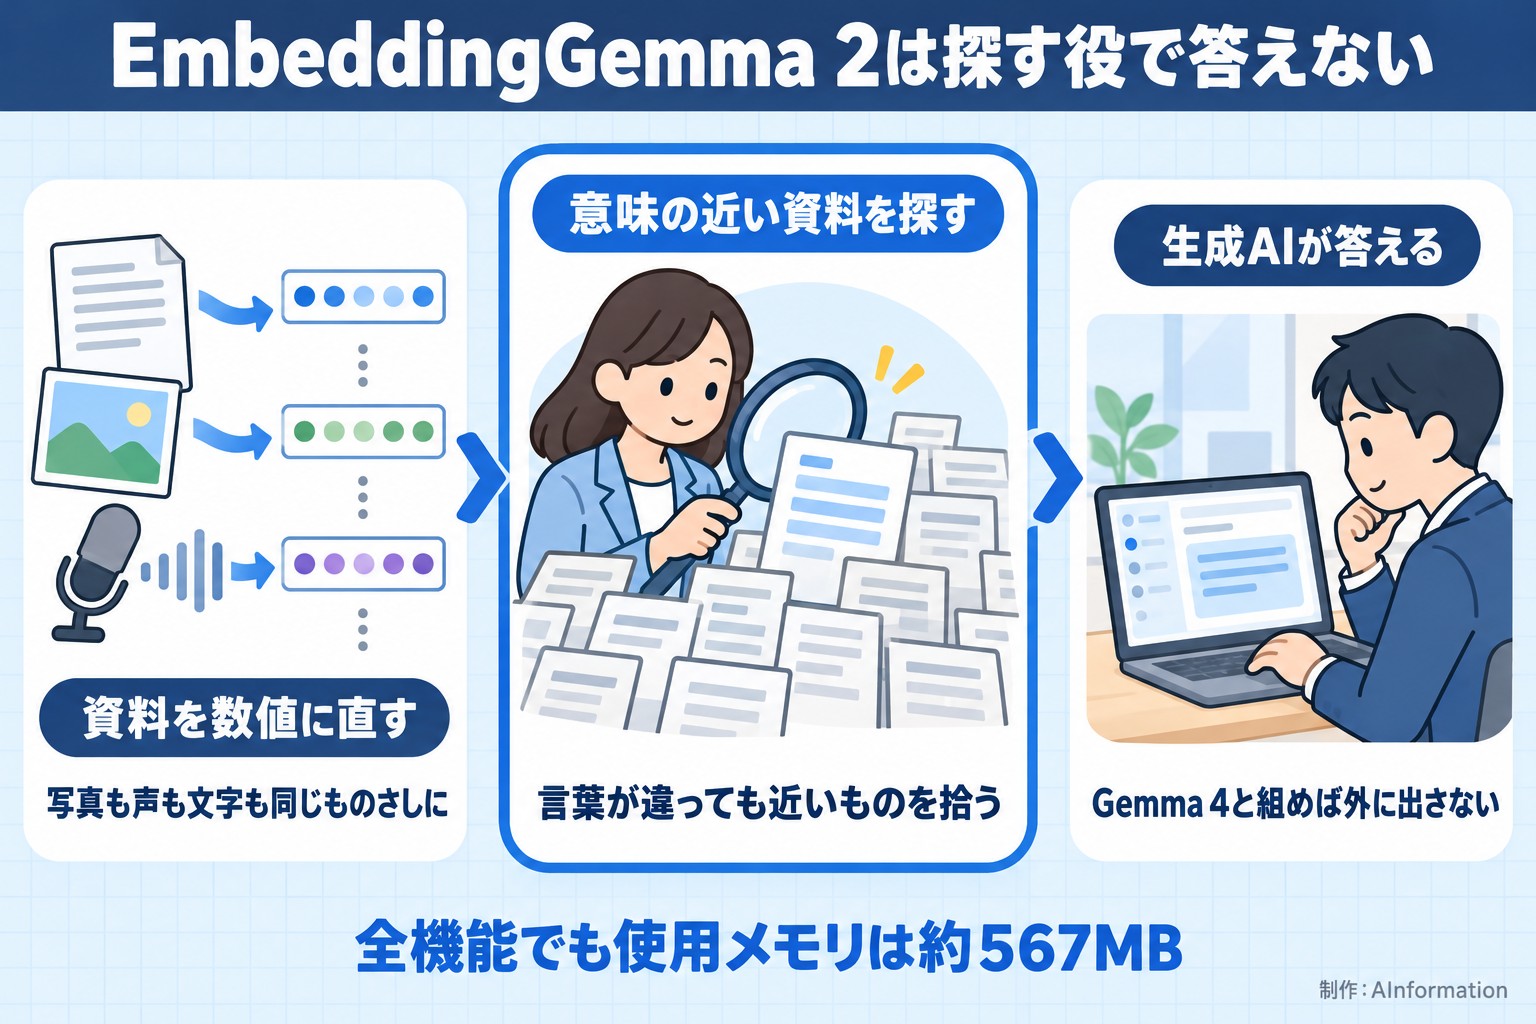
このモデルは文章を書かず、データの意味を数値の並びに直す「埋め込み」を受け持ちます。意味の近いデータが近い位置に並ぶので、キーワードが一致しなくても探せる仕組みです。
- 10/6GoogleがEmbeddingGemma 2を無償で公開
- 10/10Model Gardenでの提供開始日はまだ出ていない
スマホでも全機能で約567MB 得意はコードと画像だ
パラメータ数は0.74B(7億4,000万)です。量子化すればPixel 11 Proでの使用メモリは文字だけで約191MB、全機能でも約567MBに収まります。処理は端末の中で終わり、検索するファイルは外へ送られません。
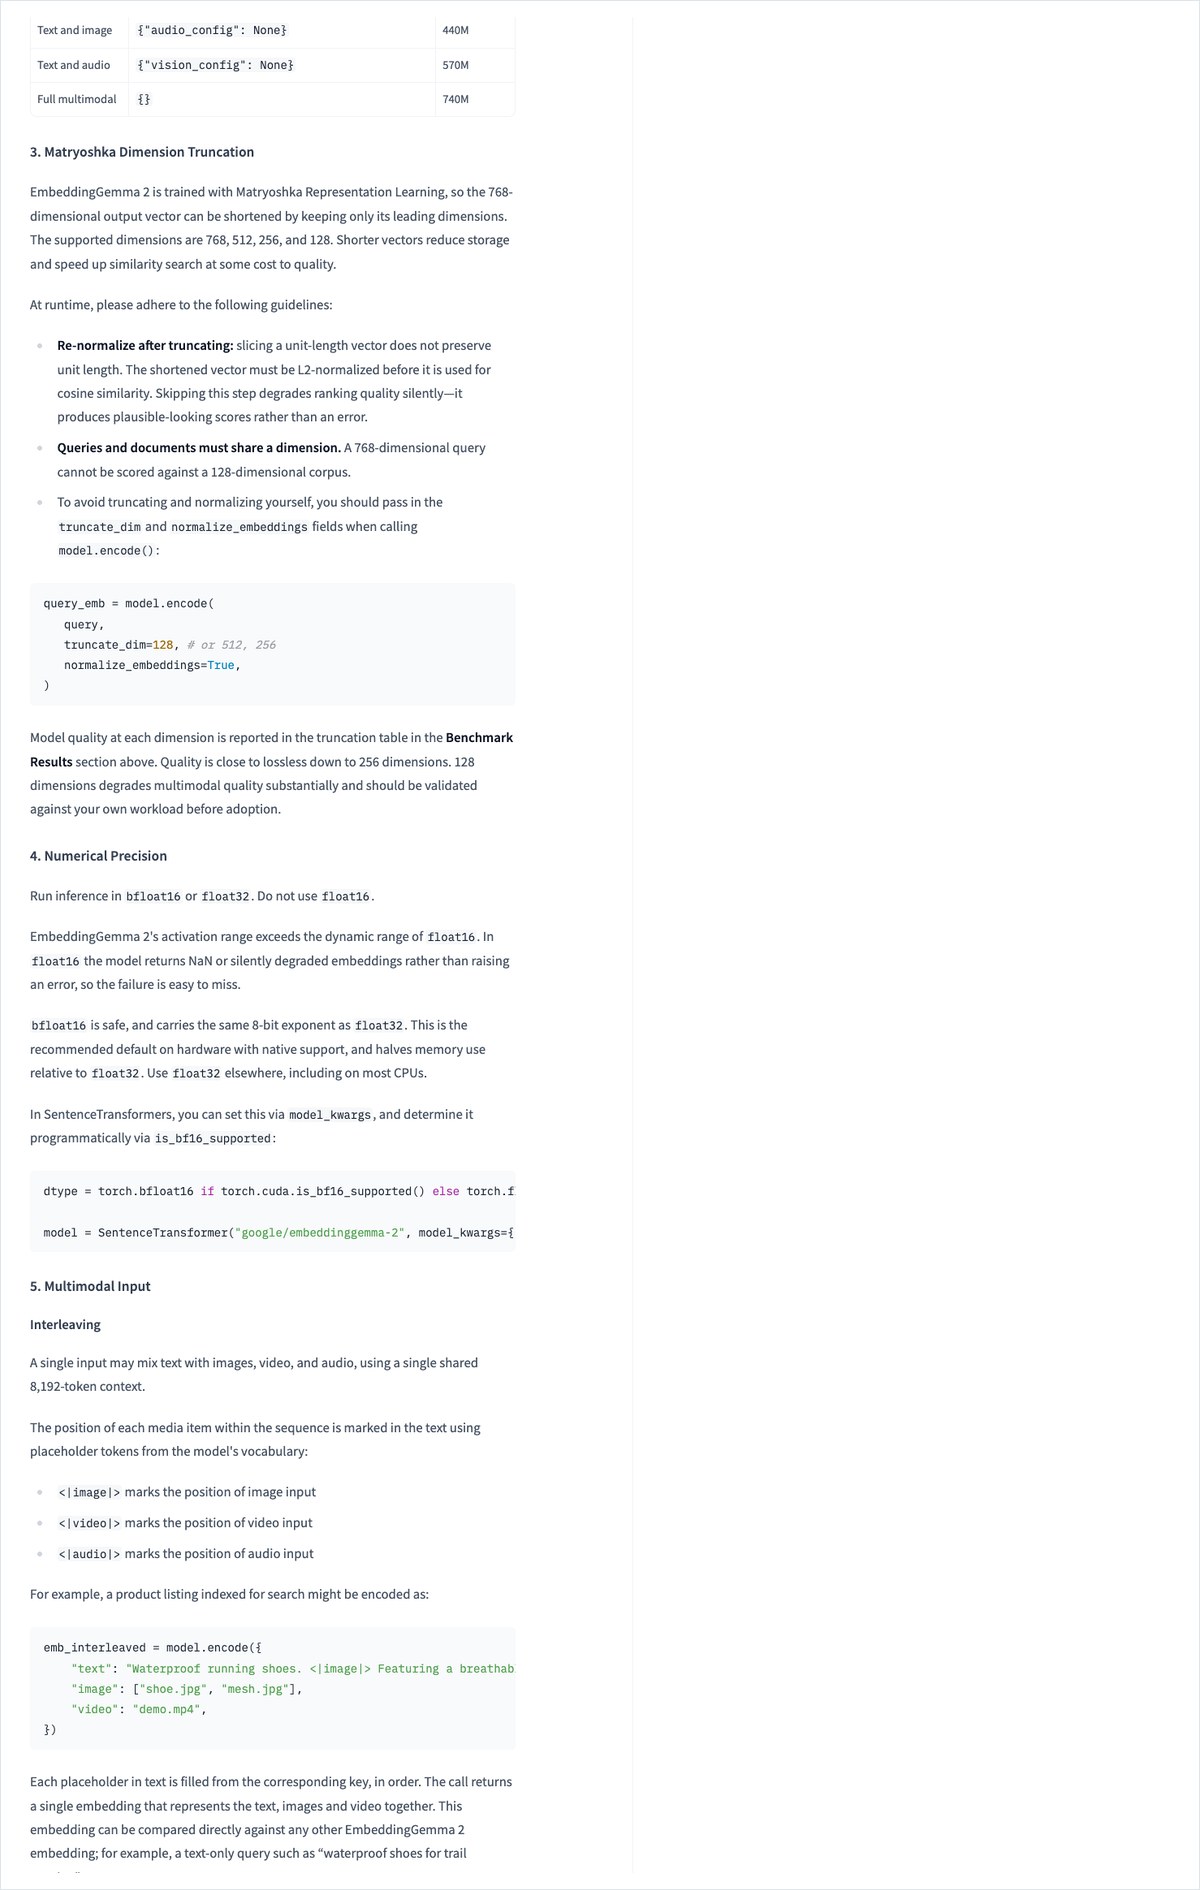
文字用の本体は0.27Bで、画像用の0.17Bと音声用の0.3Bは要るときだけ足します。Matryoshka Representation Learningという学習法で、数値の個数は768個から128個まで減らせる作りです。検索用データベースの容量は最大6分の1になります。
Googleの公表値では得意と苦手がはっきり分かれました。日本語を含む多言語の文字検索は、他社のjina-embeddings-v5-omni-nanoに届いていません。
| 測った中身 | EmbeddingGemma 2 | 前の版 | jina |
|---|---|---|---|
| コード検索(MTEB Code) | 78.68 | 68.76 | - |
| 画像検索(MIEB lite) | 64.6 | - | 49.4 |
| 多言語の文字検索 | 61.4 | - | 65.5 |
| 音声検索(MAEB) | 49.4 | - | 50.1 |
日本語の社内規程12問 旧版とOpenAIは11問で新版は10問
AInformationは10月10日、日本語の社内資料を探せるかを手元のMacで確かめました。架空の社内規程12本に、規程の言葉を避けた質問を12問投げています。比べたのは前の版のEmbeddingGemma(300m)と、ChatGPTの開発元OpenAIの有料API「text-embedding-3-small」です。
| モデル(数値の個数) | 1位で当てた数 | 上位3件に入った数 |
|---|---|---|
| EmbeddingGemma 2(768) | 10/12 | 12/12 |
| EmbeddingGemma 2(128) | 8/12 | 11/12 |
| 前の版 300m(768) | 11/12 | 12/12 |
| 前の版 300m(128) | 10/12 | 12/12 |
| OpenAI text-embedding-3-small(1536) | 11/12 | 12/12 |
日本語の文字検索では、前の版とOpenAIのほうが1問上回りました。新版だけが取り違えたのは「来週の金曜に休みを取りたい。いつまでに言えばいい?」で、1位は有給休暇でなく慶弔休暇でした。「週末に個人でWebデザインの仕事をしてもいい?」は3つとも副業でなく在宅勤務を1位に出しています。
数値を128個に縮めると差が開きました。新版は8問に落ち、前の版は10問を保っています。容量を6分の1にする設定は、自社の質問で試してから使うほうがよさそうです。
試験の条件:2026年10月10日にM4 ProのMacのCPUで実行。新版は文字の部分だけを読み込み、検索用の前置きは配布ページの説明どおり付けました。前の版はGoogleの配布ページが利用への同意を求めるので、unslothが公開している写しを使っています。
ダウンロードは約1.5GBで56秒でした。質問と規程の計24本を数値に直すのにかかったのは0.54秒です。
文字だけの検索なら急がない Model Gardenは開始日が未定
日本語の文書だけを探すなら、急いで替える理由は見えませんでした。乗り換える理由が立つのは、写真・動画・音声を文字と同じ検索に入れたいときです。今回は文字だけを試したので、種類をまたぐ検索の出来は測れていません。
試すだけならブラウザかスマホアプリ「Google AI Edge Gallery」の検索デモで足ります。法人向けのGemini Enterprise Agent Platform Model Gardenでの提供は「近日」とだけ案内され、開始日は10月10日時点で出ていません。
- 社内でよく聞かれる質問を20問ほど集め、正しい資料が1位に来るかを数える
- 文字だけ使うなら画像と音声の部分を外して読み込み、メモリを抑える
- 数値を128個に縮める前に、768個との正答の差を確かめる
前の版は公開から約1年で2,000万ダウンロードを超えました。後継の出番は、図面の写真や会議の録音まで社内の検索に入れる会社から始まりそうです。
- 埋め込み
- 写真や文章の意味を数値の並びに直す処理。意味の近いデータほど近い位置に並ぶので、言葉が違っても探せる
- Matryoshka Representation Learning
- 数値の個数を768個から128個まで減らしても使えるように学ばせる方法。検索用の保存容量を最大6分の1にできる
社内資料のRAGを相談されると、最初に止まるのは「資料を外部のAPIに送れない」という社内の決まりです。EmbeddingGemma 2はそこを0円で越えられる一方、日本語の文字検索では前の版やOpenAIと並ぶ水準にとどまりました。乗り換えを急ぐより、図面の写真や会議の録音まで1つの検索に入れたい部署から試すのがよさそうです。情報システム部門は、端末に入れるモデルの更新と正答の点検を誰が持つかを先に決めておく必要があるとみています。
- EmbeddingGemma 2は商用利用できる?
- 商用利用できます。GoogleはEmbeddingGemma 2をApache 2.0のライセンスで公開していて、重みはHugging FaceとKaggleから無料で落とせます。処理は端末の中で終わるので、検索する社内ファイルを外部へ送らずに済みます。ただし文章を書く機能は無いので、答えを作るにはGemma 4などの生成AIを別に組み合わせます。
- EmbeddingGemma 2は日本語の検索に使える?
- 使えますが、前の版より良くなったとは言えません。AInformationが10月10日に日本語の社内規程12問で試すと、1位に正しい規程が来たのは10問でした。前の版とOpenAIのtext-embedding-3-smallは11問です。Googleの公表値でも多言語の文字検索は61.4で、jina-embeddings-v5-omni-nanoの65.5に届いていません。
- EmbeddingGemma 2はどれくらいのメモリで動く?
- 量子化した場合のPixel 11 Proでの使用メモリは、文字だけの構成で約191MBです。写真・動画・音声まで含む全機能でも約567MBに収まります。使わない画像用と音声用の部分を外せば、さらに軽くできます。
- EmbeddingGemma 2はGemini Enterpriseで使える?
- 10月10日時点ではまだ使えません。法人向けのGemini Enterprise Agent Platform Model Gardenでの提供は「近日」とだけ案内され、開始日は公表されていません。今すぐ試すなら、Hugging FaceかKaggleから重みを落とします。ブラウザとスマホアプリ「Google AI Edge Gallery」の検索デモでも動きを確かめられます。
この記事の出典
補助資料
- [1]PC Watchこの記事の元にした報道
出典の最終確認日:2026年10月10日